
Apa Itu Gemini 3.8 Flash dan Kenapa Penting untuk Developer
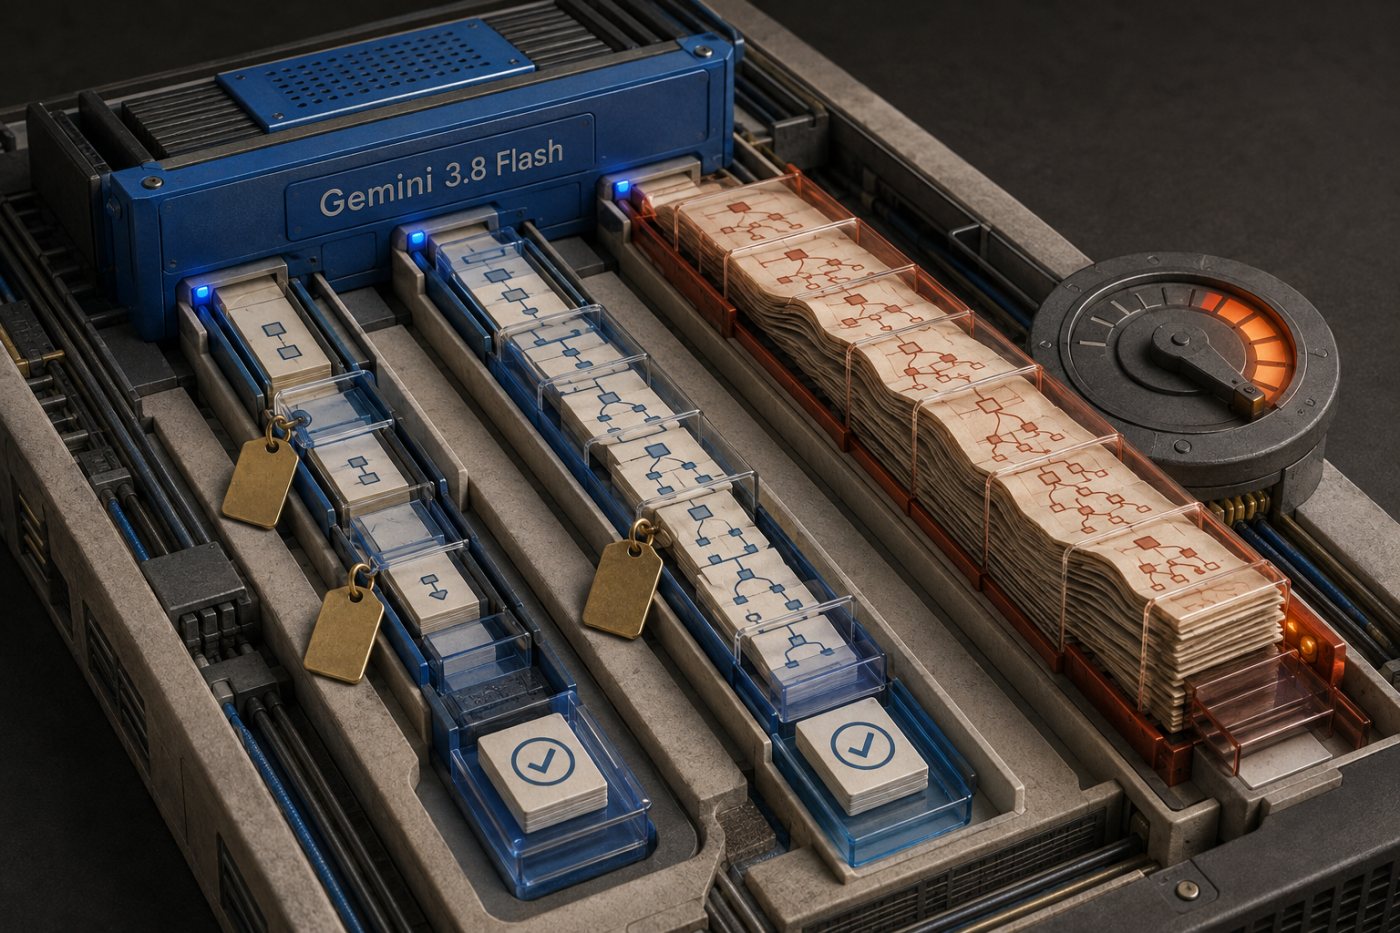
Gemini 3.8 Flash adalah model AI generatif kelas Flash yang dirancang Google untuk rekayasa perangkat lunak jangka panjang, agen otonom AI, dan alur kerja perusahaan kompleks dengan fokus pada kecepatan, konteks besar, serta kemampuan penggunaan alat yang andal. Model ini dirilis secara resmi dan berstatus general availability pada 2 September 2026, menjadi iterasi ketiga seri Flash dalam enam pekan terakhir. Ini bukan sekadar pembaruan kecil: 3.8 Flash adalah pernyataan ambisi Google bahwa model cepat tak harus dikorbankan demi kecerdasan. Dengan kombinasi konteks sekitar satu juta token, dukungan multimodal, dan thinking level yang dapat diatur, 3.8 Flash menargetkan kebutuhan praktis developer yang selama ini terjebak antara model mahal namun “pintar” dan model murah tapi terbatas.
Lompatan Teknis: Dari Skor Terminal-Bench ke Rekayasa Jangka Panjang
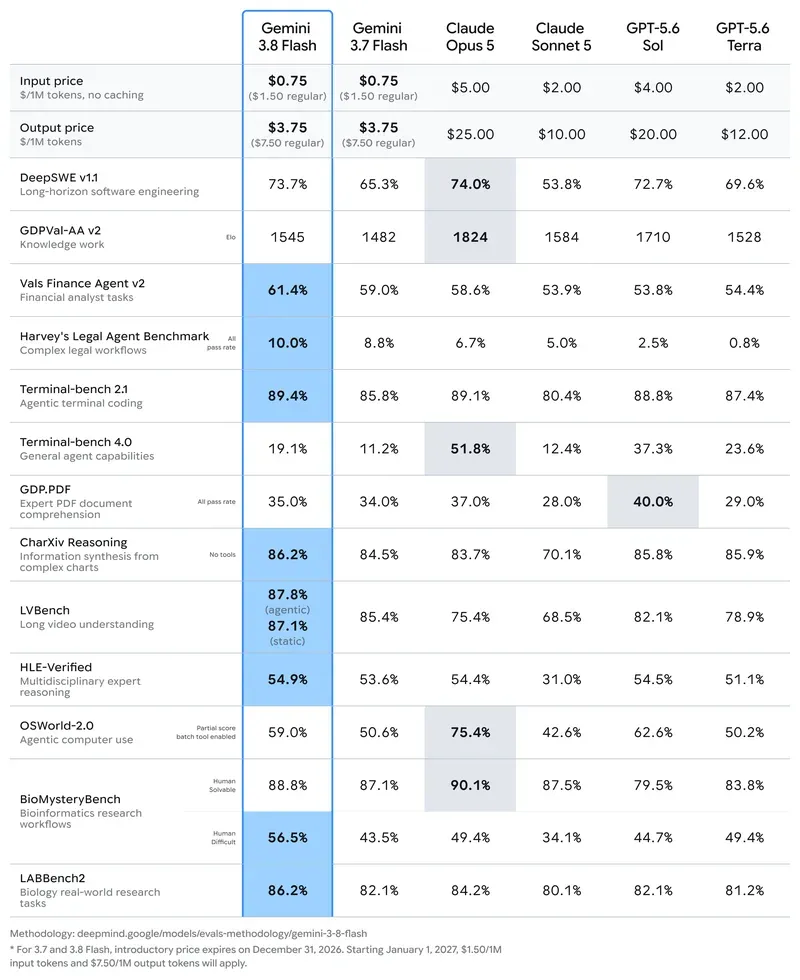
Kekuatan utama Gemini 3.8 Flash adalah peningkatan signifikan pada tugas pengkodean dan penggunaan alat. Model ini mencatat skor 90,8% di Terminal-Bench 2.1, naik tajam dari 81,6% yang diraih Gemini 3.7 Flash. Ini berarti eksekusi perintah terminal, automasi pipeline, dan eksekusi skrip yang dulunya rapuh kini jauh lebih dapat diandalkan. Lebih menarik lagi, pada benchmark DeepSWE v1.1, 3.8 Flash dilaporkan mampu mengungguli banyak model frontier yang lebih besar pada masalah rekayasa perangkat lunak kompleks, namun dengan biaya komputasi yang lebih rendah. Di sinilah posisi unik 3.8 Flash: ia mentarget kelas masalah yang biasanya memerlukan model besar, tetapi tetap berada di kategori Flash yang dirancang untuk latensi rendah. Untuk tim rekayasa, ini membuka ruang baru: eksperimen cepat pada problem sulit tanpa harus mengorbankan anggaran.
Agen Otonom AI: Dari Sekadar Chatbot ke Pekerja Latar Belakang
Gemini 3.8 Flash dibangun dengan agen otonom AI sebagai salah satu fokus utama. Model ini dirancang untuk menjalankan agen yang mengerjakan masalah rekayasa multi-langkah tanpa perlu pengawasan terus-menerus. Artinya, developer dapat membangun worker digital yang: memecah masalah menjadi sub-tugas, memanggil fungsi atau tool internal, menjalankan code execution, lalu mengoreksi diri ketika terjadi error. Dalam praktik, ini bisa berarti agen yang menangani debugging berlapis, patch kecil berulang, atau operasi batch pada repositori besar, sementara engineer fokus pada desain sistem. Menurut dokumentasi API, 3.8 Flash mendukung function calling, structured outputs, code execution, caching, file search, URL context, search grounding, dan Google Maps grounding. Digabung dengan thinking level high, agen dapat menjalankan chain-of-thought yang lebih panjang—dengan konsekuensi konsumsi token yang juga meningkat.
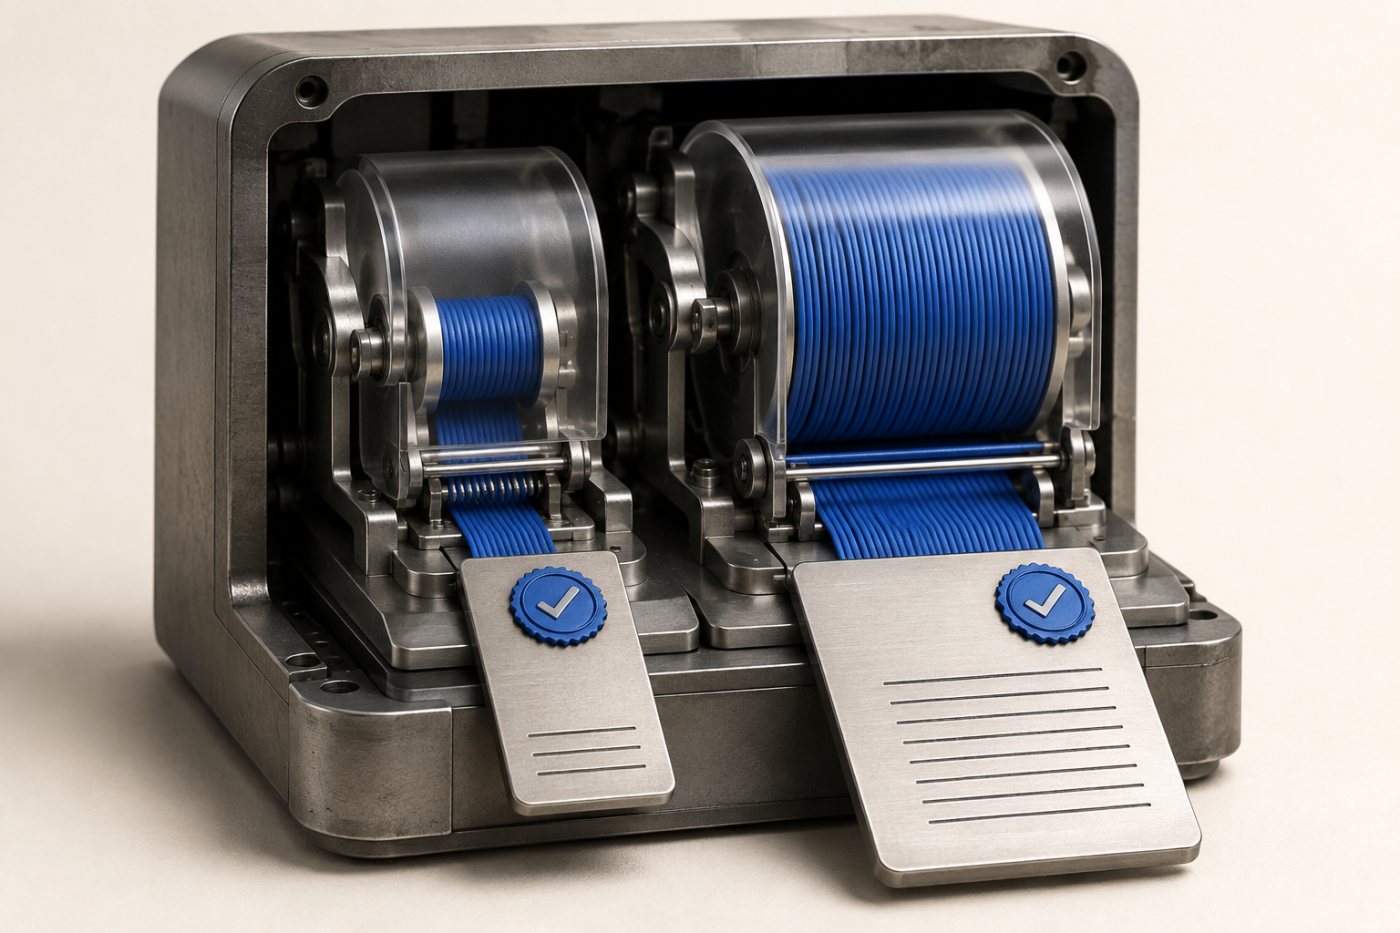
Thinking Level dan Token: Tarif Sama, Tagihan Bisa Berbeda
Gemini 3.8 Flash mempertahankan tarif satuan yang setara dengan 3.7 Flash selama periode perkenalan, namun dengan kemampuan thinking yang lebih dalam dan konteks hingga sekitar satu juta token. Di permukaan, ini terlihat seperti peningkatan gratis. Kenyataannya lebih rumit: effort level low, medium, dan high tidak memiliki pengali token universal. Pada level high, model cenderung melakukan lebih banyak langkah penalaran, pemanggilan alat, dan retry. Untuk tugas debugging kompleks atau alur agen panjang, hasil yang lebih stabil bisa berarti biaya per hasil yang lebih efisien meski token per permintaan meningkat. Sebaliknya, jika tugas sederhana dipaksa berjalan pada effort high, biaya per hasil akan membengkak tanpa manfaat nyata. Intinya: tarif per token yang tetap bukan jaminan biaya tugas yang tetap. Pengembang perlu mengukur metrik biaya per hasil lolos cek, bukan sekadar biaya per permintaan.
Dampak Praktis: Dari Enterprise Workflow ke Pengguna Akhir
Secara operasional, Gemini 3.8 Flash tersedia melalui Gemini API, Google AI Studio, dan Gemini Enterprise Agent Platform, dengan ID model gemini-3.8-flash. Bagi tim rekayasa, ini berarti migrasi dari 3.7 ke 3.8 lebih mirip penggantian mesin di belakang API yang sama, bukan adopsi platform baru. Dukungan input multimodal—teks, gambar, audio, video, dan PDF—memberi peluang alur kerja baru, misalnya agen yang membaca dokumentasi PDF panjang lalu menghasilkan patch atau skrip migrasi. Di sisi pengguna akhir, 3.8 Flash hadir untuk pelanggan Google AI Pro dan Ultra di aplikasi Gemini, AI Mode di Search, dan Gemini di Sheets. Pengaruhnya praktis: penalaran lebih baik, kemampuan pengkodean di produk konsumen, dan otomasi tugas kompleks harian yang sebelumnya memerlukan kombinasi beberapa tool. Kesimpulannya, Gemini 3.8 Flash menempatkan model Flash bukan lagi sebagai “versi hemat”, tetapi sebagai pilihan utama untuk rekayasa perangkat lunak dan agen otonom AI yang serius.