
Gambaran umum: tiga model AI tercepat untuk kebutuhan berbeda
Model AI tercepat adalah model bahasa besar atau multimodal yang mampu menghasilkan atau memproses token dengan laju tinggi sambil menjaga efisiensi biaya token AI, sehingga cocok untuk aplikasi real-time, analisis video, dan agen yang berjalan lama. Dalam fast LLM comparison ini, MiniMax M3.1 Flash, GLM-5.3-Flash, dan MiniCPM-V 4.7 menargetkan kebutuhan berbeda: dua pertama fokus pada teks multimodal di server, sedangkan MiniCPM-V 4.7 fokus pada pembacaan video di perangkat mobile dengan efisiensi tinggi. Secara garis besar, MiniMax M3.1 Flash paling menarik untuk pengembang yang mengejar kecepatan dan biaya per tugas rendah, GLM-5.3-Flash untuk tim yang butuh bobot terbuka dan batas output jelas, dan MiniCPM-V 4.7 untuk produk yang perlu membaca video panjang di ponsel tanpa biaya per menit. Pembaca yang butuh generasi video real-time akan tetap memerlukan model lain yang khusus menulis video.
MiniMax M3.1 Flash vs GLM-5.3-Flash: kecepatan vs fleksibilitas
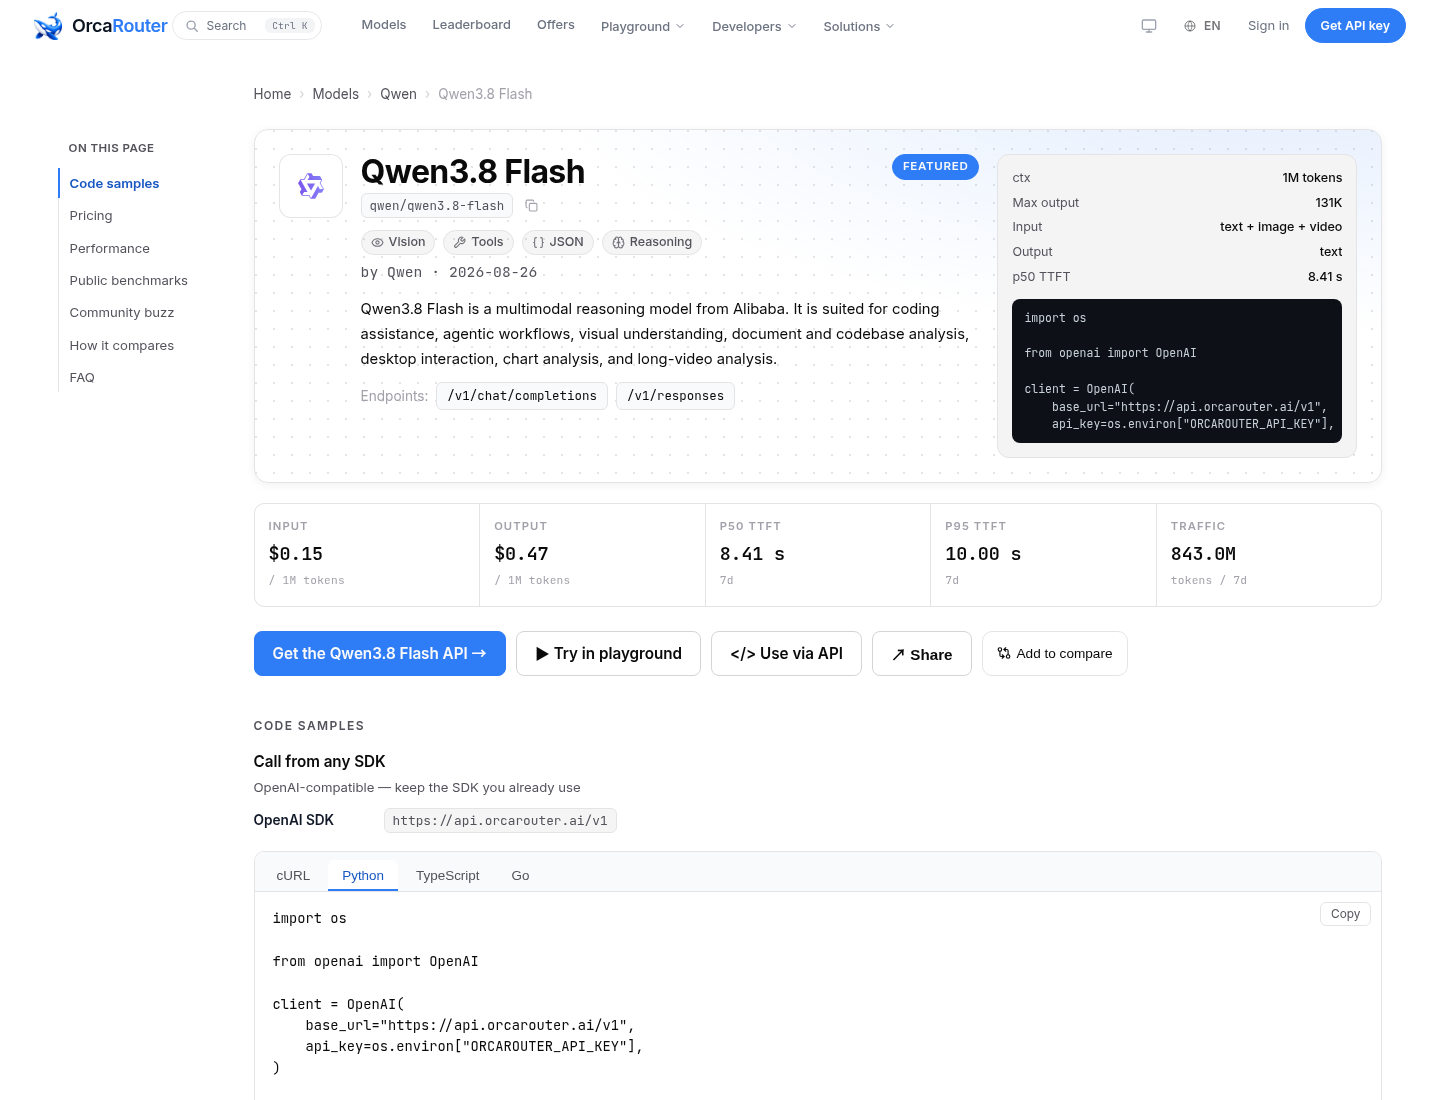
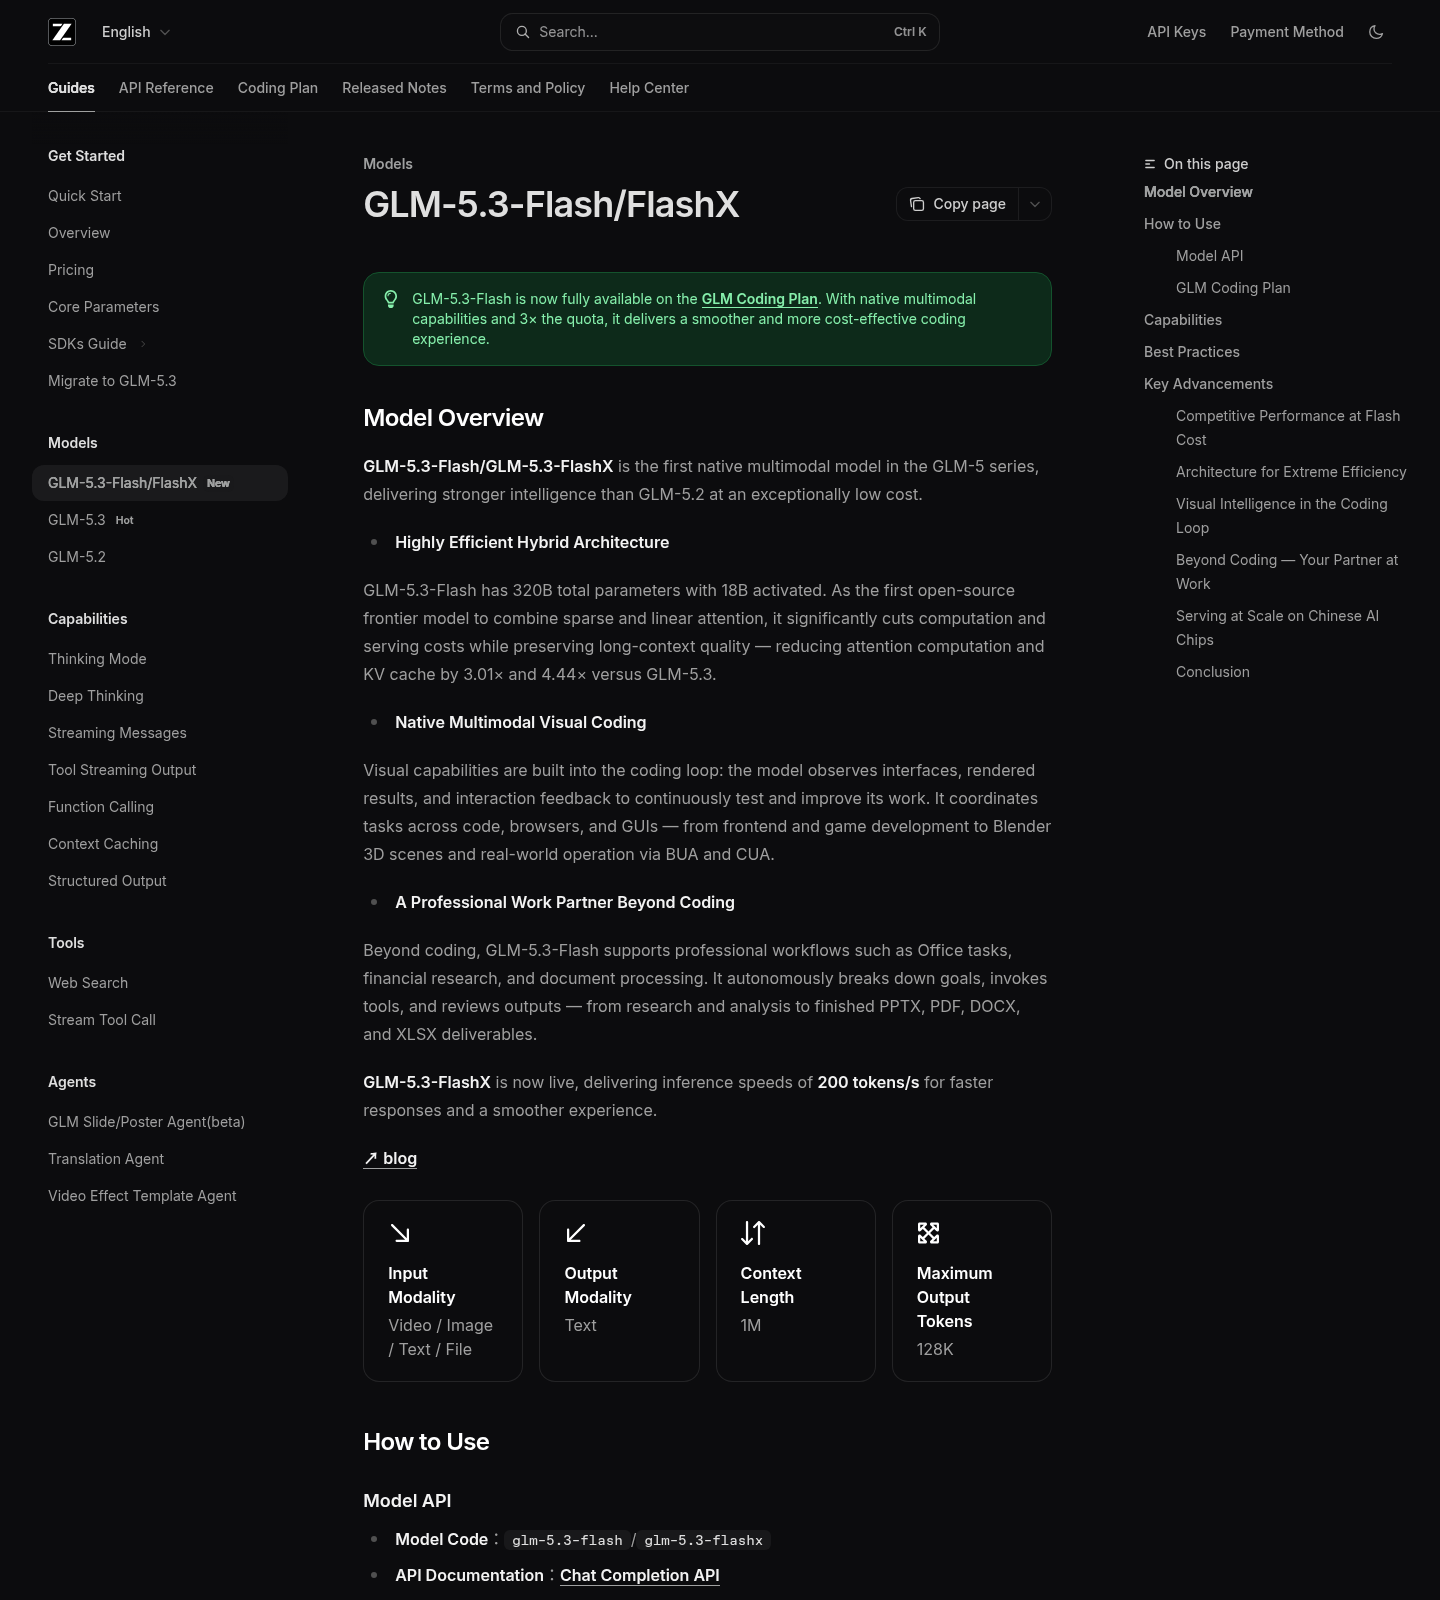
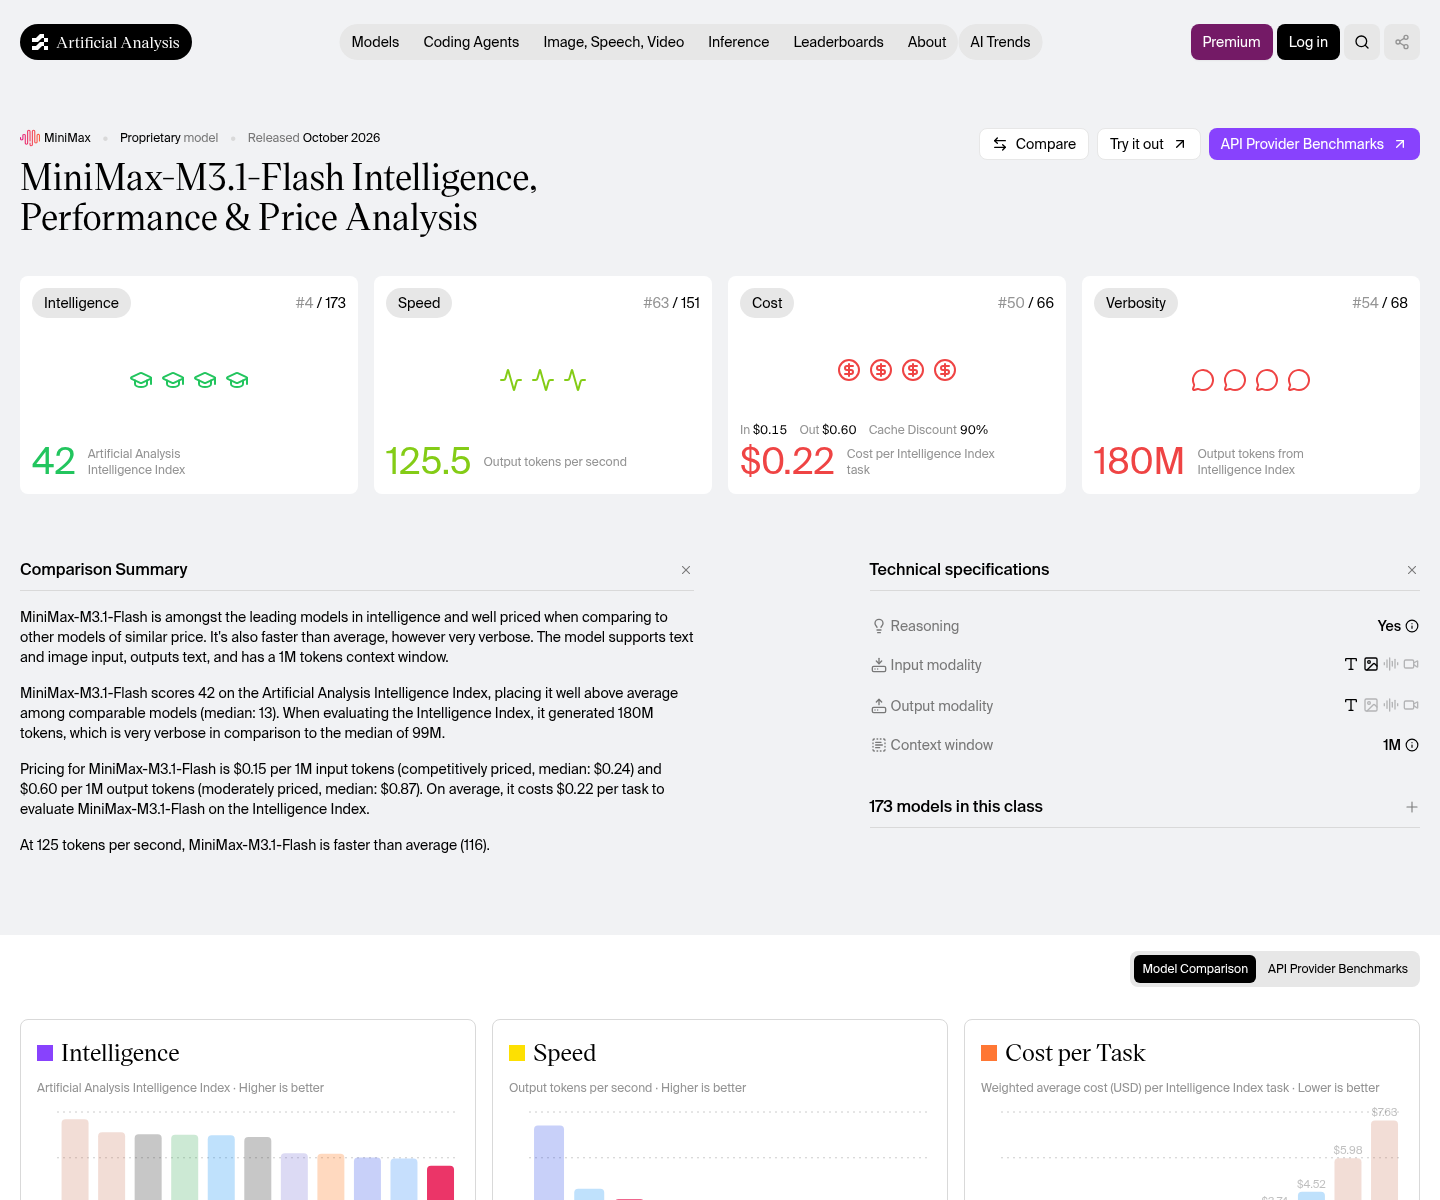
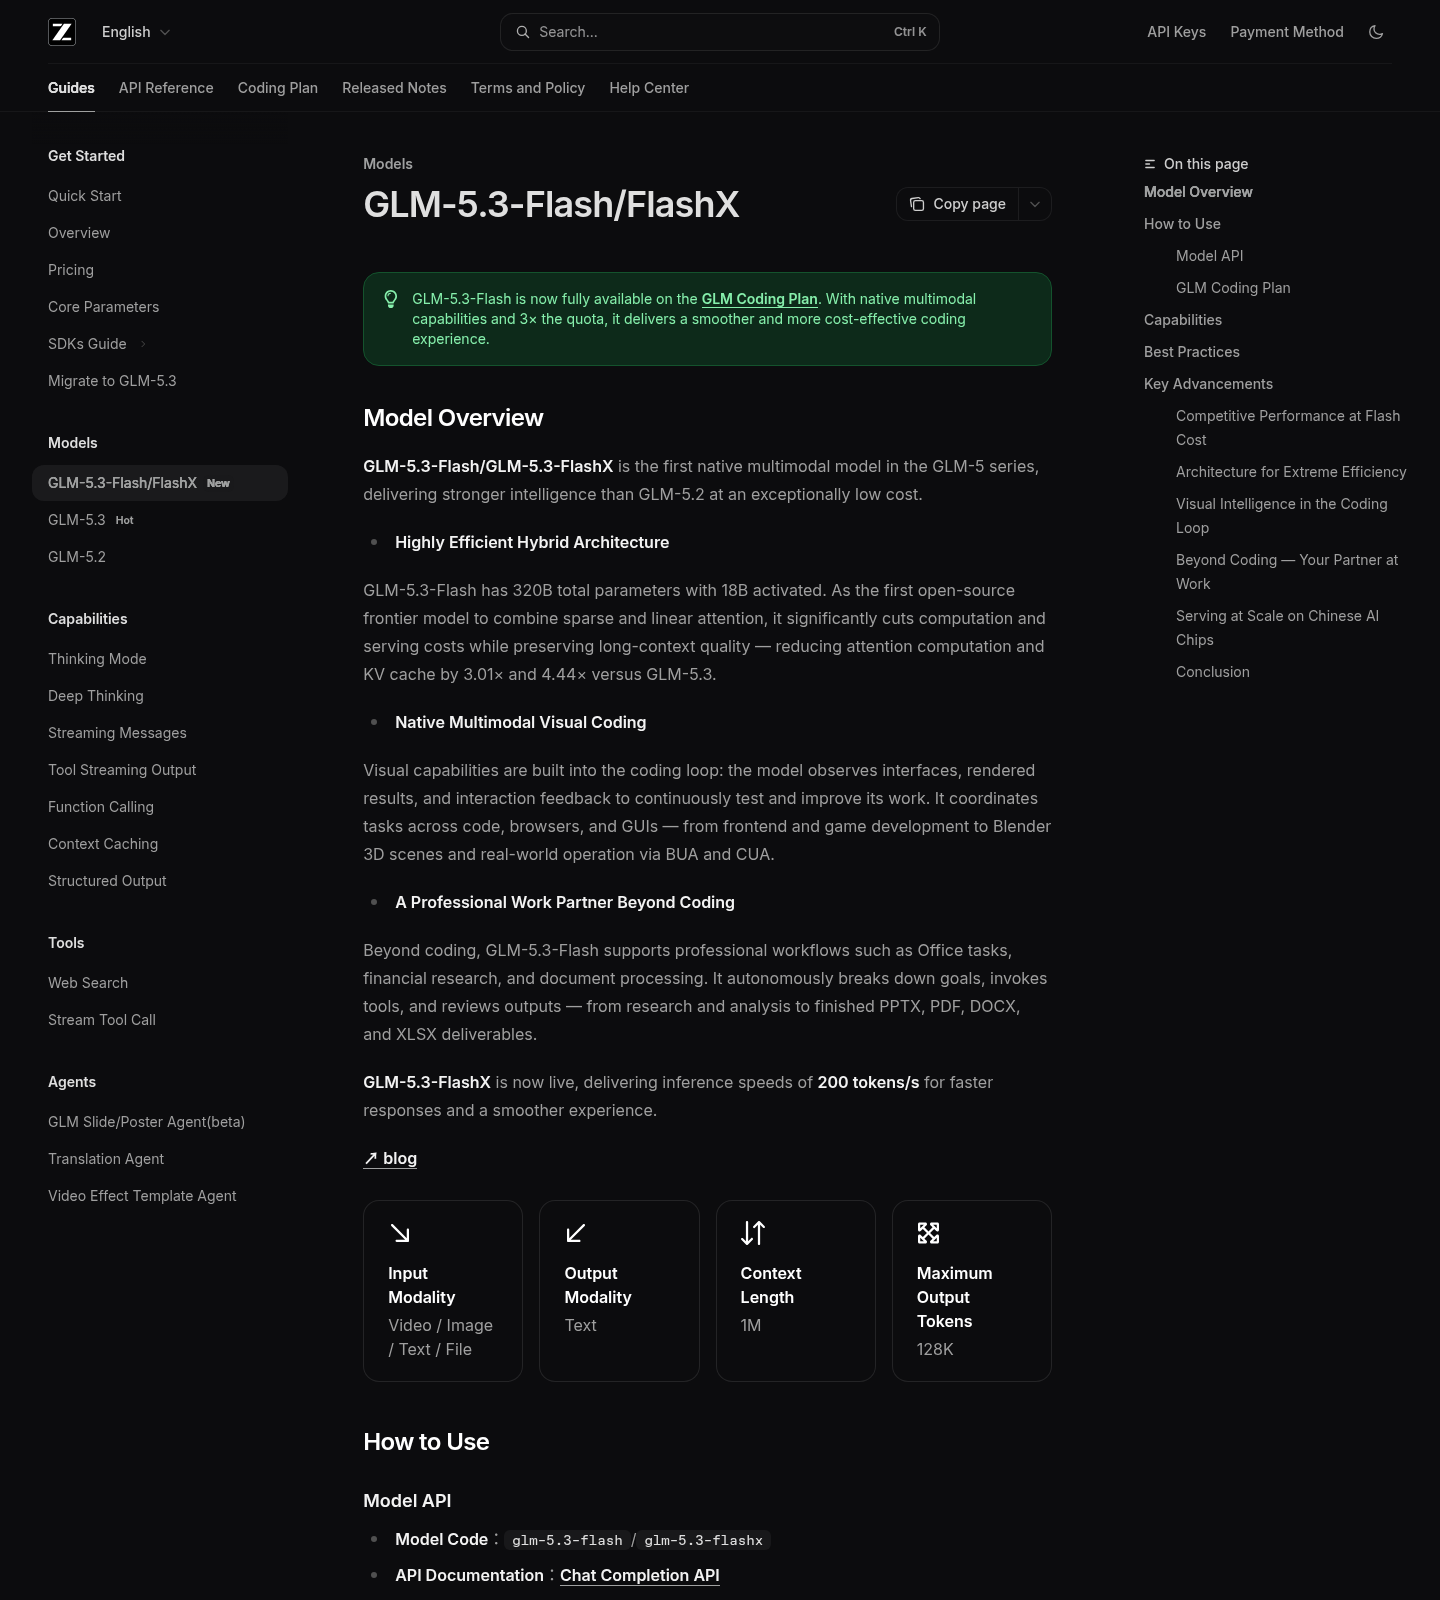
MiniMax M3.1 Flash dan GLM-5.3-Flash sering muncul dalam perbandingan harga model AI karena struktur tarifnya serupa, tetapi keputusan nyata justru ada pada kecepatan, batas, dan lisensi. MiniMax M3.1 Flash mengukur sekitar 105 token per detik dengan waktu hingga token pertama 1,38 detik, sedangkan GLM-5.3-Flash 76,8 token per detik dengan token pertama 2,57 detik; MiniMax sekitar 36% lebih cepat setelah mulai dan sekitar dua kali lebih cepat untuk memulai. Dalam konteks fast LLM comparison, ini menjadikan MiniMax kandidat kuat untuk agen yang harus responsif. Di sisi lain, GLM-5.3-Flash menang di beberapa dimensi: output maksimum 128.000 token, dukungan input file, dan bobot terbuka berlisensi MIT yang dapat diunduh, sementara MiniMax belum merilis bobot dengan lisensi jelas. Keduanya sama-sama menagih token penalaran sebagai output dan tidak menyediakan sakelar untuk mematikan proses berpikir, sehingga tidak ada yang memberi kontrol biaya granular pada reasoning.
| Aspek | MiniMax M3.1 Flash | GLM-5.3-Flash |
|---|---|---|
| Kecepatan output | ≈105 token/detik; token pertama 1,38 dtk | ≈76,8 token/detik; token pertama 2,57 dtk |
| Output maksimum | Tidak dipublikasikan | 128.000 token |
| Modalitas input | Teks, gambar, video | Teks, gambar, video, file |
| Lisensi bobot | Janji rilis tanpa lisensi dan tanpa tanggal | Bobot terbuka, lisensi MIT, dapat diunduh |
| Biaya per tugas indeks | Sekitar 21% lebih murah per tugas dibanding GLM | Lebih tinggi per tugas dibanding MiniMax |
Untuk efisiensi biaya token AI, perbandingan biaya per tugas menunjukkan MiniMax M3.1 Flash sekitar 21% lebih murah per tugas indeks dibanding GLM-5.3-Flash meskipun tarif output per tokennya tampak lebih tinggi. "Perbandingan biaya per tugas lebih berguna daripada perbandingan indeks" karena mencerminkan bagaimana verbositas dan caching memengaruhi tagihan nyata. Namun GLM-5.3-Flash memberi kejelasan operasional: batas output 128.000 token dan dukungan file memudahkan pipeline yang mengandalkan upload dokumen besar. Keduanya berbagi kelemahan: kartu tarif dan tabel benchmark tidak mencantumkan bagaimana model gagal di produksi, sehingga tim perlu memeriksa Arsip Insiden AI untuk memahami risiko kegagalan yang sudah tercatat. Jika Anda butuh model AI tercepat untuk respons singkat dan loop agen, MiniMax lebih masuk akal; jika Anda butuh kontrol penuh melalui bobot terbuka dan output panjang, GLM-5.3-Flash lebih tepat.
MiniCPM-V 4.7 dan Gemini Omni 1.1 Flash: baca video vs tulis video
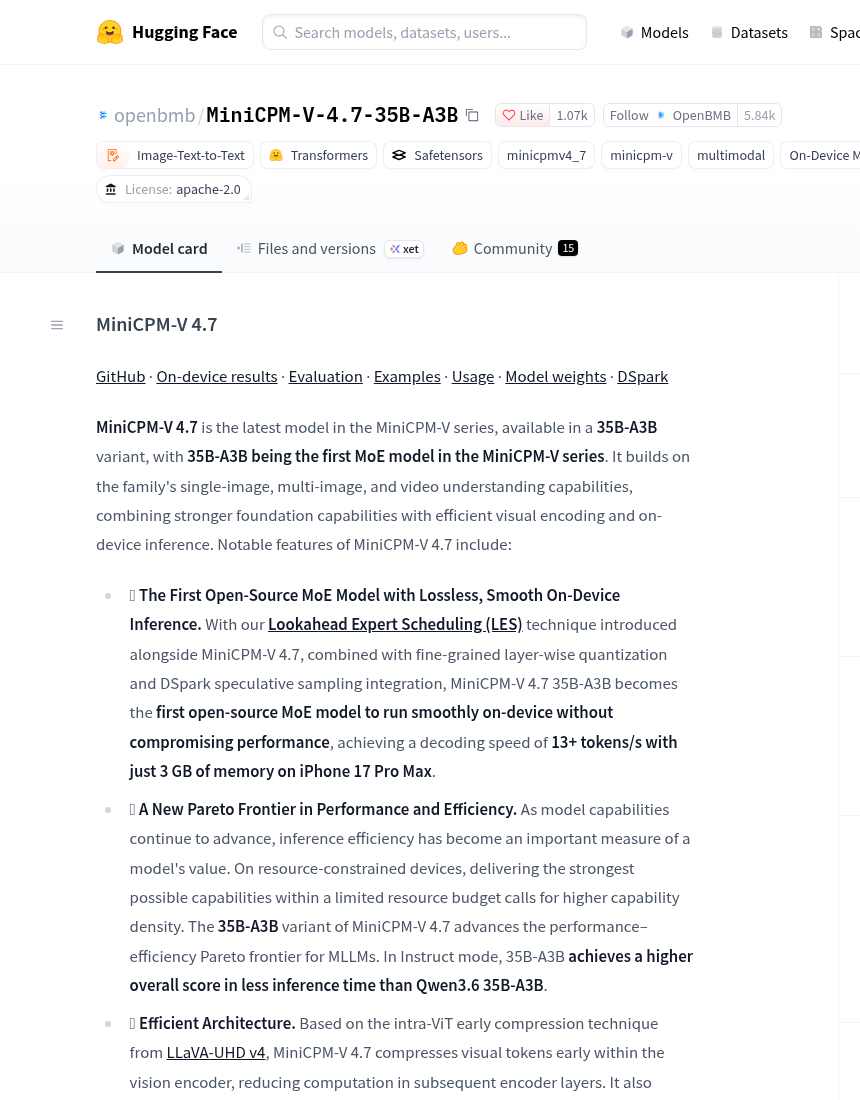
MiniCPM-V 4.7 35B-A3B dan Gemini Omni 1.1 Flash tidak saling menggantikan, tetapi saling melengkapi untuk pipeline video: satu membaca, satu menulis. MiniCPM-V 4.7 adalah model bahasa-visi sparse mixture-of-experts dengan total 35,2 miliar parameter dan sekitar 3 miliar parameter aktif per token, menggunakan menara visi SigLIP2, menerima teks, gambar, multi-gambar, dan video sebagai input, lalu menjawab dalam bentuk teks. Klaim utamanya adalah lebih dari 13 token per detik pada iPhone 17 Pro Max dengan memori sekitar 3 GB, sehingga cocok sebagai pembaca di perangkat mobile dengan efisiensi tinggi. Satu menit video yang diproses setelah model berada di perangkat tidak memakan biaya per menit; satu jam rekaman dapat disampel, diberi keterangan, dan ditelusuri dengan biaya sebesar baterai.
Gemini Omni 1.1 Flash, sebaliknya, adalah model pembuatan dan penyuntingan video yang menghasilkan klip dengan audio native melalui API, dengan input teks, gambar, dan video referensi, serta output hingga 4K. Tarif standar 720p ditagih per detik keluaran, dengan tier draf 360p yang sekitar 60% lebih cepat dan sekitar sepertiga harganya. Satu menit video 720p berarti enam puluh detik tagihan, sedangkan draf 360p untuk menit yang sama sekitar sepertiga biaya, sebelum kemudian dinaikkan ke 720p. Dalam konteks efisiensi biaya token AI, MiniCPM-V 4.7 menggeser biaya ke perangkat keras dan listrik sendiri, sementara Gemini Omni 1.1 Flash menempatkan biaya pada setiap detik video yang dihasilkan. Keduanya juga tercakup dalam Arsip Insiden AI, sehingga tim video perlu memantau insiden yang tercatat dan tingkat keparahannya sebelum memindahkan pipeline ke produksi.
Memilih model: kecepatan, biaya, dan risiko produksi
Jika fokus Anda adalah model AI tercepat untuk teks dan agen, MiniMax M3.1 Flash unggul dengan kecepatan output sekitar 105 token per detik dan waktu token pertama yang hampir dua kali lebih cepat dibanding GLM-5.3-Flash. GLM-5.3-Flash menang di dimensi lain: output maksimum 128.000 token, input file, dan bobot terbuka berlisensi MIT yang dapat diunduh hari ini. MiniCPM-V 4.7 menempati posisi unik: fast LLM comparison di sini bukan soal throughput server, tetapi kemampuan membaca video di ponsel dengan lebih dari 13 token per detik dan biaya yang terbatas pada baterai perangkat. Di sisi lain, Gemini Omni 1.1 Flash adalah pilihan untuk generasi video cepat dengan struktur biaya per detik yang jelas dan tier draf 360p yang lebih murah dan sekitar 60% lebih cepat.
Semua model ini berbagi satu kelemahan: kartu tarif dan tabel benchmark tidak mencantumkan bagaimana mereka gagal di produksi, sehingga tim harus mengacu pada Arsip Insiden AI untuk memahami pola kegagalan dan tingkat keparahan insiden yang sudah tercatat. Selain itu, MiniMax M3.1 Flash dan GLM-5.3-Flash sama-sama memaksa Anda membayar proses berpikir; proses penalaran tidak dapat dimatikan dan token reasoning ditagih sebagai output, sehingga tidak ada sakelar untuk menghemat biaya dengan mematikan reasoning ketika tidak dibutuhkan. Untuk pengambil keputusan praktis, artinya: pilih MiniMax jika prioritas Anda kecepatan dan biaya per tugas rendah, GLM jika Anda butuh bobot terbuka dan output panjang, MiniCPM-V 4.7 jika Anda ingin pembaca video di perangkat, dan Gemini Omni 1.1 Flash jika Anda membutuhkan penulis video dengan struktur biaya per detik yang terkontrol.
Buy if / Skip if
- Buy the MiniMax M3.1 Flash if Anda membutuhkan model AI tercepat untuk agen teks dengan respons cepat dan biaya per tugas yang lebih rendah dibanding GLM-5.3-Flash.
- Skip the MiniMax M3.1 Flash if Anda memerlukan bobot terbuka dengan lisensi jelas atau batas output maksimum yang terdokumentasi untuk kepatuhan internal.
- Buy the GLM