
Gambaran Umum: Tiga Model AI Ringan, Tiga Karakter Berbeda
Model AI ringan adalah model yang dirancang agar cukup kecil dan efisien untuk dijalankan dengan sumber daya terbatas, misalnya di ponsel atau dengan biaya API yang ditekan, sambil tetap mampu memproses teks, gambar, atau video dengan kecepatan yang layak untuk penggunaan harian dan skala produksi. MiniCPM-V 4.7, Gemini Omni 1.1 Flash, MiniMax M3.1 Flash, dan Qwen 3.8 Flash mewakili empat pendekatan berbeda terhadap efisiensi: ada yang fokus pada pemrosesan video di perangkat, ada yang fokus pada generasi video, dan ada yang mengoptimalkan reasoning teks dengan harga input yang sama. Untuk pengguna, pertanyaannya bukan sekadar spesifikasi, tetapi: model mana yang paling hemat untuk skenario nyata seperti analisis video panjang, percakapan intensif, atau aplikasi agen yang terus bernalar di belakang layar.
| Spec | MiniCPM-V 4.7 | Gemini Omni 1.1 Flash |
|---|---|---|
| Jenis model | Bahasa-visi, sparse mixture-of-experts | Model pembuatan & penyuntingan video |
| Modalitas | Teks, gambar, multi-gambar, video masuk; teks keluar | Teks, gambar, video referensi masuk; video dengan audio keluar |
| Parameter total | 35,2 miliar; ~3 miliar aktif per token | Tidak dipublikasikan secara rinci |
| Lisensi / akses | Bobot dapat diunduh, lisensi Apache-2.0 | Hanya melalui API terhosting, tanpa bobot |
| Profil latensi | >13 token/detik di iPhone 17 Pro Max dengan ~3 GB memori | Rendering per detik, dengan tier draf 360p lebih cepat |
MiniCPM-V 4.7: Pembaca Video Hemat Biaya untuk Di Perangkat
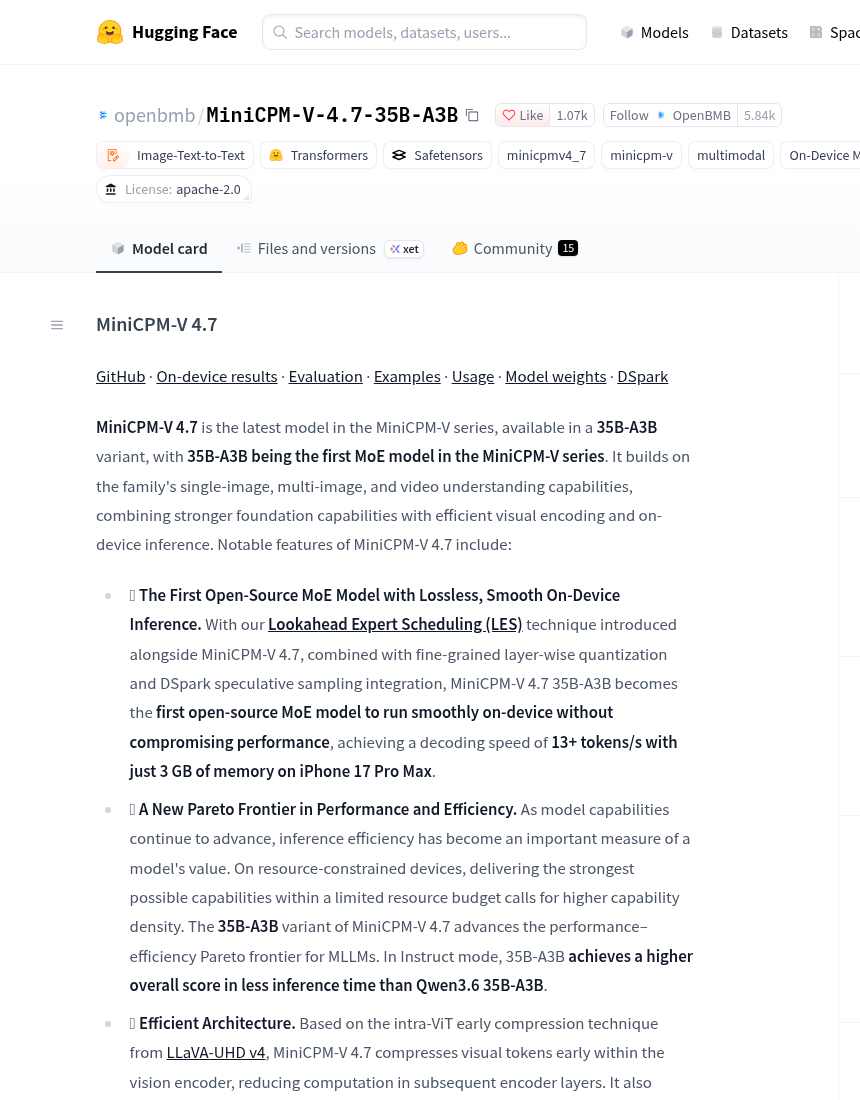
MiniCPM-V 4.7 adalah model bahasa-visi sparse mixture-of-experts dengan total 35,2 miliar parameter dan sekitar 3 miliar parameter aktif per token, dilengkapi menara visi berbasis SigLIP2 serta kompresi token visual campuran 4x/16x. Dalam praktik, ini berarti MiniCPM-V 4.7 mampu melakukan MiniCPM video processing yang cukup efisien: ia menerima teks, gambar, multi-gambar, dan video sebagai input, lalu menjawab dalam bentuk teks. Keungguhan utamanya untuk model AI ringan adalah klaim kecepatan lebih dari 13 token per detik di iPhone 17 Pro Max dengan memori sekitar 3 GB, sehingga satu menit video dapat diproses di ponsel tanpa biaya per detik setelah model terpasang di perangkat. "Satu jam rekaman dapat disampel, diberi keterangan, dan ditelusuri dengan biaya sebesar baterai" adalah gambaran paling jelas tentang efisiensi biaya MiniCPM-V 4.7.
Gemini Omni 1.1 Flash: Penulis Video dengan Struktur Biaya Berbeda
Gemini Omni 1.1 Flash bukan pengganti MiniCPM-V 4.7, melainkan pasangan yang melengkapi: jika MiniCPM membaca video, Gemini Flash menulisnya. Model ini dideskripsikan sebagai model pembuatan video cepat, penyuntingan, interpolasi keyframe, dan perpanjangan adegan dengan audio native, serta saat ini tercatat sebagai stabil, bukan pratinjau. Modalitasnya jelas: teks, gambar, dan video referensi masuk, lalu video dengan audio tersinkronisasi keluar. Perbandingan harga API di sini bukan soal angka mata uang, tetapi soal struktur: Gemini Flash menagih per detik keluaran video, sehingga cocok untuk use case tertentu seperti kampanye pemasaran terukur, konten pendek, atau prototipe visual yang tidak terus-menerus dirender. Kelemahannya untuk tim yang sensitif terhadap kontrol versi adalah ketentuan API yang tidak menjamin stabilitas jangka panjang; model yang dihosting dapat diarahkan ulang, dihentikan, diubah harganya, atau dipindahkan ke tingkat layanan baru, dan satu-satunya kontrol versi yang Anda miliki adalah string ID model.

MiniMax M3.1 Flash vs Qwen 3.8 Flash: Reasoning Cepat vs Jawaban Ringkas
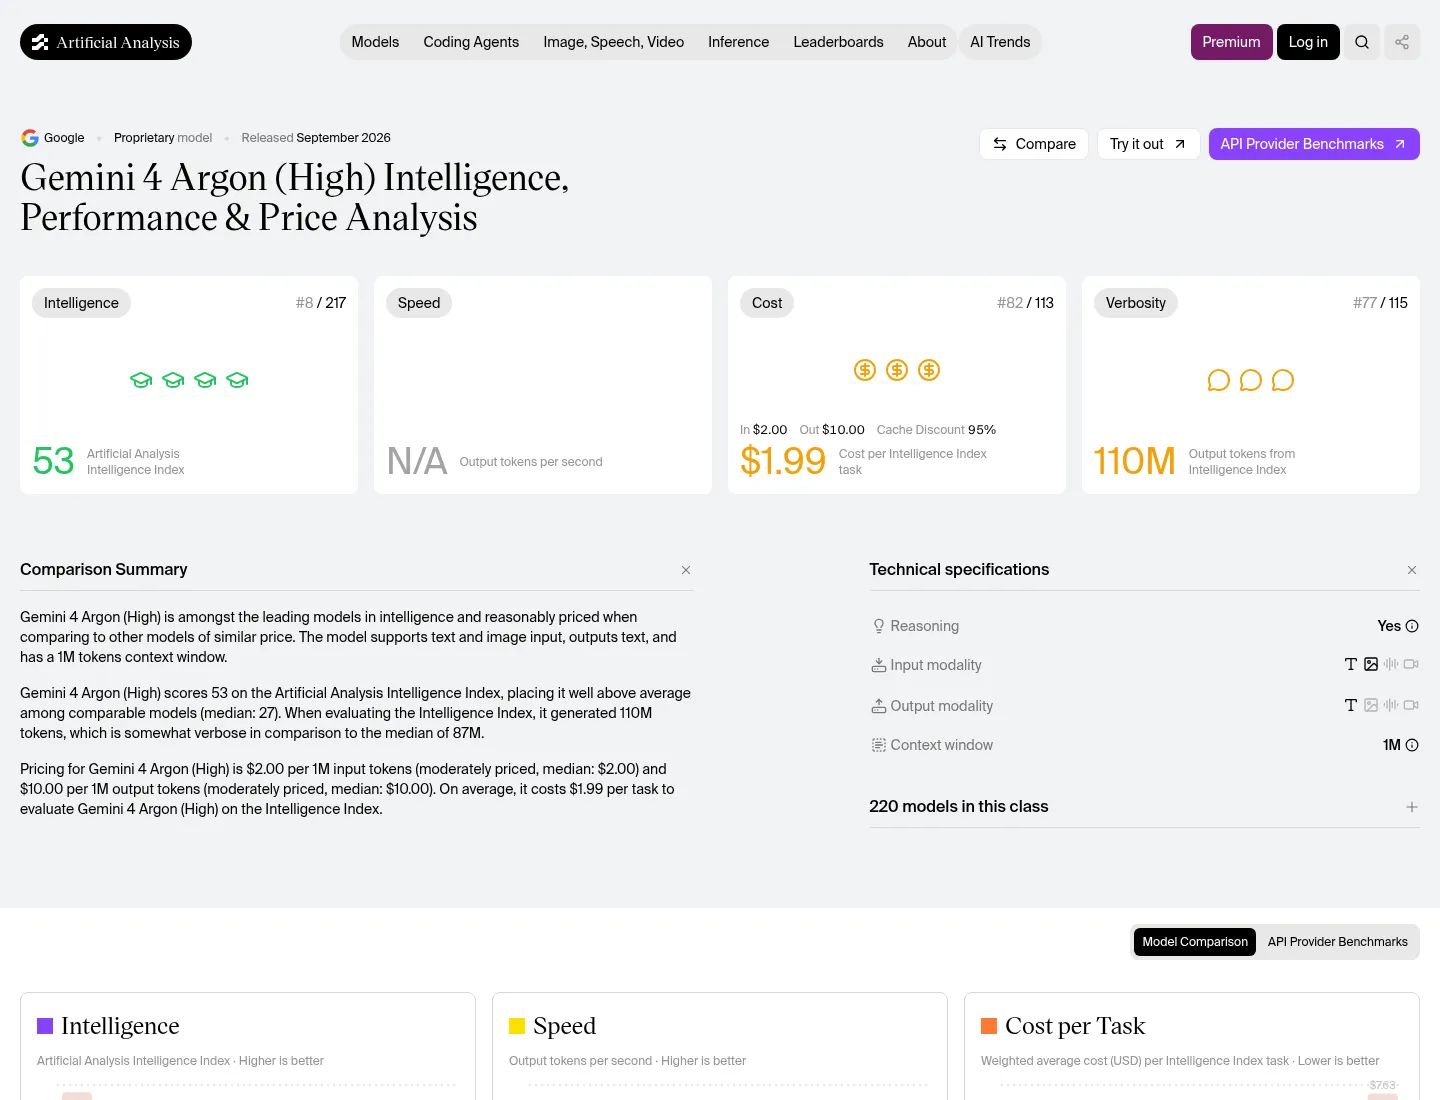
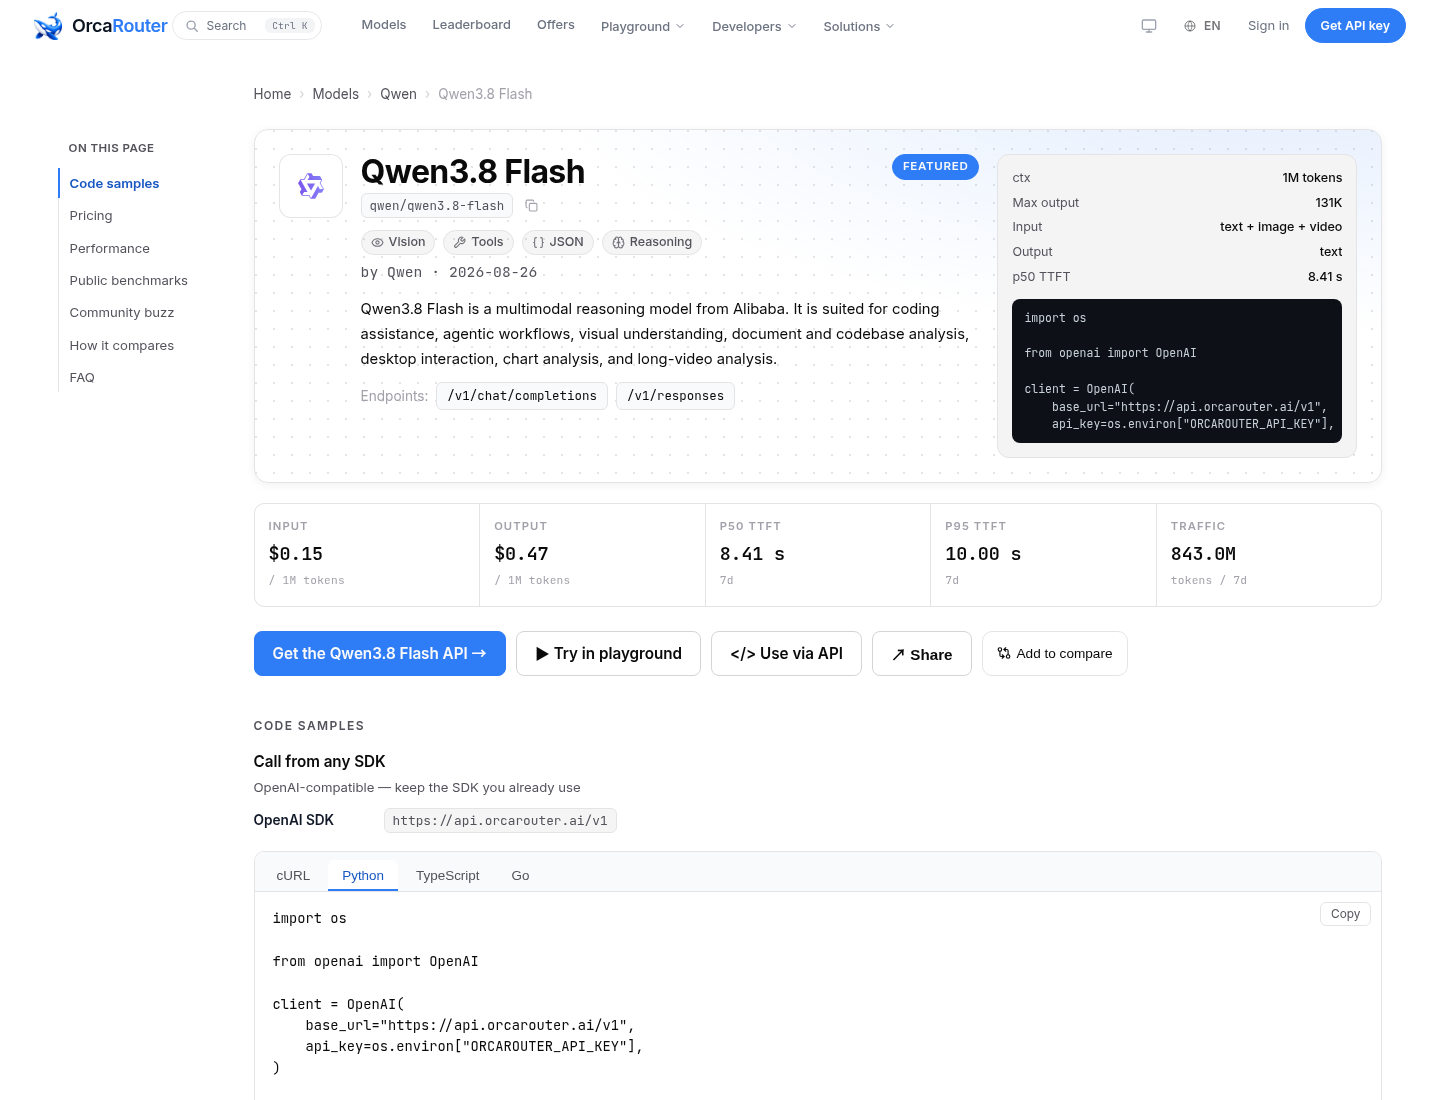
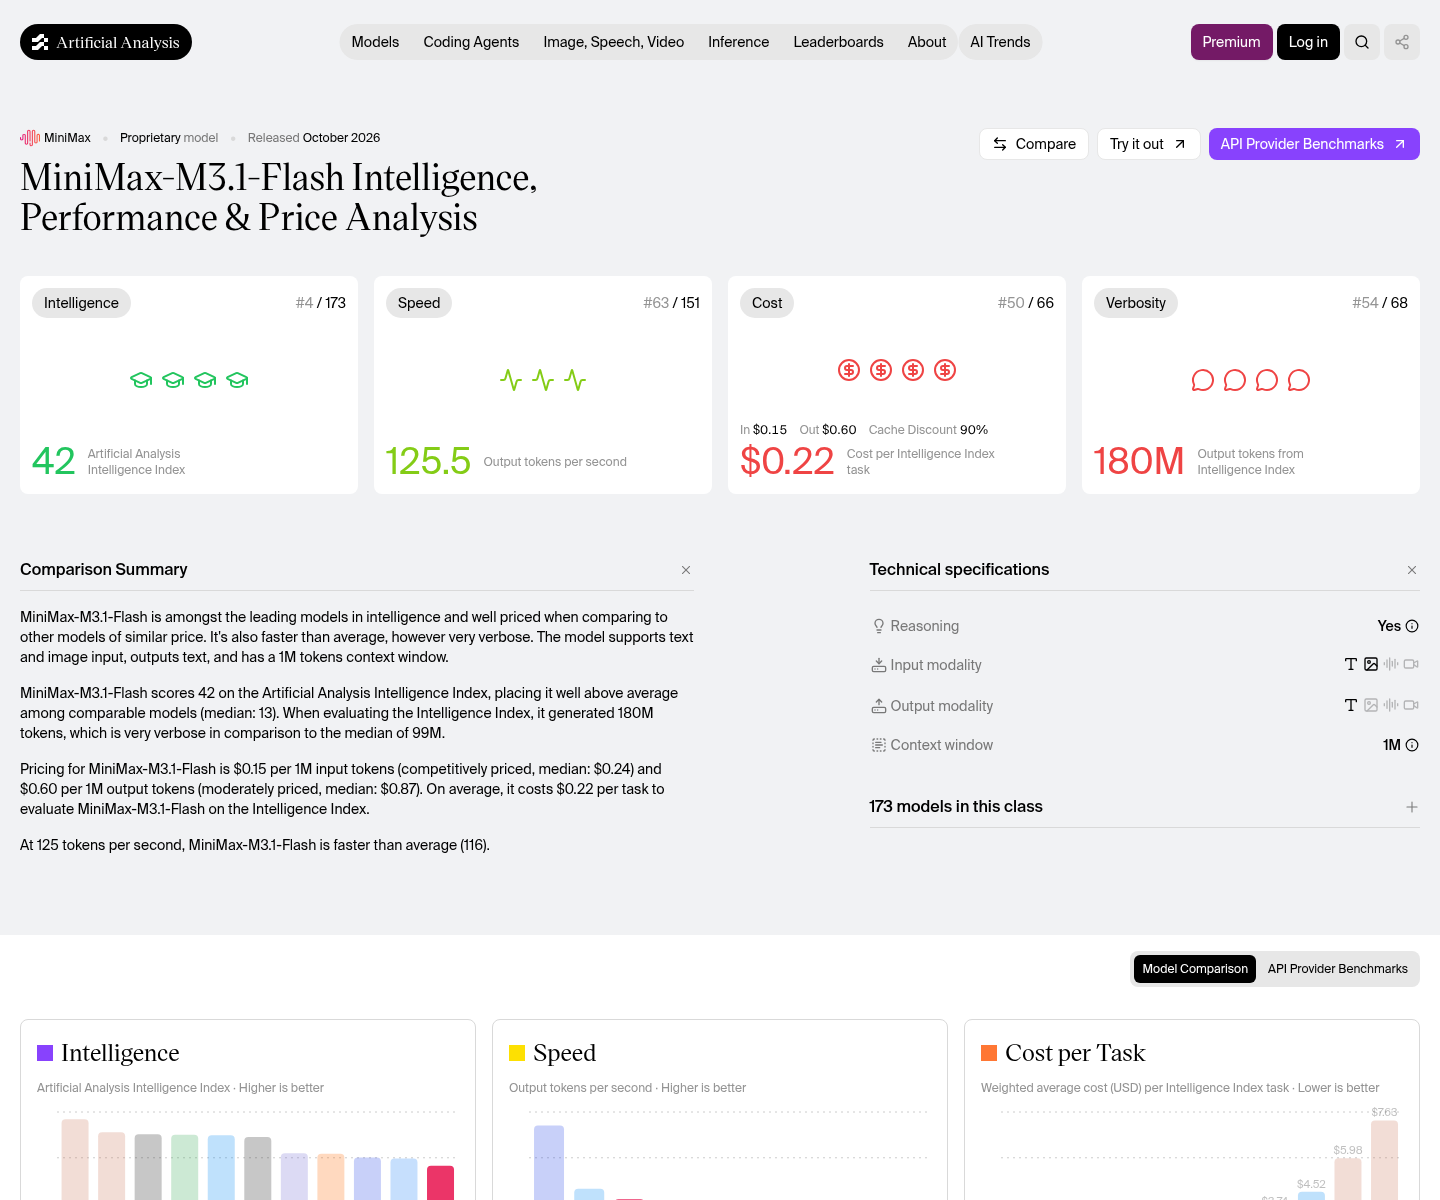
MiniMax-M3.1-Flash dan Qwen3.8-Flash adalah dua model AI ringan untuk teks dengan perbandingan harga API yang menarik: keduanya memiliki biaya input yang sama, namun dibangun di atas teori berbeda tentang ke mana biaya itu dialokasikan. MiniMax-M3.1-Flash adalah model tertutup yang bernalar pada setiap panggilan, menghasilkan sekitar 125,5 token per detik dan waktu hingga token pertama 1,04 detik. Qwen3.8-Flash adalah campuran pakar dengan 125 miliar parameter, sekitar 6 miliar parameter aktif per token, dan sekitar 95% sparsitas, menghasilkan sekitar 51,6 token per detik pada checkpoint yang diukur secara independen. "Satu cepat dan bertele-tele; yang lain lambat dan ringkas" merangkum trade-off inti di antara keduanya. Qwen menjual arsitektur yang secara prinsip dapat Anda hosting, sementara MiniMax menjual layanan; Qwen3.8-Flash sendiri adalah produk yang dihosting, sedangkan yang dapat diunduh adalah Qwen3.8-Flash-Next yang berbagi arsitektur tetapi tidak berbagi nama, lisensi, atau belum tentu perilakunya.
Panduan Praktis Memilih: Video, Reasoning, dan Biaya
Untuk pemrosesan video intensif, MiniCPM-V 4.7 unggul karena setelah bobot diunduh (sekitar 21,2 GB untuk format tertentu) biaya operasional utamanya adalah perangkat keras dan listrik. Skema kompresi 16x token untuk struktur dan 4x saat detail penting membuatnya cukup murah untuk dijalankan pada setiap klip alih-alih sampel. Kelemahannya adalah grounding yang masih lemah: upstream integrasi tertentu mulai menetapkan posisi yang salah ke token penanda gambar, sehingga koordinat yang dikembalikan bergeser sistematis ke bawah saat Anda menanyakan lokasi objek. Untuk generasi video, Gemini Flash lebih cocok, tetapi Anda harus menerima ketidakpastian layanan terhosting jangka panjang. Di ranah teks, MiniMax M3.1 Flash lebih tepat untuk aplikasi agen yang perlu reasoning cepat dan panjang, sementara Qwen 3.8 Flash lebih ekonomis jika Anda mengutamakan jawaban ringkas dan memanfaatkan desain mixture-of-experts dengan prediksi multi-token yang membuatnya tetap dapat digunakan meski sangat sparse.
- Buy the MiniCPM-V 4.7 if Anda ingin memproses banyak video di ponsel atau on-prem tanpa biaya per detik dan siap mengelola unduhan model besar.
- Skip the MiniCPM-V 4.7 if aplikasi Anda bergantung pada koordinat objek yang sangat presisi dalam gambar atau video, karena grounding masih menjadi titik lemah.
- Buy the Gemini Omni 1.1 Flash if fokus Anda adalah pembuatan dan penyuntingan video dengan audio native untuk klip pendek dan kampanye kreatif terukur.
- Skip the Gemini Omni 1.1 Flash if Anda membutuhkan kontrol penuh atas versi model dan takut pada perubahan layanan mendadak di API terhosting.
- Buy the MiniMax M3.1 Flash if Anda membangun agen teks yang harus bernalar cepat dengan konteks panjang dan tidak masalah jika jawaban cenderung bertele-tele.
- Skip the MiniMax M3.1 Flash if Anda mengutamakan jawaban singkat dan ingin menekan biaya keluaran teks.
- Buy the Qwen 3.8 Flash if Anda mencari model teks ringkas dengan arsitektur mixture-of-experts yang efisien dan opsi hosting yang lebih terbuka.
- Skip the Qwen 3.8 Flash if Anda membutuhkan kecepatan keluaran maksimal per detik dan tidak ingin menunggu reasoning yang lebih lambat.