
Ringkasan: pilih sesuai beban kerja
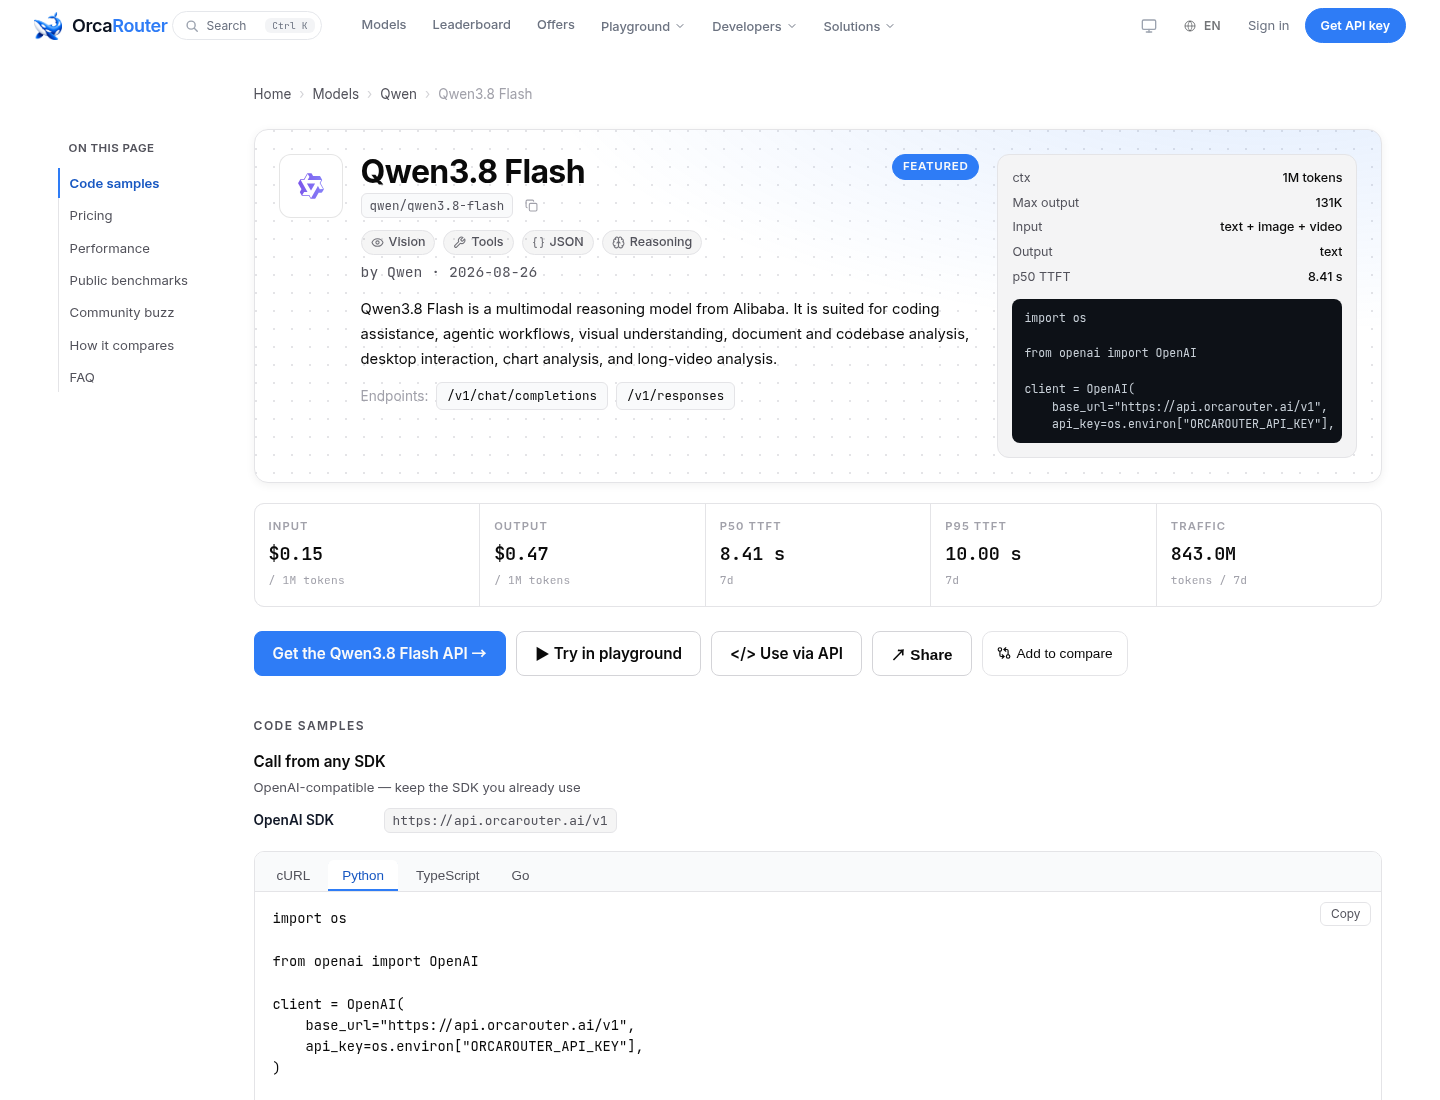
Model AI flash adalah model yang dirancang untuk menyelesaikan permintaan dengan cepat dan efisien, tetapi kemampuan, laju keluaran, serta kebutuhan pengelolaannya berbeda-beda. Untuk developer yang mengejar biaya pemakaian rendah, Qwen3.8 Flash dan MiniMax M3.1 Flash menjadi pilihan utama; MiniMax tercatat menghasilkan token lebih cepat, sedangkan Qwen menawarkan keluaran yang lebih hemat. Gemini 3.8 Flash lebih cocok bagi tim yang membutuhkan model terkelola untuk pekerjaan agen jangka panjang dan bersedia membayar kelas layanan yang lebih premium. Jadi, tidak ada pemenang mutlak dalam perbandingan harga API ini: pilihan terbaik bergantung pada biaya per token keluaran, kecepatan reasoning AI, dan seberapa banyak infrastruktur yang ingin Anda urus sendiri. Perlu diperhatikan, angka laju Qwen yang tersedia berasal dari checkpoint Flash-Next, bukan pengukuran langsung layanan Qwen3.8 Flash yang dihosting.
Spesifikasi yang berpengaruh pada pilihan
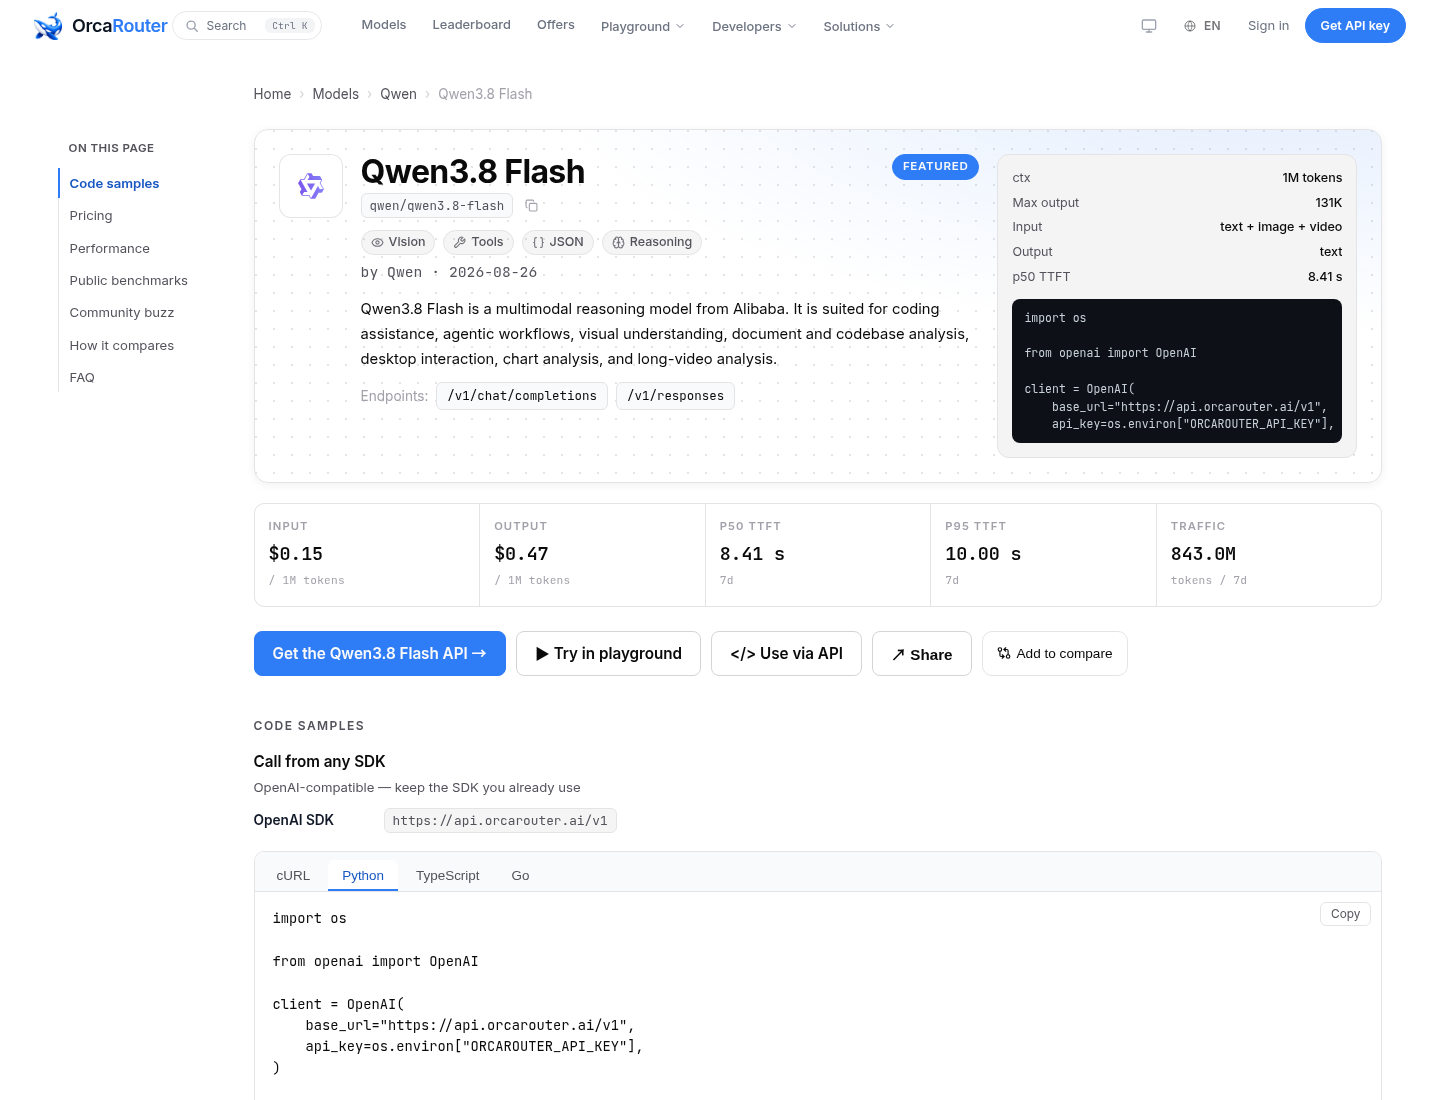
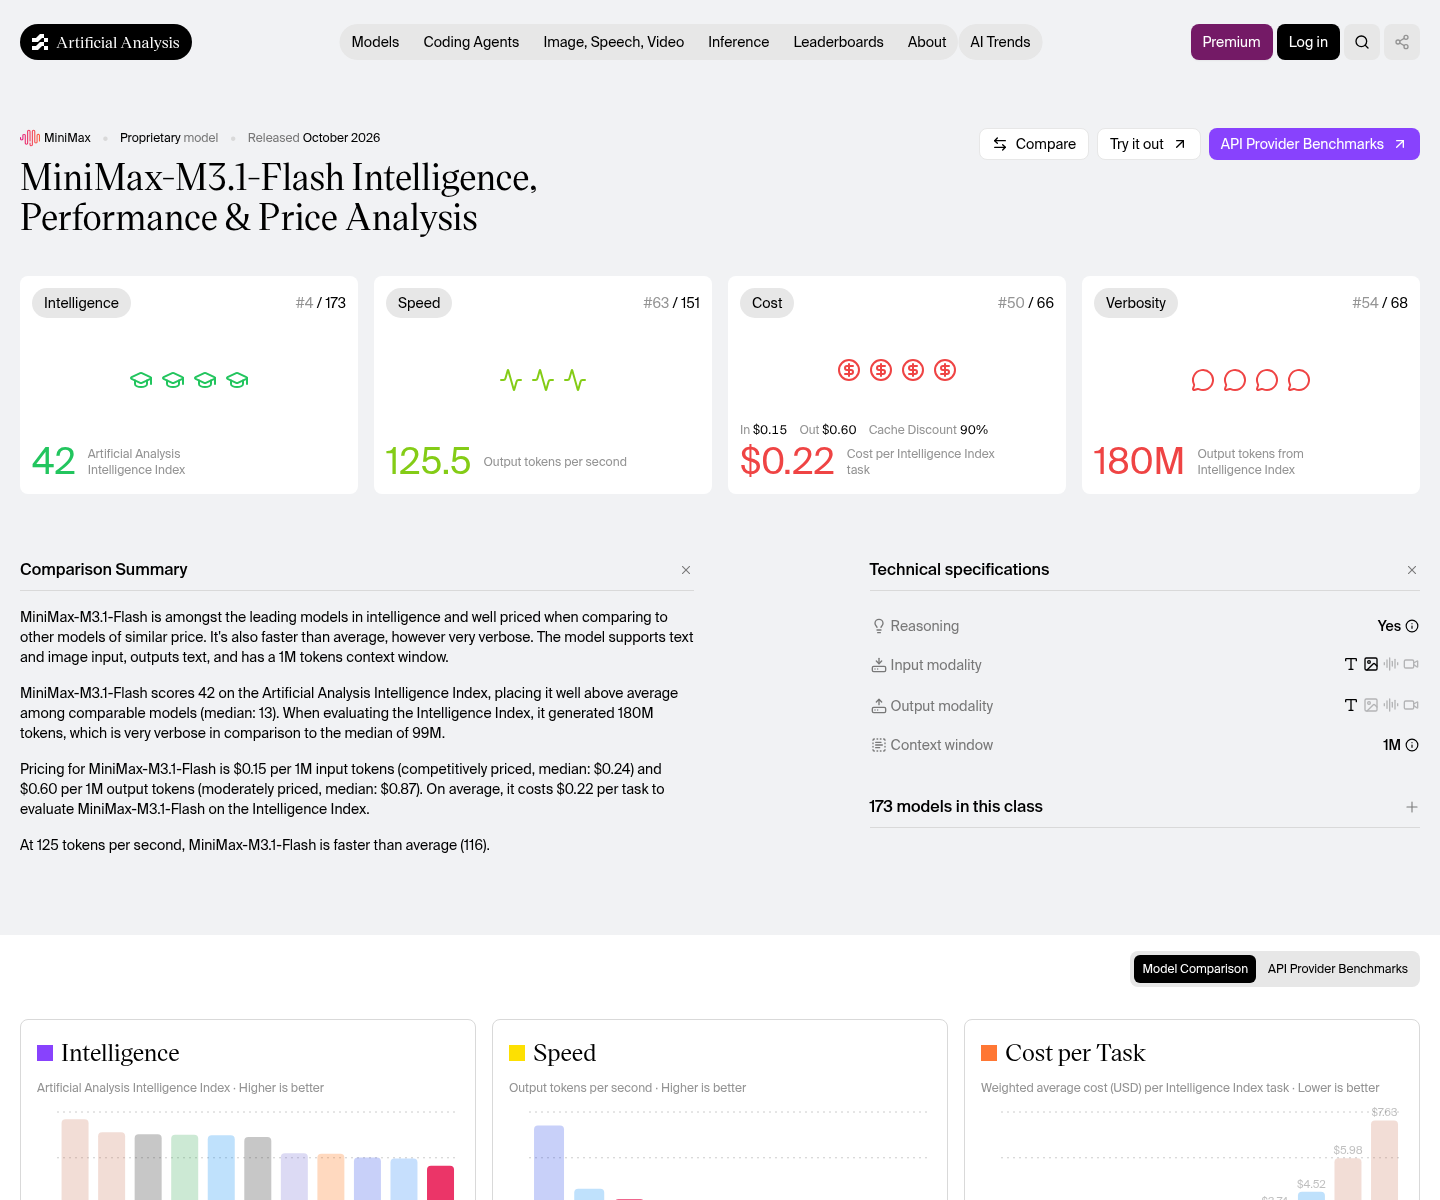
Perbedaan paling terasa ada pada laju keluaran yang terukur dan jenis layanan yang didapat. MiniMax unggul pada angka token per detik yang tersedia, sedangkan Qwen lebih hemat untuk token keluaran. Gemini menawarkan jendela konteks panjang dan masukan multimodal yang luas, tetapi data kecepatannya tidak tersedia pada bahan perbandingan ini. Perbandingan kecepatan Qwen dan MiniMax juga perlu dibaca hati-hati: angka Qwen mengacu pada Flash-Next, sementara angka MiniMax mengacu pada model yang dibandingkan. Tabel merangkum spesifikasi yang dapat ditelusuri tanpa menyamakan pengukuran yang tidak sepadan.
| Aspek | Qwen3.8 Flash | MiniMax M3.1 Flash | Gemini 3.8 Flash |
|---|---|---|---|
| Laju keluaran terukur | Sekitar 51,6 token/detik pada checkpoint Flash-Next | 125,5 token/detik | Tidak tersedia dalam sumber |
| Konteks | Hingga 1 juta token | 1 juta token | 1 juta token |
| Batas keluaran | Hingga 131.000 token | Tidak dirinci dalam sumber | Hingga 65.536 token |
| Jenis layanan | Model yang dihosting; Flash-Next tersedia sebagai checkpoint terpisah | Model tertutup dan terhosting | Model tertutup dan terkelola |
| Masukan yang disebutkan | Teks, gambar, dan video | Tidak dirinci dalam sumber | Teks, gambar, audio, video, dan PDF |
Biaya, penalaran, dan beban pengelolaan
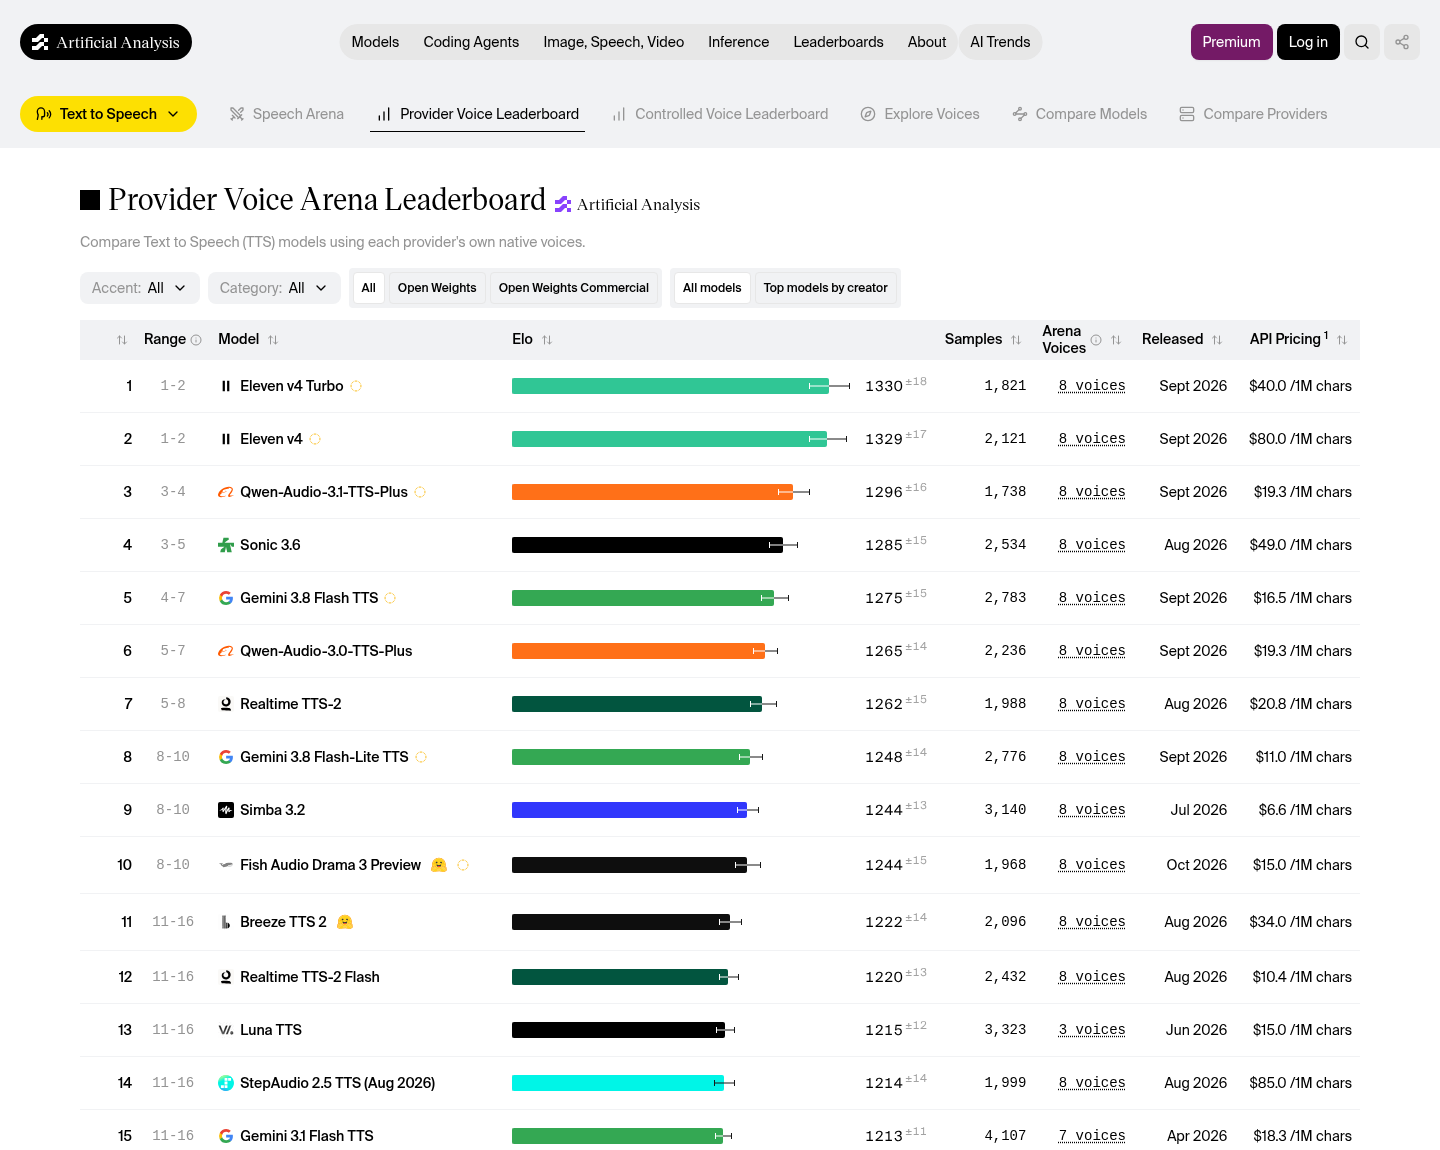
Dalam Qwen vs MiniMax, kesamaan kelas biaya masukan tidak berarti tagihan akhir selalu sama. Qwen memiliki biaya token keluaran yang lebih rendah, sedangkan MiniMax dapat menarik bagi sistem yang mengutamakan respons cepat dan menerima keluaran yang lebih mahal. Gemini berada di kelas premium, tetapi nilai tambahnya adalah layanan agen terkelola yang dirancang untuk pekerjaan berjalan lama; Qwen dan MiniMax tidak menawarkan fitur itu dalam informasi yang tersedia. Untuk mutu penalaran, data benchmark yang dipublikasikan belum sepenuhnya sebanding. Artificial Analysis mencatat indeks Qwen3.8-Flash-Next sebesar 40, sementara Gemini 3.8 Flash memperoleh 59 pada upaya penalar