
Ringkasan: biaya tetap atau kemampuan Gemini
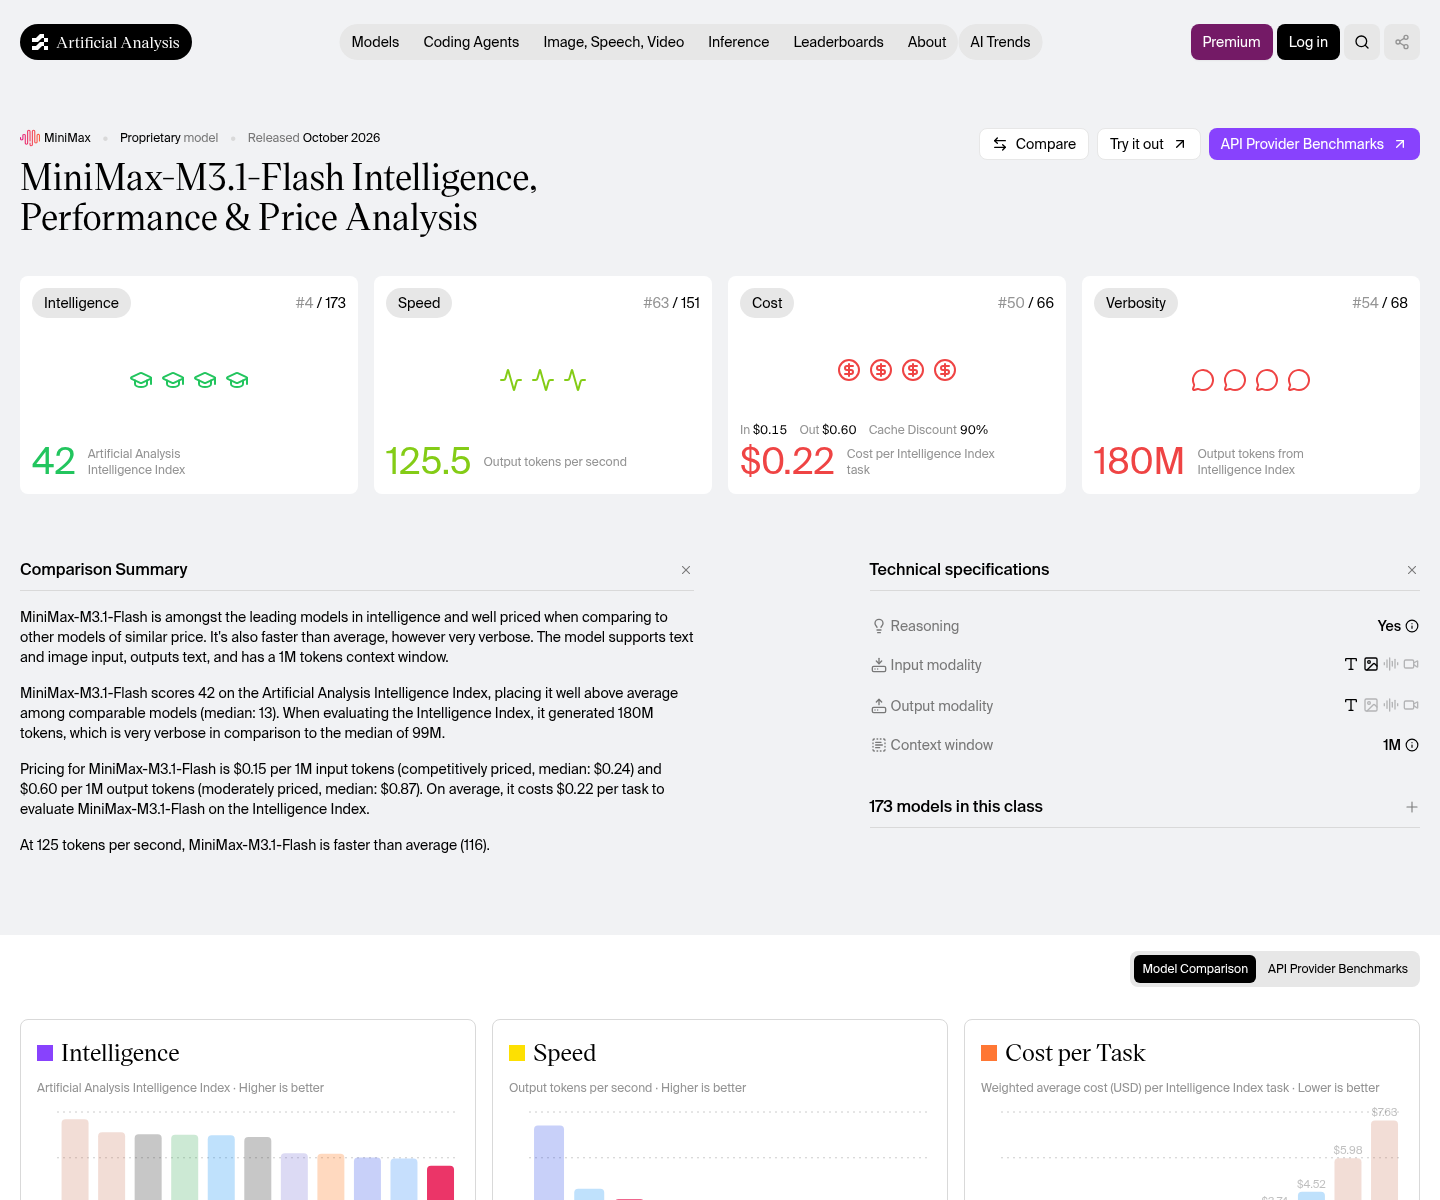
MiniMax M3.1 Flash dan Gemini 3.8 Flash adalah model AI yang bersaing untuk beban kerja berbasis API, tetapi menawarkan strategi biaya dan kapasitas keluaran yang berbeda bagi developer dan bisnis. Untuk aplikasi yang mengejar biaya operasional terprediksi dan jawaban panjang, MiniMax lebih mudah dijadikan pilihan utama. Gemini lebih layak dipertimbangkan bila tim sudah mengandalkan ekosistemnya atau memiliki alasan terukur untuk memilihnya, dengan catatan tarifnya berubah pada 1 Januari 2027. Dalam perbandingan harga model AI ini, jangan hanya melihat angka biaya satu permintaan: perhitungkan proporsi token masukan yang dapat memakai cache, panjang jawaban, dan frekuensi penggunaan. MiniMax mempertahankan tarif tetap, sementara tarif Gemini saat ini bersifat sementara. Skor kecerdasan kedua model juga berdekatan, jadi selisih benchmark saja tidak cukup untuk membenarkan biaya yang jauh lebih tinggi.
Biaya pemakaian: dampak cache dan kenaikan Gemini
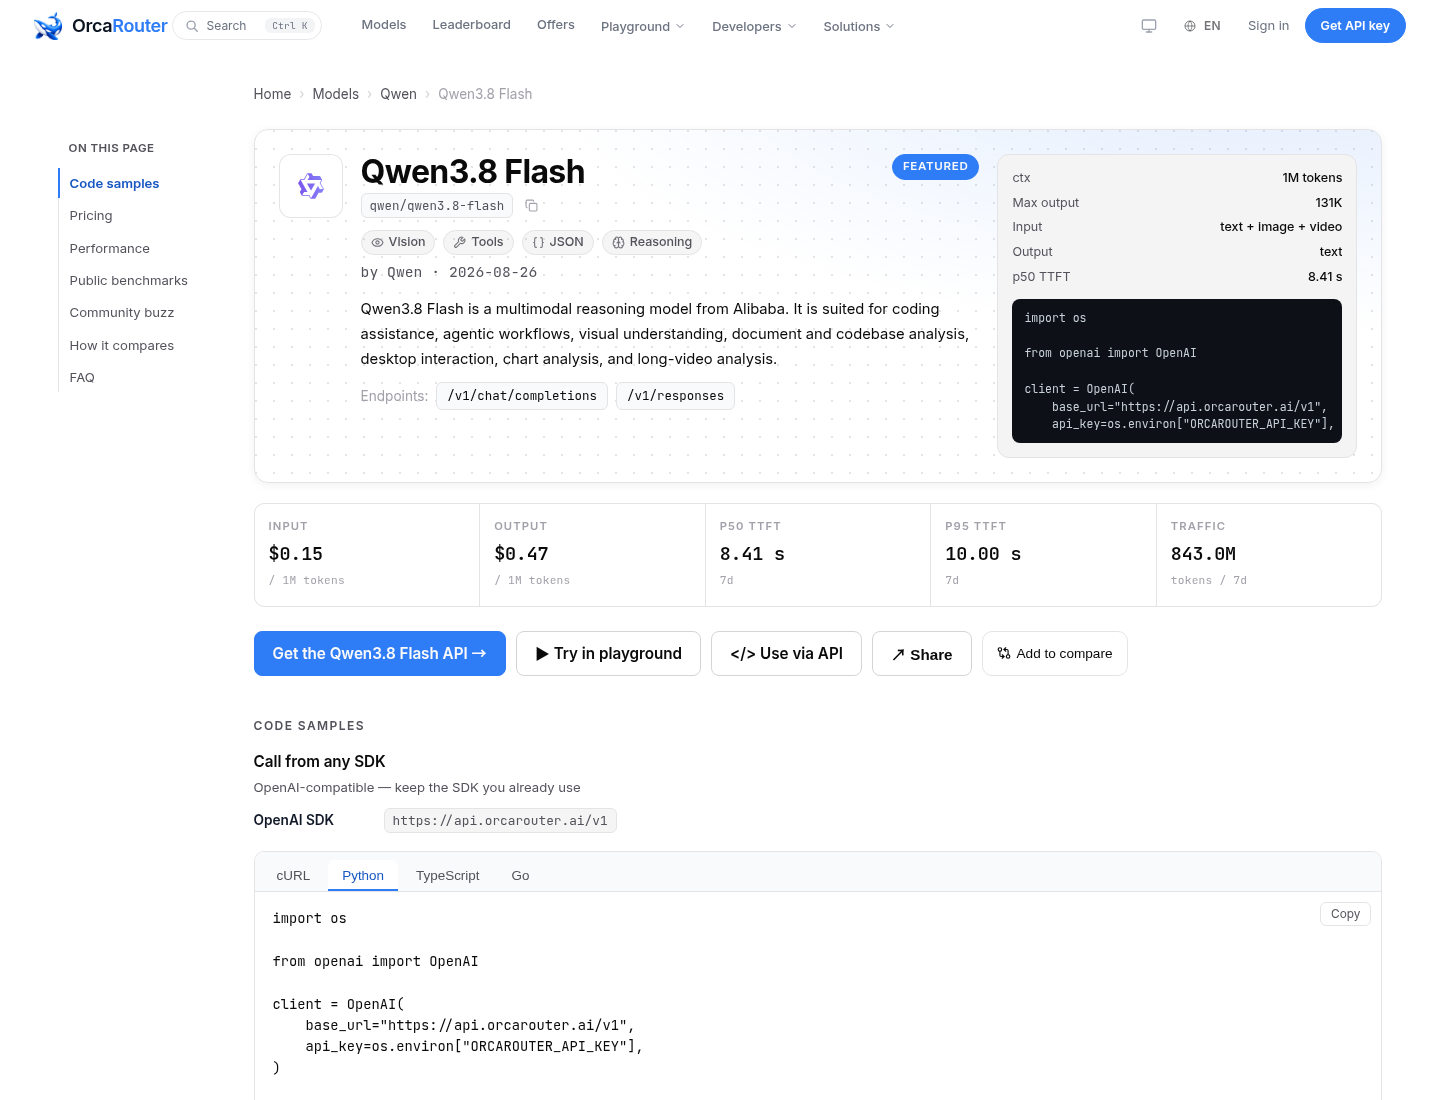
MiniMax M3.1 Flash mempertahankan tarif tetap untuk token masukan dan keluaran, sedangkan tarif Gemini 3.8 Flash yang berlaku hingga akhir 2026 akan naik dua kali lipat mulai 1 Januari 2027. Saat ini, biaya token masukan Gemini sekitar lima kali biaya MiniMax; untuk token keluaran, selisihnya lebih dari enam kali. Setelah perubahan tarif, selisihnya menjadi sepuluh kali untuk masukan dan dua belas setengah kali untuk keluaran. Inilah inti perbandingan MiniMax vs Gemini biaya: semakin banyak permintaan dan semakin panjang jawaban, semakin besar dampak perbedaannya terhadap anggaran. MiniMax juga mengenakan biaya cache yang lebih rendah. Namun, penyimpanan cache Gemini ditagih terpisah per jam, sehingga biaya pemakaian cache tidak menggambarkan seluruh pengeluaran. Untuk proyek kecil, selisih per permintaan mungkin belum menentukan; pada volume enterprise, pengulangan biaya itu dapat mengubah kelayakan ekonomi. Hitung dengan pola token dan cache aplikasi sendiri sebelum menetapkan anggaran.
Kapasitas keluaran dan kompromi kemampuan
Kapasitas keluaran adalah pembeda praktis yang dapat mengubah ROI, terutama untuk rangkuman panjang, analisis dokumen, atau pembuatan konten dalam satu permintaan. MiniMax memiliki batas keluaran yang jauh lebih besar, sedangkan Gemini membatasi keluaran pada kapasitas yang lebih rendah. Keduanya menyediakan jendela konteks masukan sebesar satu juta token, tetapi konteks besar tidak otomatis berarti jawaban dapat sepanjang itu. Artificial Analysis memberi MiniMax skor Intelligence Index 43 dan Gemini 41 pada pengujian yang sama; selisih kecil ini sebaiknya dibaca sebagai kedekatan kemampuan, bukan kemenangan mutlak. MiniMax juga memiliki bobot yang dapat diunduh dengan lisensi komunitas, sedangkan Gemini tertutup. Periksa syarat lisensi dan kesiapan infrastruktur sebelum memilih opsi bobot terbuka. Untuk banyak produk, pilihan terbaik bukan model dengan skor tertinggi, melainkan yang mampu menyelesaikan tugas dengan biaya dan batas keluaran yang sesuai.
| Aspek | MiniMax M3.1 Flash | Gemini 3.8 Flash |
|---|---|---|
| Jendela konteks masukan | 1.000.000 token | 1.000.000 token |
| Keluaran maksimum | 524.288 token | 65.536 token |
| Intelligence Index | 43 | 41 |
| Akses bobot | Dapat diunduh; lisensi komunitas | Tertutup |
Cara memilih berdasarkan pola penggunaan
Untuk memilih model AI terbaik, ukur tiga hal pada lalu lintas nyata: jumlah permintaan, rasio token masukan yang terkena cache, dan panjang keluaran. Jika keluaran panjang menjadi kebutuhan rutin, batas MiniMax memberi ruang lebih besar tanpa harus memecah pekerjaan menjadi banyak panggilan. Jika permintaan singkat dan jarang, selisih biaya total mungkin tidak seberarti kecocokan integrasi atau hasil pada tugas khusus. Tidak ada data perbandingan kecepatan pemrosesan yang cukup untuk menetapkan pemenang; uji waktu respons pada beban dan konfigurasi aplikasi sendiri. Mulailah dengan sampel tugas produksi, catat penggunaan token serta tingkat keberhasilan,