
Gambaran Umum: Mercury 3 vs Qwen3.8-Max untuk Proyek Nyata
Perbandingan Mercury 3 vs Qwen3.8-Max adalah analisis dua model AI dengan karakter sangat berbeda: satu fokus pada model AI termurah per token dengan throughput tinggi, satunya lagi pada penalaran kuat, multimodal, namun lebih lambat dan lebih mahal per tugas, sehingga developer perlu menimbang biaya token AI terhadap performa model AI per pekerjaan yang selesai, bukan sekadar tarif daftar. Mercury 3 cocok untuk pipeline teks yang sensitif latensi dan volume besar, sementara Qwen3.8-Max lebih tepat untuk tugas multimodal yang menuntut kecerdasan tinggi dan toleran terhadap waktu respons panjang.
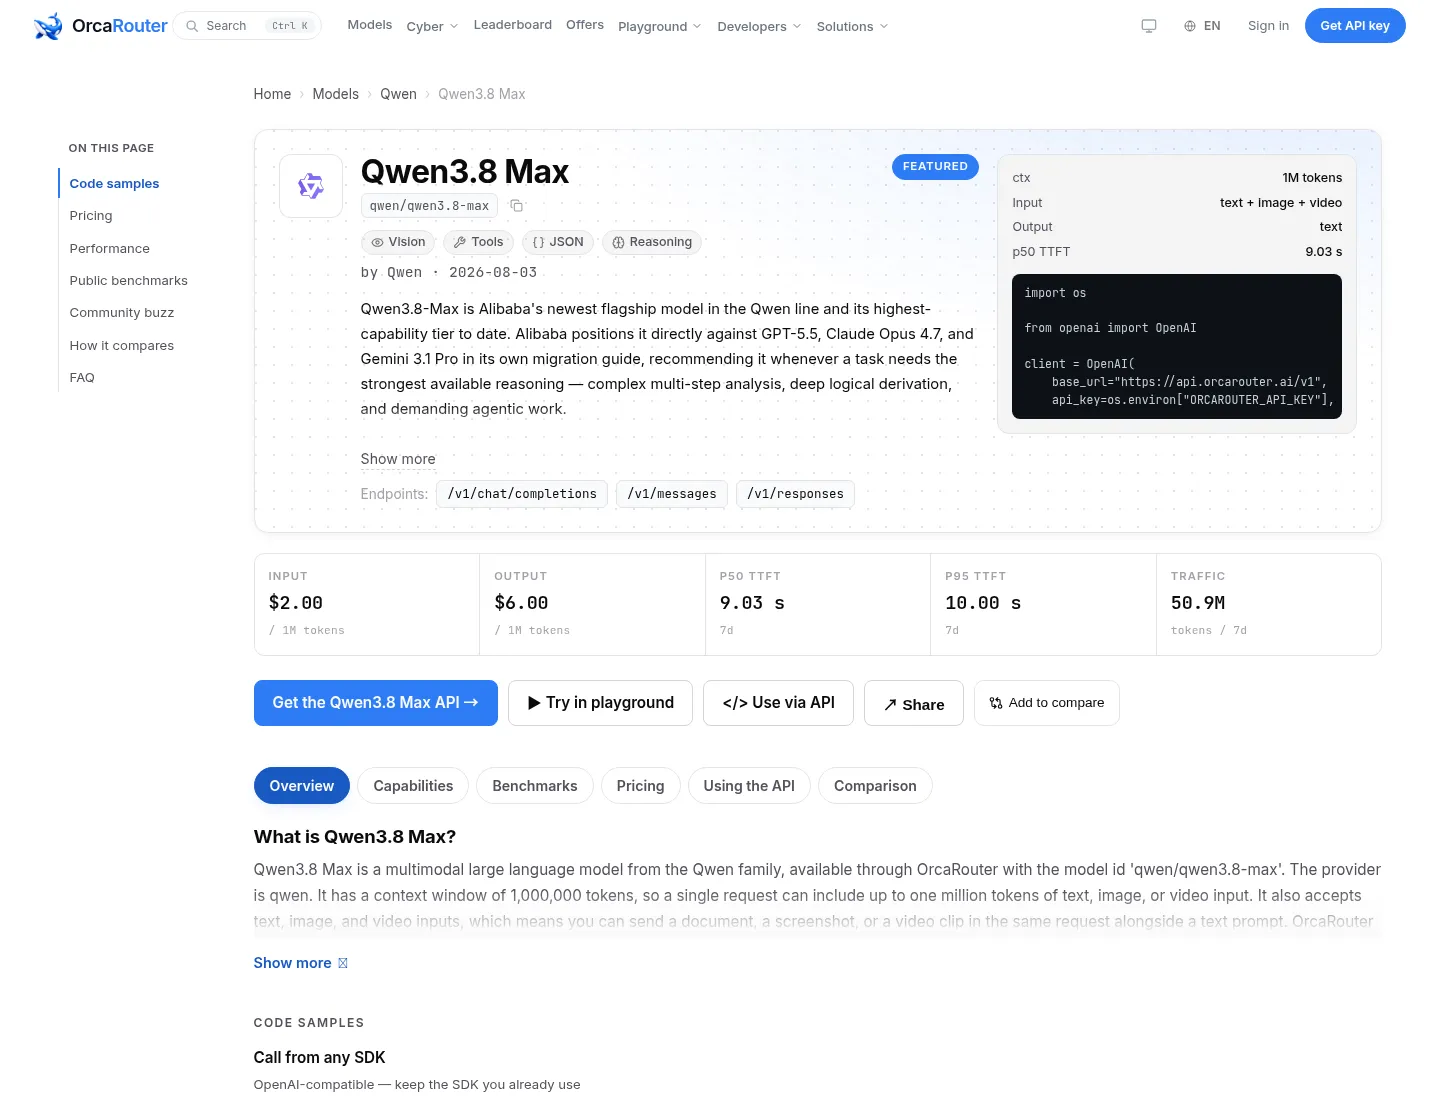
Jika Anda mengejar biaya per token serendah mungkin dan butuh throughput ribuan token per detik, Mercury 3 adalah kandidat utama. Ia adalah model bahasa difusi yang lebih dari 40 kali lebih besar daripada Mercury 1 dalam total parameter, namun tetap berjalan pada kelas throughput 1.000-an token per detik. Sebaliknya, Qwen3.8-Max adalah model sparse mixture-of-experts dengan total 2,4 triliun parameter dan 95 miliar parameter aktif per token, multimodal secara native untuk teks, gambar, dan video sebagai masukan. Pilihan terbaik bergantung pada apakah proyek Anda lebih sensitif terhadap biaya, latensi, atau kualitas penalaran.
Biaya Token AI: Murah per Token vs Murah per Pekerjaan
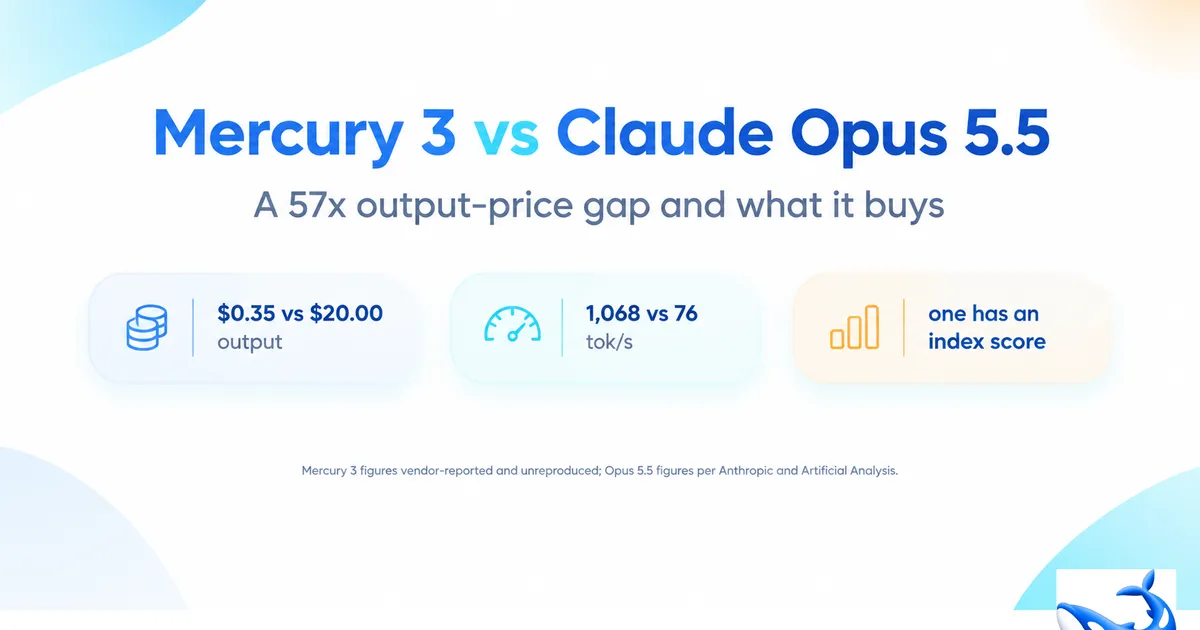
Mercury 3 diposisikan sebagai model AI termurah di antara keduanya dari sisi tarif daftar: harga input dan output per juta token pada masa peluncuran dipotong setengah dari tarif normalnya. Qwen3.8-Max, di sisi lain, memiliki tarif input dan output per juta token yang jauh lebih tinggi pada daftar harga yang sama. Secara kasat mata, Mercury 3 tampak seperti diskon besar dibanding Qwen3.8-Max, sehingga menggoda untuk menyimpulkan bahwa Mercury 3 otomatis lebih hemat untuk semua kasus penggunaan.
Namun, perbandingan biaya token AI yang sehat harus melihat biaya per pekerjaan yang selesai, bukan hanya harga per token. Qwen3.8-Max tercatat menghabiskan biaya tinggi per evaluasi Intelligence Index karena menghasilkan sekitar 190 juta token keluaran, jauh di atas median 85 juta, sehingga menjadi "sangat bertele-tele" dan mahal per tugas. Mercury 3 belum memiliki pengukuran independen setara; tidak ada biaya per tugas yang dipublikasikan, sehingga klaim hematnya masih berbasis tarif, bukan perilaku nyata. Pertanyaan yang berguna bukanlah model mana yang lebih murah per token, melainkan mana yang lebih murah per pekerjaan yang selesai, dan halaman peluncuran kedua vendor tidak menjawabnya.
| Spesifikasi | Mercury 3 | Qwen3.8-Max |
|---|---|---|
| Jenis arsitektur | Model bahasa difusi | Sparse mixture-of-experts |
| Total parameter | >40× Mercury 1 (angka absolut tidak dipublikasikan) | 2,4 triliun; 95 miliar aktif per token |
| Konteks maksimum | ≈1.000.000 token; output 131.072 token | ≈1.000.000 token; output 131.072 token |
| Throughput output | 1.068 token/detik (klaim vendor) | 39,6 token/detik; terasa lambat |
| Modalitas input | Teks saja (tidak ada klaim multimodal) | Teks, gambar, video; teks sebagai keluaran |
| Indeks kecerdasan | Tidak ada angka independen; hanya klaim internal | Skor 45; peringkat ke-33 dari 217 model |
| Biaya per tugas indeks | Belum diukur secara independen | Termasuk kuartil termahal; biaya tinggi per evaluasi |
Performa Model AI: Kecepatan Mercury 3 vs Penalaran Qwen3.8-Max
Performa model AI di sini terbagi jelas: Mercury 3 menang di throughput, Qwen3.8-Max unggul di penalaran dan modalitas. Mercury 3 melaporkan throughput 1.068 token per detik pada GPU NVIDIA, dengan jendela konteks 1 juta token dan batas output 131.072 token. Menariknya, model ini lebih dari 40 kali lebih besar daripada Mercury 1 namun tetap berada di kelas throughput 1.000-an token per detik, yang menyiratkan peningkatan efisiensi komputasi atau perubahan arsitektur yang belum dijelaskan. Kutipan yang relevan: "Mercury 3 lebih dari 40 kali lebih besar daripada Mercury 1 dalam total parameter, dan tetap berjalan pada 1.000-an token per detik."
Qwen3.8-Max menonjol pada sisi kecerdasan dan fleksibilitas. Ia mencatat skor 45 pada Artificial Analysis Index v4.3.2 dan menempati peringkat ke-33 dari 217 model pada snapshot terkini. Namun, kecepatan outputnya hanya 39,6 token per detik dan berada di peringkat 183 dari 186, dengan ringkasan yang menyebutnya "terasa lambat". Kombinasi metrik ini konsisten dengan deskripsi: Qwen3.8-Max adalah model dengan penalaran kuat, lambat, dan banyak bicara; ia bagus dalam hal yang menjadi dasar penetapan harganya, tetapi mahal secara marginal karena butuh banyak langkah untuk melakukannya. Sementara itu, satu-satunya hasil terstruktur Mercury 3 adalah 50% penyelesaian pada 50 tugas navigasi Mind2Web dalam harness internal, tanpa tolok ukur numerik lain.
Keterbatasan dan Kecocokan Use Case: Jangan Tukar Kekuatan Keduanya
Baik Mercury 3 maupun Qwen3.8-Max membawa catatan penting yang sering disembunyikan oleh framing pemasaran. Untuk Mercury 3, tidak ada pengukuran independen per 20 Oktober; harness netral yang digunakan untuk perbandingan antarmodel sama sekali belum memiliki halaman Mercury 3. Selain itu, klaim kualitasnya hanya menyebut bahwa model ini "mengungguli" beberapa model cepat lain tanpa menyebut tolok ukur, selisih margin, atau angka numerik; satu-satunya hasil terstruktur adalah 50% penyelesaian pada 50 tugas Mind2Web dalam harness milik vendor sendiri. Artinya, performa model AI Mercury 3 di luar kecepatan dan konteks masih merupakan klaim arah, bukan pengukuran.
Qwen3.8-Max, meski memiliki rekam jejak independen, juga tidak bebas dari kelemahan. Biaya per tugas indeksnya termasuk dalam kuartil termahal, dan verbositasnya mencapai 190 juta token keluaran di seluruh proses indeks, jauh di atas median 85 juta. Jadi, pertanyaan yang berguna bukanlah model mana yang lebih murah per token, melainkan mana yang lebih murah per pekerjaan yang selesai, dan halaman peluncuran kedua vendor tidak menjawabnya. Rekomendasi praktis: beri Qwen3.8-Max ujung yang panjang, multimodal, dan berisiko tinggi; ini satu-satunya dari kedua model yang dapat menerima input non-teks dan memiliki skor independen. Beri Mercury 3 ujung yang singkat, hanya teks, dan kritis terhadap latensi, di mana jawaban yang salah murah untuk dideteksi. Dan jangan beri model mana pun pekerjaan yang bergantung pada kekuatan model lainnya; Qwen3.8-Max tidak dapat dibuat cepat hanya dengan permintaan sopan, dan Mercury 3 tidak dapat membaca halaman PDF.
Buy if / Skip if
- Buy the Mercury 3 if Anda membangun fitur autocomplete, penulisan ulang kueri, atau klasifikasi tahap pertama yang sensitif terhadap latensi dan dapat mentoleransi kesalahan murah untuk dideteksi.
- Skip the Mercury 3 if Anda butuh model dengan tolok ukur kualitas independen dan rekam jejak terukur di berbagai dataset standar.
- Buy the Mercury 3 if Anda ingin model AI termurah per token dengan throughput sekitar 1.068 token per detik dan konteks 1 juta token untuk pipeline teks besar.
- Skip the Mercury 3 if Anda memerlukan pemrosesan multimodal seperti gambar atau video, karena model ini diposisikan sebagai hanya teks.
- Buy the Qwen3.8-Max if Anda mengerjakan dokumen panjang, alur multimodal, atau tugas berisiko tinggi yang membutuhkan penalaran kuat dan