
Gambaran Umum: Model Lokal vs API Cloud
Perbandingan model AI adalah proses menilai beberapa model bahasa dan multimodal berdasarkan biaya, cara penyebaran, jendela konteks token, serta kemampuan seperti visi dan multilingual agar tim dapat memilih kombinasi model lokal dan API cloud yang paling sesuai dengan volume trafik, durasi proyek, dan jenis tugas yang ingin diotomasi. Untuk kebanyakan tim, pilihan praktis mengerucut pada dua jalur: model lokal yang diunduh dan dijalankan di GPU sendiri, atau model API berbayar yang diakses lewat cloud. Model lokal seperti LFM2.5-24B-A2B, Nemotron 3.5 Bolt 74B, dan Granite 4.2 30B menuntut investasi GPU untuk AI di awal, tetapi bisa hemat biaya jangka panjang jika trafik token besar dan stabil. Sebaliknya, API seperti Qwen3.8-27B, Claude Haiku 5.5, dan Aion 3.5 lebih cocok untuk prototype cepat, tim kecil, atau proyek yang belum jelas volumenya.
Spesifikasi Inti dan Konteks Token Panjang
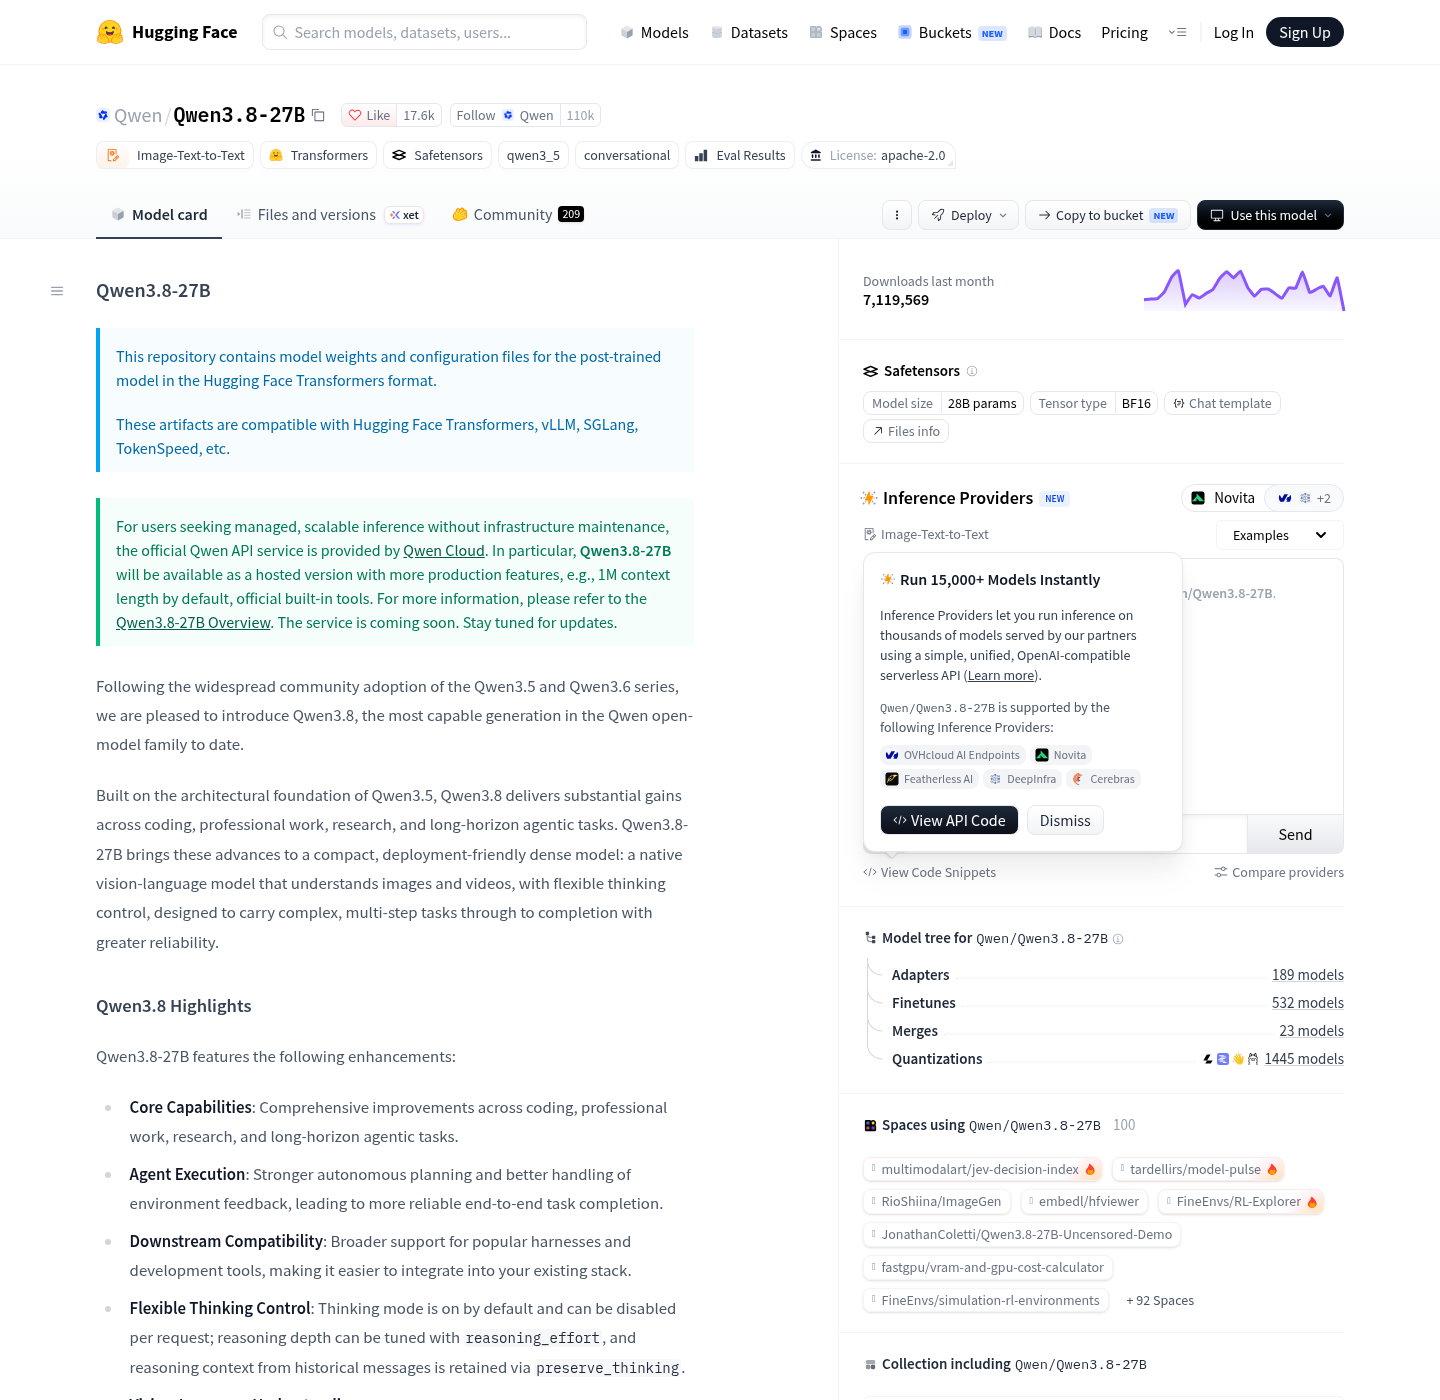
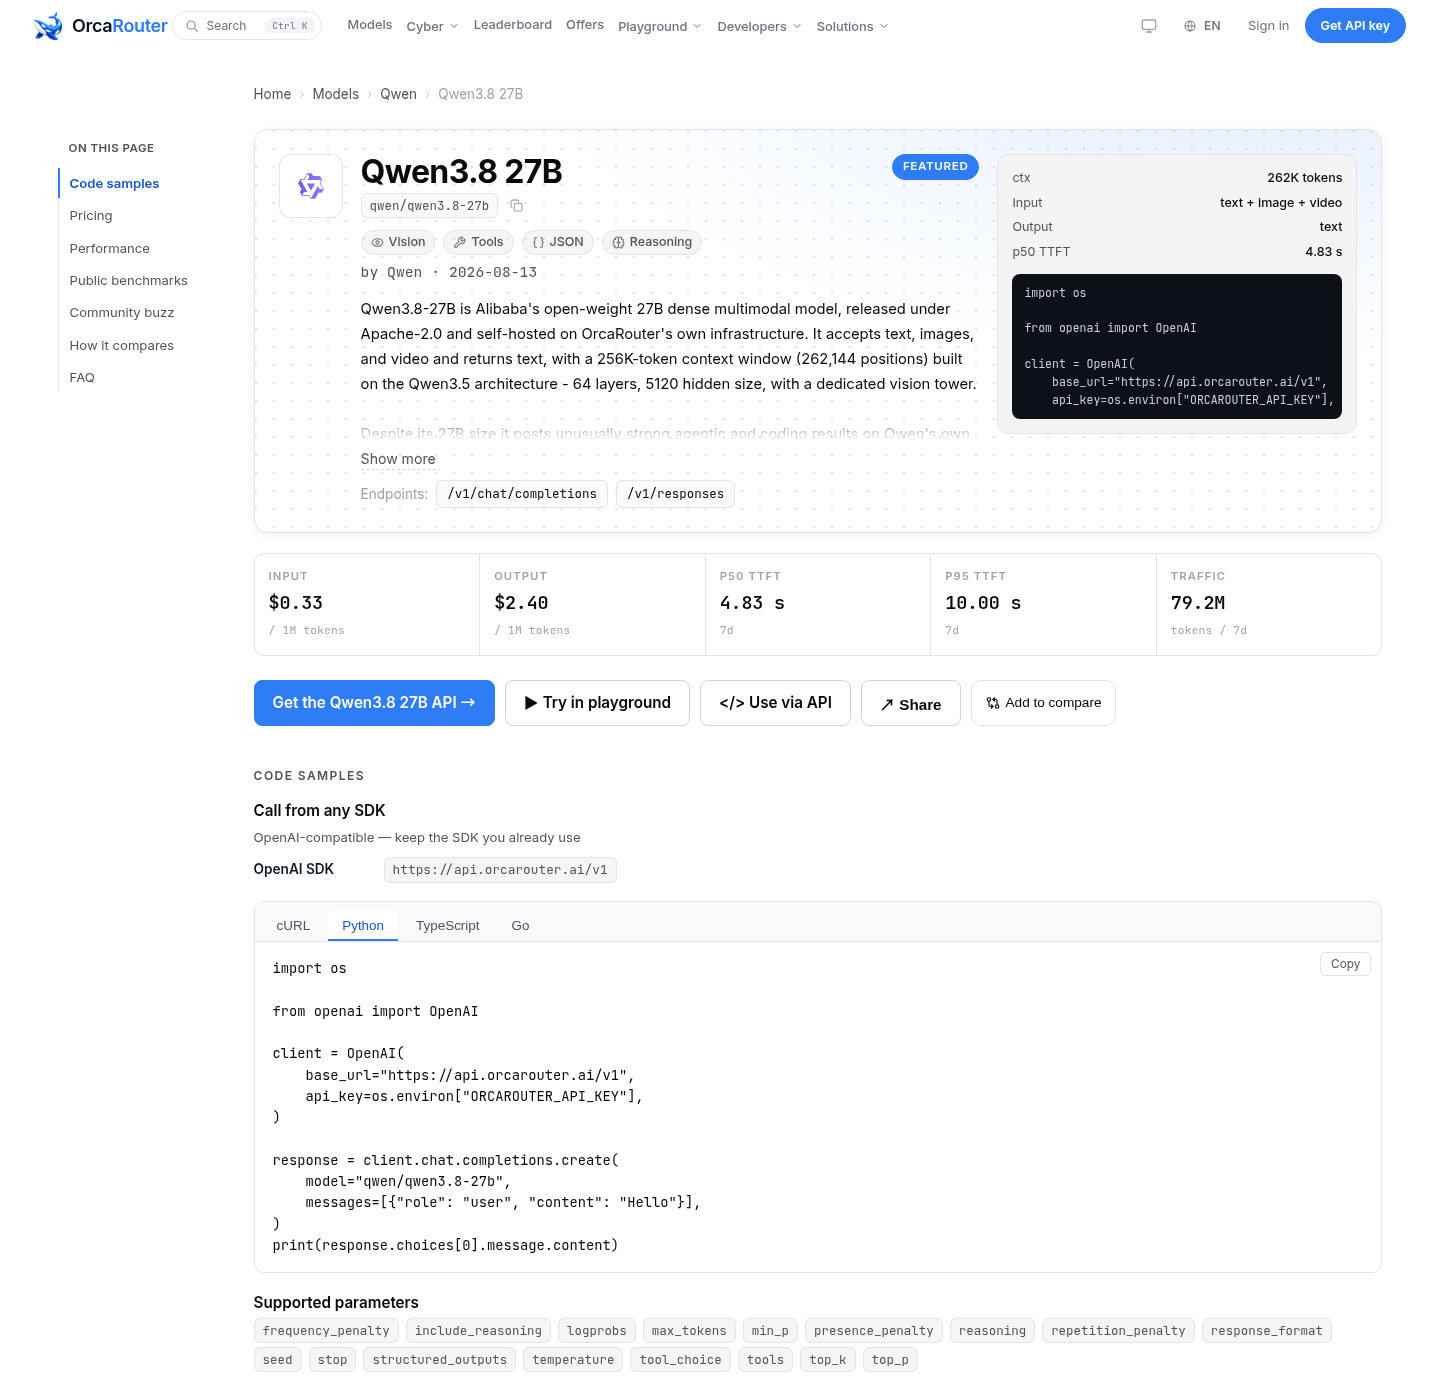
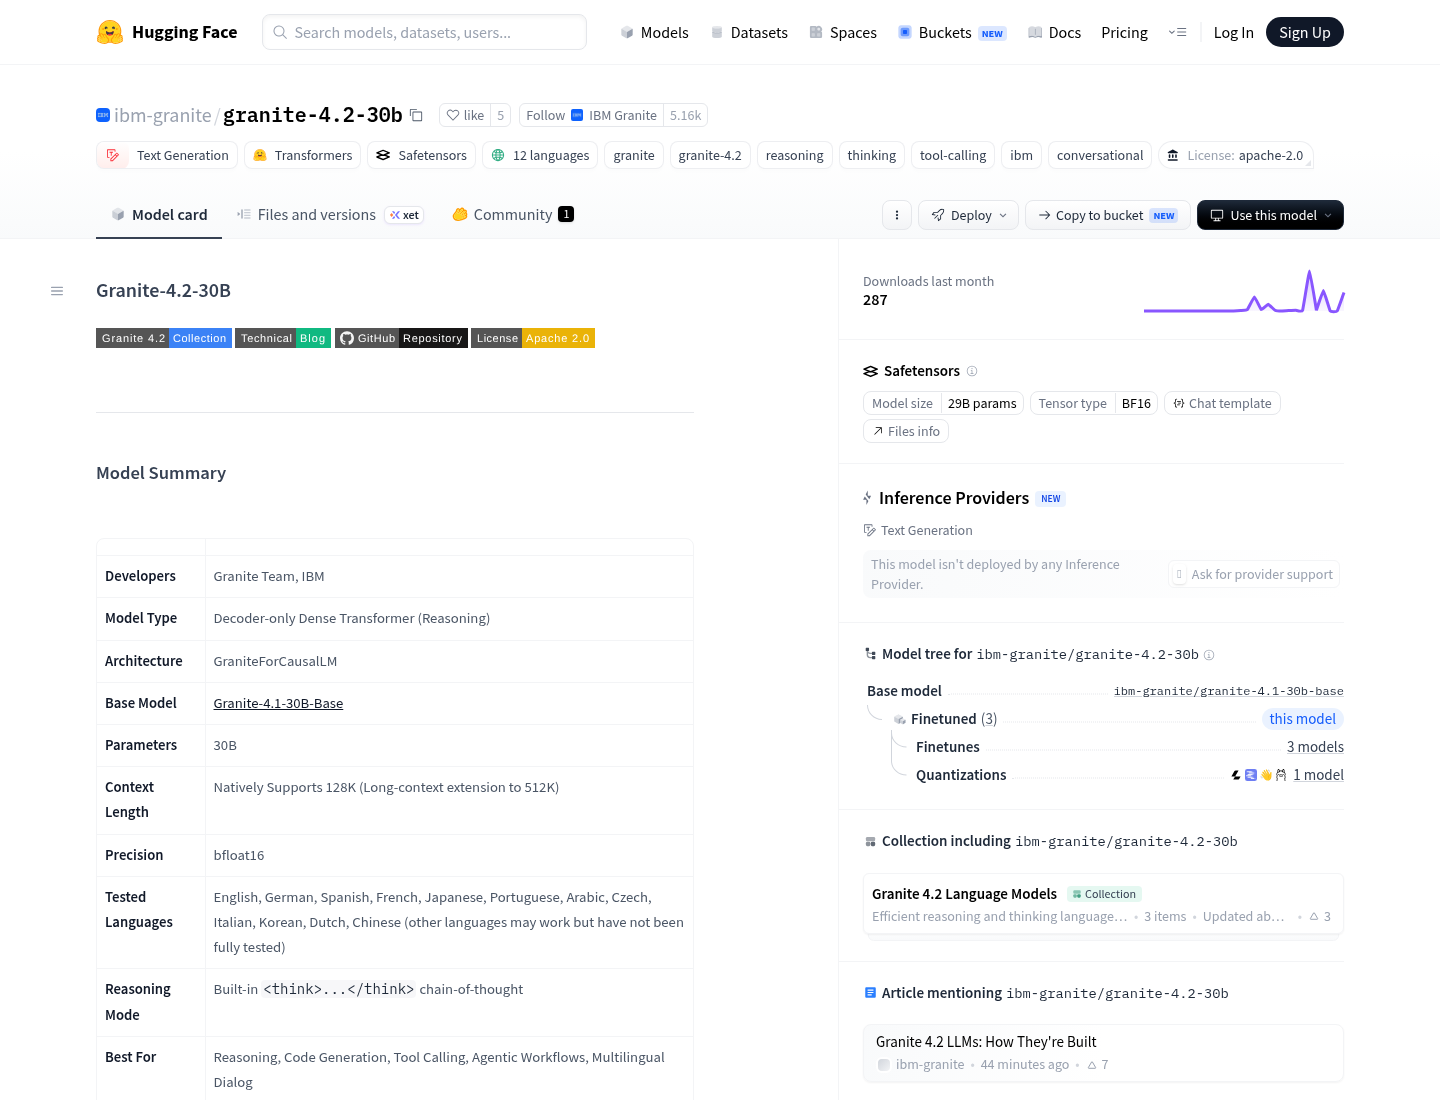
Untuk memilih model, perhatikan tiga hal teknis: ukuran parameter, jenis arsitektur, dan panjang konteks token. LFM2.5-24B-A2B adalah mixture-of-experts 24 miliar parameter dengan sekitar 2,45 miliar parameter aktif per token dan konteks 131.072 token, dirancang sebagai model penalaran teks untuk agen di perangkat. Granite 4.2 30B adalah transformer dense 30 miliar parameter dengan 64 lapisan dan presisi bfloat16, sehingga setiap parameter aktif di setiap token dan kebutuhan GPU lebih berat. Qwen3.8-27B adalah model dense multimodal 27 miliar parameter dengan jendela konteks sekitar 262.144 token dan menambahkan tower visi khusus. Aion 3.5 menawarkan konteks token panjang 262.144 token dengan batas keluaran 32.768 token dan digambarkan sebagai sistem multi-model dengan penalaran wajib. Konteks token panjang seperti 512K–262K sangat penting untuk repositori kode besar, kontrak panjang, atau pipeline RAG yang memuat banyak dokumen sekaligus.
| Spec | Model Lokal (LFM2.5 / Granite / Nemotron) | Model API (Qwen3.8 / Claude Haiku / Aion 3.5) |
|---|---|---|
| Cara pakai | Unduh open-weight, jalankan di GPU sendiri | Akses via endpoint API cloud |
| Arsitektur | LFM2.5 MoE 24B; Granite dense 30B; Nemotron 3.5 Bolt 74B besar | Qwen3.8 dense 27B multimodal; Haiku model komersial; Aion 3.5 sistem multi-model |
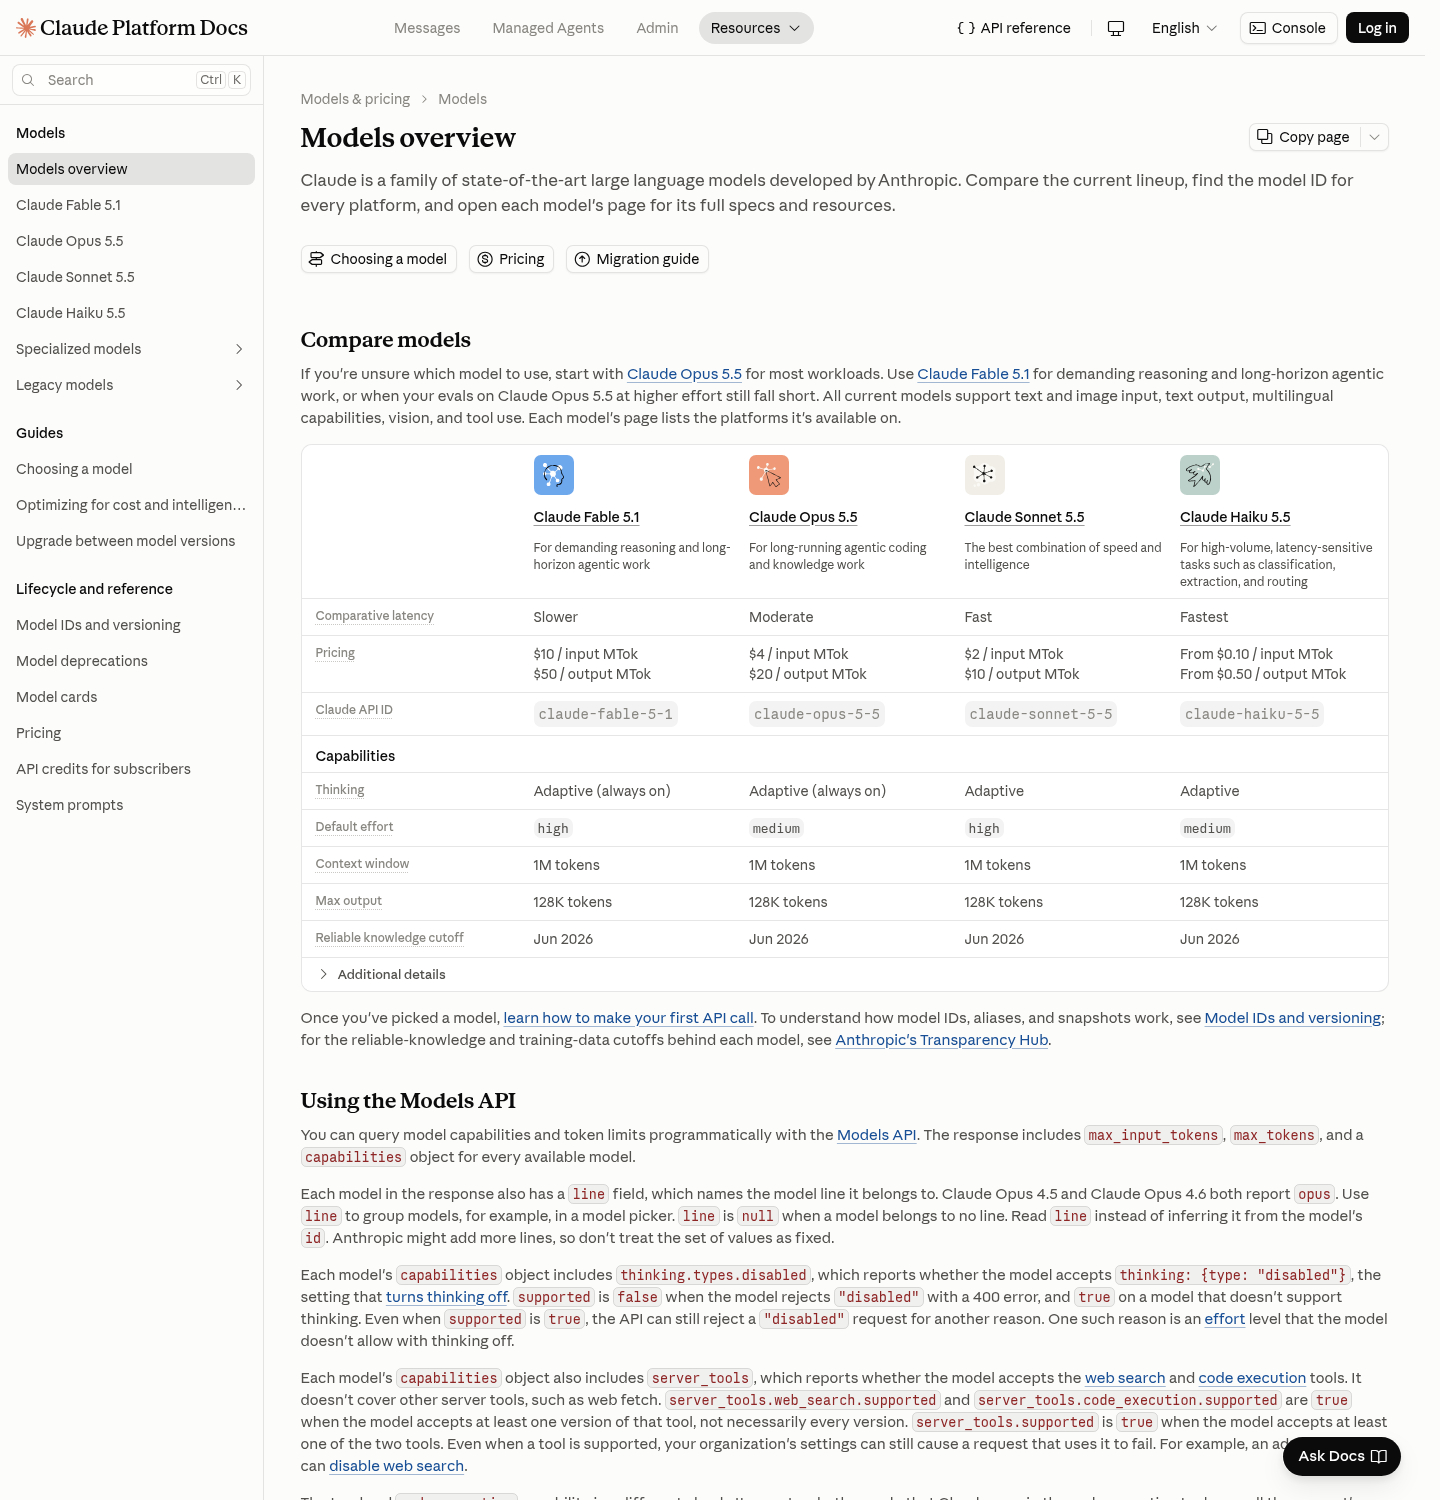
| Konteks token | LFM2.5 hingga 131.072; Granite panjang tapi tidak disebut eksplisit | Qwen3.8 sekitar 262.144; Aion 3.5 262.144; Haiku hingga sekitar satu juta |
| Kemampuan visi | Umumnya teks (Granite, LFM2.5, Nemotron fokus penalaran/coding) | Qwen3.8 punya vision tower; model lain fokus teks tapi mendukung tools |
| Distribusi | Open weights di repositori model, lisensi permisif | Model komersial di platform vendor, berbayar per pemakaian |
| Skalabilitas | Skalakan dengan menambah GPU; biaya tetap setelah perangkat keras tersedia | Skalakan otomatis di cloud; biaya naik seiring volume token |
Struktur Biaya: Titik Impas GPU vs Harga API AI
Model lokal vs cloud bukan soal mana yang "lebih murah per token", tetapi mana struktur biaya yang cocok dengan trafik Anda. Menjalankan LFM2.5-24B-A2B, Nemotron 3.5 Bolt 74B, atau Granite 4.2 30B berarti Anda menanggung biaya GPU untuk AI: pembelian, sewa, atau memanfaatkan klaster yang sudah ada. Setelah kapasitas tersedia, biaya marjinal per token cenderung turun, sehingga model lokal menarik untuk beban kerja besar dan berulang seperti agen coding internal atau pipeline analitik dokumen harian. Di sisi lain, API seperti Qwen3.8-27B, Claude Haiku 5.5, Aion 3.5, dan Gemini 4 Argon menagih berdasarkan token input dan output, sehingga ideal untuk prototype, POC, atau produk dengan trafik yang masih fluktuatif. Menurut analisis OrcaRouter, perbandingan yang berguna adalah "mana dari kedua struktur biaya ini yang cocok dengan trafik yang benar-benar Anda miliki", bukan sekadar angka harga API AI di brosur.
Kemampuan Visi, Multilingual, dan Kapan Memilih Model Premium
Kemampuan tambahan seperti visi dan bahasa multilingual sering menjadi pembeda antara model lokal vs cloud. Qwen3.8-27B membawa tower visi khusus dan dirancang sebagai model multimodal, sehingga cocok untuk aplikasi yang membaca gambar, PDF, atau UI. Gemini 4 Argon menerima teks, gambar, suara, video, dan PDF dalam satu jendela konteks terpadu sekitar satu juta token, sehingga kuat untuk agen yang harus memahami banyak jenis media sekaligus. Aion 3.5 dan Granite 4.2 30B menekankan penalaran dengan penggunaan tag <think> internal untuk meningkatkan matematika, pemrograman, dan logika multi-langkah. Model lokal seperti Nemotron 3.5 Bolt 74B biasanya dioptimalkan untuk coding dan agentic tools, tetapi menambah kemampuan visi bisa berarti kebutuhan GPU lebih besar. API premium dengan multimodal dan multilingual lebih masuk akal bila Anda membangun produk konsumen lintas bahasa atau sistem analisis dokumen multimedia, bukan sekadar chatbot teks internal.
Strategi Memilih: Volume Token, Durasi Proyek, dan Profil Tim
Keputusan akhir sebaiknya berangkat dari tiga pertanyaan: berapa volume token, berapa lama proyek berjalan, dan seperti apa profil tim. Untuk startup kecil yang butuh iterasi cepat, API seperti Claude Haiku 5.5, Qwen3.8-27B, Aion 3.5, atau Gemini 4 Argon memberi fleksibilitas: tidak perlu mengelola klaster GPU, cukup fokus ke produk. Untuk perusahaan dengan tim infra kuat dan trafik token besar yang stabil, mengunduh LFM2.5-24B-A2B, Nemotron 3.5 Bolt 74B, atau Granite 4.2 30B dan menjalankannya di GPU sendiri bisa mengurangi biaya jangka panjang dan memberi kontrol penuh atas data. Konteks token panjang 262K–1M penting bila Anda sering memproses repositori kode, basis pengetahuan, atau kontrak panjang; jika tidak, Anda bisa memilih model yang lebih kecil dan hemat. Titik impas antara sewa GPU vs API muncul ketika biaya tetap GPU terbagi ke volume token yang cukup besar selama umur proyek.
Buy if / Skip if
- Buy the model lokal (LFM2.5, Nemotron, Granite) if Anda memiliki atau siap menyewa GPU untuk AI dan trafik token Anda besar serta stabil.
- Skip the model lokal (LFM2.5, Nemotron, Granite) if tim Anda kecil, tidak punya keahlian infra, atau volume permintaan masih sulit diprediksi.
- Buy the Qwen3.8-27B API if Anda butuh multimodal dengan konteks token panjang sekitar 262K untuk membaca dokumen, gambar, dan antarmuka sekaligus.
- Skip the Qwen3.8-27B API if aplikasi Anda murni teks internal dan Anda ingin menghindari ketergantungan pada layanan cloud.
- Buy the Claude Haiku 5.5 API if Anda memprioritaskan latensi rendah dan ingin model komersial cepat untuk prototype dan produk awal.
- Skip the Claude Haiku 5.5 API if Anda mengejar biaya jangka panjang serendah mungkin pada beban kerja besar yang bisa dipindah ke GPU sendiri.
- Buy the Aion 3.5 API if Anda membutuhkan konteks token panjang 262.144 dan perilaku penalaran wajib untuk tugas logika multi-langkah.
- Skip the Aion 3.5 API if kebutuhan konteks Anda pendek dan Anda bisa puas dengan model yang lebih kecil atau lokal.
- Buy the Gemini 4 Argon API if Anda membangun agen multimodal yang membaca teks, gambar, suara, dan video dalam satu pipeline.
- Skip the Gemini 4 Argon API if produk Anda tidak butuh multimodal dan Anda ingin mengurangi kompleksitas integrasi.