
Gambaran Umum: Murah vs Efisien dalam Model AI
Perbandingan harga model AI adalah proses menilai biaya token input output beberapa model sekaligus mengukur kualitas jawaban, sehingga pengguna dapat memilih AI termurah efisien yang mengurangi total panggilan dan koreksi ulang, bukan sekadar mencari tarif token paling rendah di kartu spesifikasi. Dalam konteks ini, Qwen3.8-Flash-Next, Claude Opus, dan Mercury 3 mewakili tiga pendekatan: model premium dengan penalaran kuat, model pratinjau yang jauh lebih murah, dan model difusi yang fokus kecepatan. Secara garis besar, Qwen cocok untuk analisis data cepat dan tugas pengetahuan yang sering diulang, Claude untuk pekerjaan kompleks berisiko tinggi, sementara Mercury menarik untuk aplikasi volume tinggi seperti dukungan otomatis dan pelengkapan teks. Namun, harga token rendah tidak selalu berarti penghematan total; model yang sering salah akan memaksa Anda mengulang prompt dan menambah biaya waktu tim maupun panggilan API.
Qwen3.8-Flash-Next vs Claude Opus 4.8: Hemat Besar, Risiko Penalaran
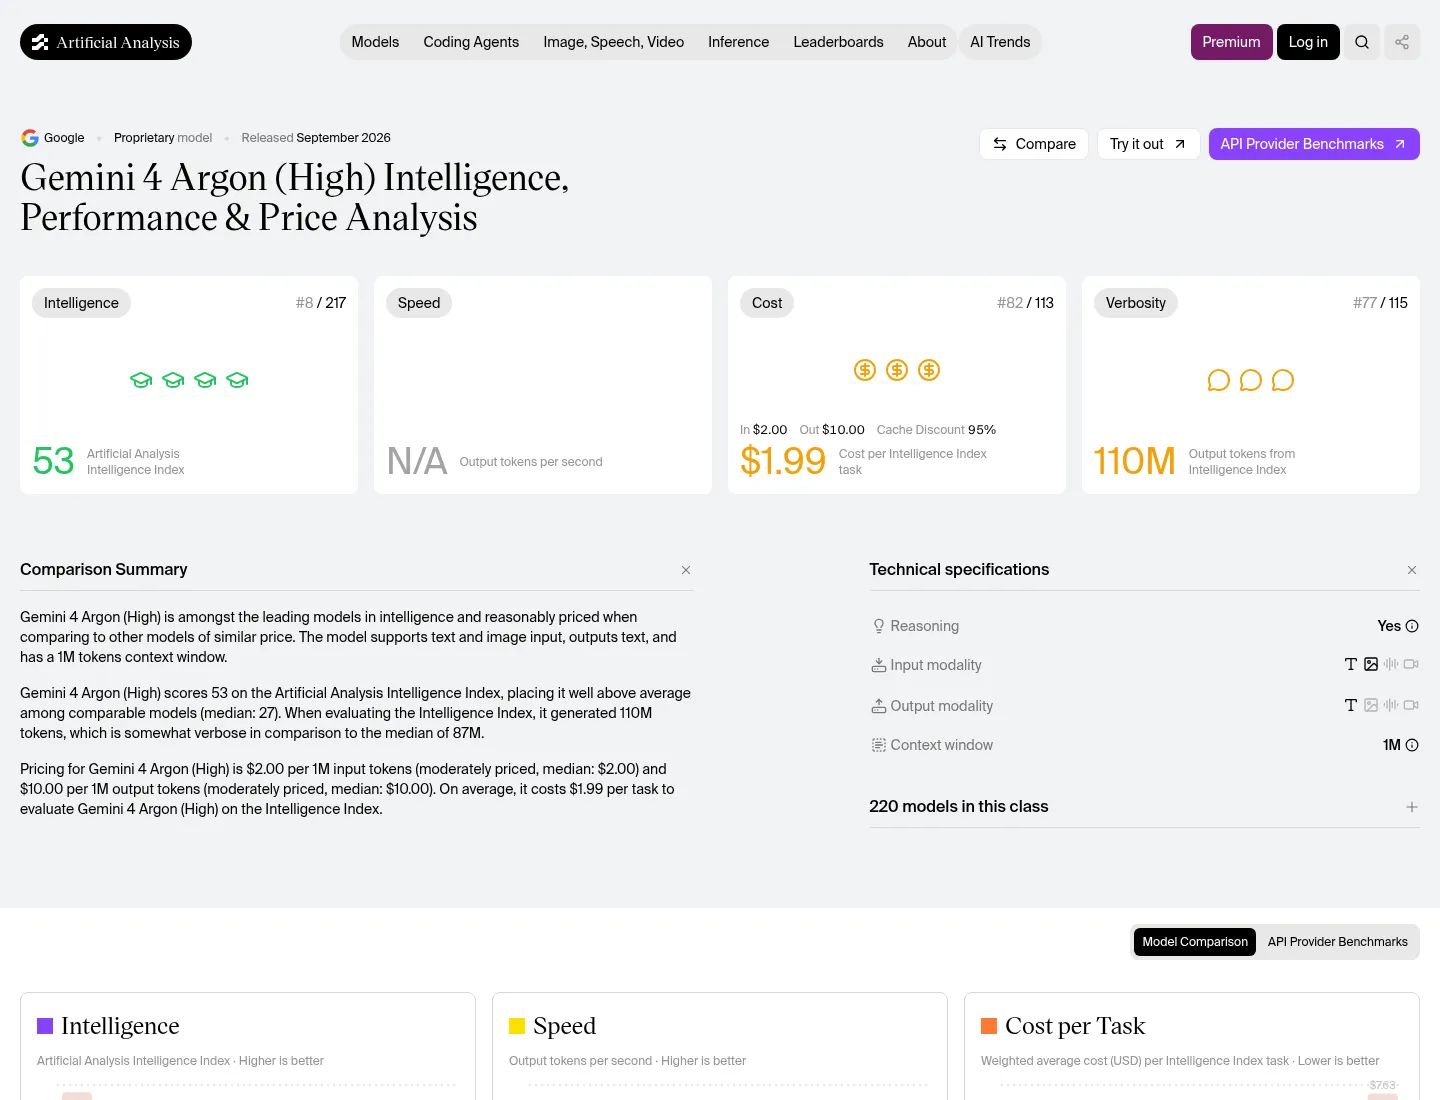
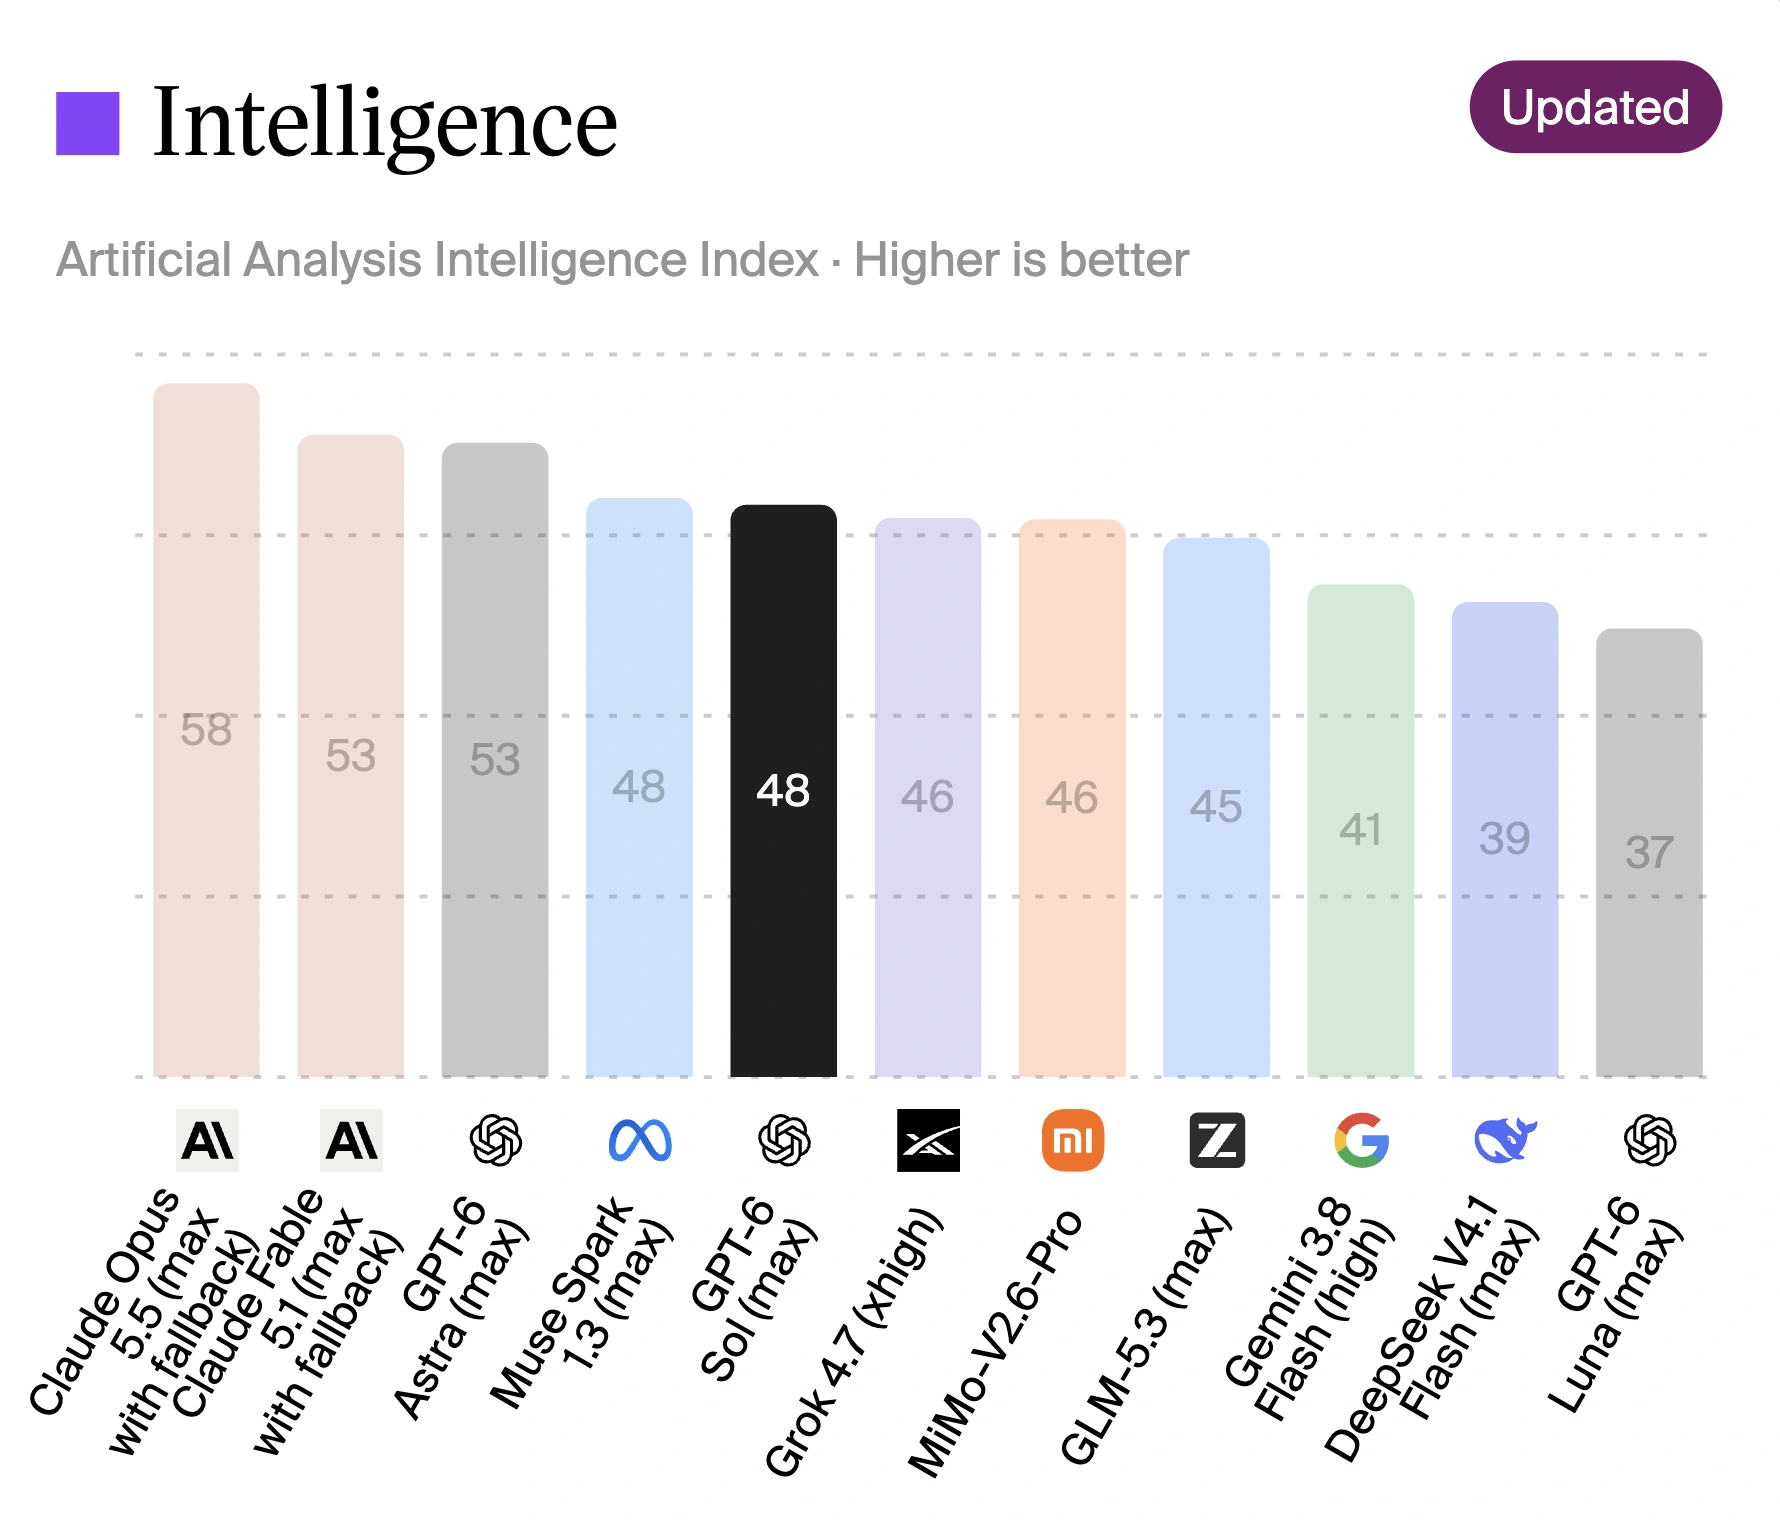
Qwen3.8-Flash-Next adalah pratinjau berbobot terbuka untuk arsitektur Qwen4 yang ditawarkan sebagai model murah dengan kualitas mendekati model premium. Pada layanan Qwen3.8-Flash, input 33 kali lebih murah dan output 53 kali lebih murah daripada Claude Opus 4.8, sehingga tampak sebagai pilihan AI termurah efisien untuk beban kerja besar. Di sisi kualitas, Artificial Analysis mencantumkan Claude Opus 4.8 pada 41,8 di Intelligence Index dan Qwen3.8-Flash-Next pada 40; keduanya dinilai pada indeks penyedia yang sama, tetapi pada tanggal berbeda, sehingga data berdampingan ini bukan perbandingan terkontrol. Dalam penalaran, Humanity's Last Exam mencatat 38% untuk Qwen pratinjau dibanding 48,7% untuk Claude Opus 4.8, menegaskan bahwa model mahal ini unggul ketika pekerjaan panjang, ambigu, dan mahal jika salah. Model murah ini mendekati pada pekerjaan pengetahuan, tugas terminal, dan penalaran umum, sehingga cocok untuk analisis data cepat dan laporan rutin.
| Spesifikasi | Qwen3.8-Flash-Next | Claude Opus 4.8 |
|---|---|---|
| Kelas harga relatif | Sangat murah (33x lebih murah untuk input) | Premium dengan biaya jauh lebih tinggi |
| Indeks kecerdasan (Artificial Analysis) | 40 (kelas pratinjau, tanggal berbeda) | 41,8 (peringkat ke-23, persentil ke-84) |
| Penalaran Humanity's Last Exam | 38% (lebih lemah dalam tugas sulit) | 48,7% (unggul untuk penalaran kompleks) |
| Konteks maksimum | Mendukung konteks panjang melalui arsitektur baru | Konteks 1M token secara native |
| Kecepatan output | 53 token/detik, sangat bertele-tele 108k token per tugas | 66,7 token/detik, median token pertama 4,2 detik |
Mercury 3 vs Claude Opus 5.5: Kecepatan dan Biaya Total Jawaban
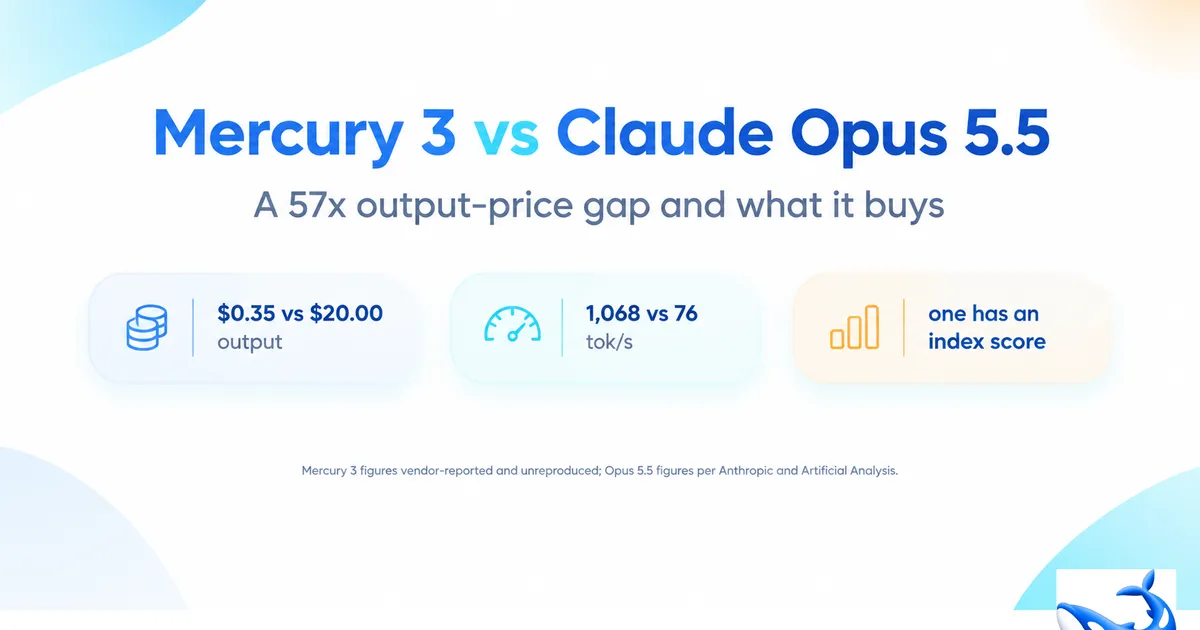
Mercury 3 diposisikan sebagai model bahasa difusi yang dirancang untuk kecepatan, sementara Claude Opus 5.5 adalah model penalaran terdepan untuk coding agentik dan pekerjaan pengetahuan jangka panjang. Mercury 3 menawarkan throughput 1.068 token per detik pada perangkat keras NVIDIA menurut pengukuran vendor, dengan konteks 1M dan output maksimum 131k token, hanya teks. Opus 5.5 membawa pemikiran adaptif, input visual dan file, konteks 1M token, serta batas output 128k, dengan skor kualitas yang diaudit independen: Intelligence Index 57,6, Humanity's Last Exam 61,4%, SciCode 66,9%, Terminal-Bench 4.0 59,6%, dan daya ingat konteks panjang 84,7%. "Pertanyaan yang menentukan perbandingan ini bukanlah angka mana yang lebih kecil. Melainkan berapa banyak panggilan Mercury 3 yang harus Anda lakukan untuk mendapatkan jawaban yang akan sudah benar didapat Opus 5.5 pada percobaan pertama," sehingga biaya token input output yang rendah bisa kalah oleh biaya re-prompt, eskalasi, dan tinjauan manusia. Pernyataan yang jujur adalah bahwa belum ada yang menjalankan kedua model pada benchmark agen yang sama dan menerbitkan hasilnya, sehingga klaim keunggulan agen masih berupa inferensi dari posisi produk.
Memilih Model: Analisis Cepat vs Tugas Kompleks
Untuk memilih AI termurah efisien, fokuslah pada biaya per tugas yang diselesaikan, bukan per token. Per tugas yang diselesaikan adalah angka yang bertahan terhadap verbositas token, dan pada beberapa model perbandingan ini belum lengkap karena data kualitas belum diaudit penuh. Model murah seperti Qwen3.8-Flash-Next mendekati kualitas Claude Opus 4.8 pada pekerjaan pengetahuan, tugas terminal, dan penalaran umum, sehingga cocok untuk analisis data cepat, rangkuman dokumen, dan jawaban pencarian yang sering diulang. Model mahal seperti Opus 4.8 dan 5.5 unggul ketika pekerjaan berisiko tinggi dan sekali jalan: proses agentik jangka panjang, debugging multi-tahap di basis kode besar, dan skenario di mana kesalahan sangat mahal untuk diperbaiki. Jika produk Anda berupa giliran suara, pelengkapan otomatis, jawaban pencarian, atau petunjuk tutor, perbedaan kecepatan dan harga antara model seperti Mercury 3 dan Opus 5.5 adalah produknya, bukan sekadar nilai tambah. Pertimbangkan juga bahwa belum ada benchmark agen yang menyamakan semua model ini, sehingga keputusan harus menggabungkan data publik dengan uji coba internal.
Buy if / Skip if
- Buy the Qwen3.8-Flash-Next if Anda butuh perbandingan harga model AI yang sangat hemat untuk analisis data cepat, rangkuman dokumen, dan tugas pengetahuan berulang, dengan kualitas penalaran umum yang mendekati model premium meski jauh lebih murah.
- Skip the Qwen3.8-Flash-Next if beban kerja Anda berupa proses agentik jangka panjang, debugging kompleks, atau tugas sekali jalan yang mahal bila salah, di mana penalaran dan reliabilitas Claude Opus lebih penting daripada biaya token input output.
- Buy the Claude Opus 4.8 if Anda membutuhkan konteks 1M token secara native dan penalaran lebih kuat untuk pekerjaan panjang, ambigu, dan berisiko tinggi, termasuk implementasi yang sudah mengandalkan kontrol thinking dan effort model ini.
- Skip the Claude Opus 4.8 if fokus utama Anda adalah volume tinggi tugas terminal sederhana dan analisis cepat, karena model murah seperti Qwen3.8-Flash-Next dapat memberikan kualitas mendekati dengan biaya jauh lebih rendah per tugas.
- Buy the Claude Opus 5.5 if Anda mengutamakan akurasi tinggi pada percobaan pertama untuk coding agentik, pekerjaan pengetahuan jangka panjang, dan penggunaan konteks panjang, sehingga mengurangi kebutuhan re-prompt dan tinjauan manual.
- Skip the Claude Opus 5.5 if aplikasi Anda adalah giliran suara, pelengkapan otomatis, atau jawaban pencarian berisiko rendah yang lebih sensitif terhadap throughput dan biaya token daripada penalaran tingkat atas.
- Buy the Mercury 3 if Anda membutuhkan model bahasa difusi yang dirancang untuk kecepatan dengan konteks 1M dan output panjang, misalnya untuk dukungan otomatis volume tinggi atau pelengkapan teks cepat.
- Skip the Mercury 3 if kualitas jawaban yang konsisten dan akurat pada percobaan pertama lebih penting daripada harga token keluaran, karena setiap percobaan ulang dan eskalasi akan menambah biaya total meski tarif token awal rendah.