
Perbandingan harga AI model: putusan singkat
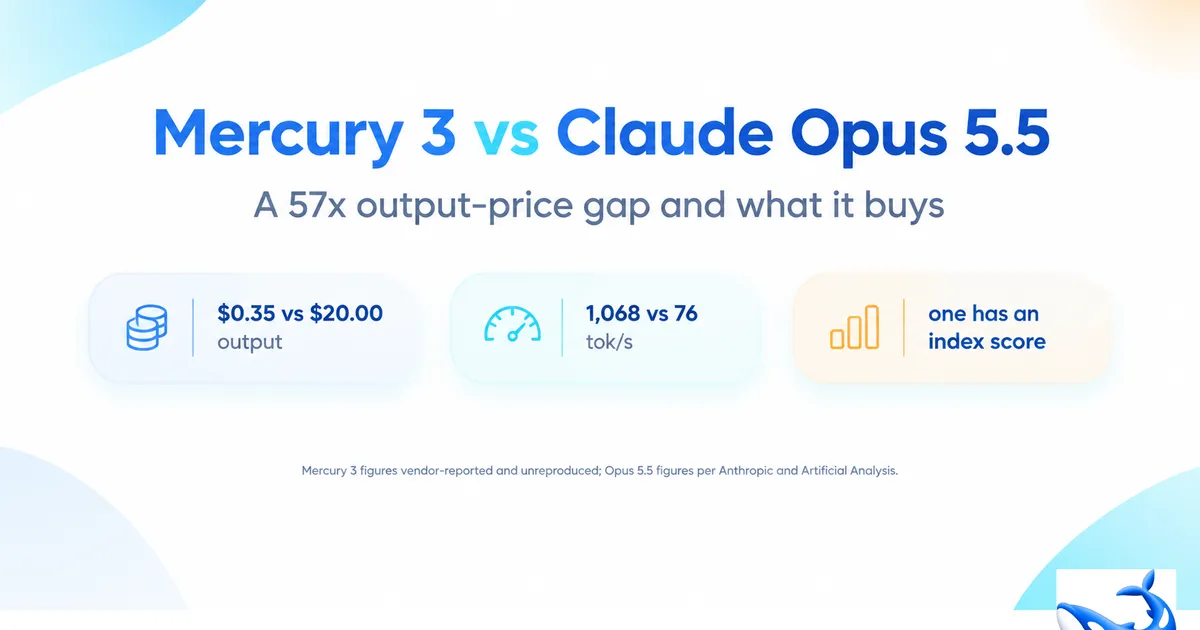
Perbandingan harga AI model adalah penilaian biaya pemakaian model berdasarkan tarif token, kemampuan menghasilkan jawaban yang tepat, dan jumlah percobaan yang diperlukan untuk menyelesaikan tugas. Mercury 3 cocok untuk pekerjaan teks yang rutin dan sensitif terhadap latensi, sementara Claude Opus 5.5 lebih layak untuk pekerjaan kompleks yang perlu akurasi dan masukan visual atau berkas. Biaya token output Mercury 3 tercatat 57 kali lebih rendah daripada Opus 5.5 selama masa peluncuran; setelah masa diskon berakhir, perbandingannya menjadi sekitar 28,6 kali. Namun, penghematan itu hanya bernilai jika Mercury 3 memenuhi standar mutu Anda tanpa banyak pengulangan atau pemeriksaan manusia. Tabel ini merangkum perbedaan yang paling memengaruhi pilihan developer.
| Aspek | Mercury 3 | Claude Opus 5.5 |
|---|---|---|
| Biaya token output | 57 kali lebih rendah saat peluncuran; sekitar 28,6 kali lebih rendah setelah diskon berakhir | Model premium dengan biaya token output jauh lebih tinggi |
| Kecepatan output | 1.068 token per detik menurut pengukuran vendor; belum direproduksi secara independen | 75,6 token per detik berdasarkan pengukuran lalu lintas penyedia, dengan metode uji berbeda |
| Konteks | 1 juta token | 1 juta token |
| Batas output | 131 ribu token | 128 ribu token |
| Masukan | Teks saja | Teks, gambar, dan berkas |

Pilih Opus untuk kemampuan, Mercury untuk kecepatan
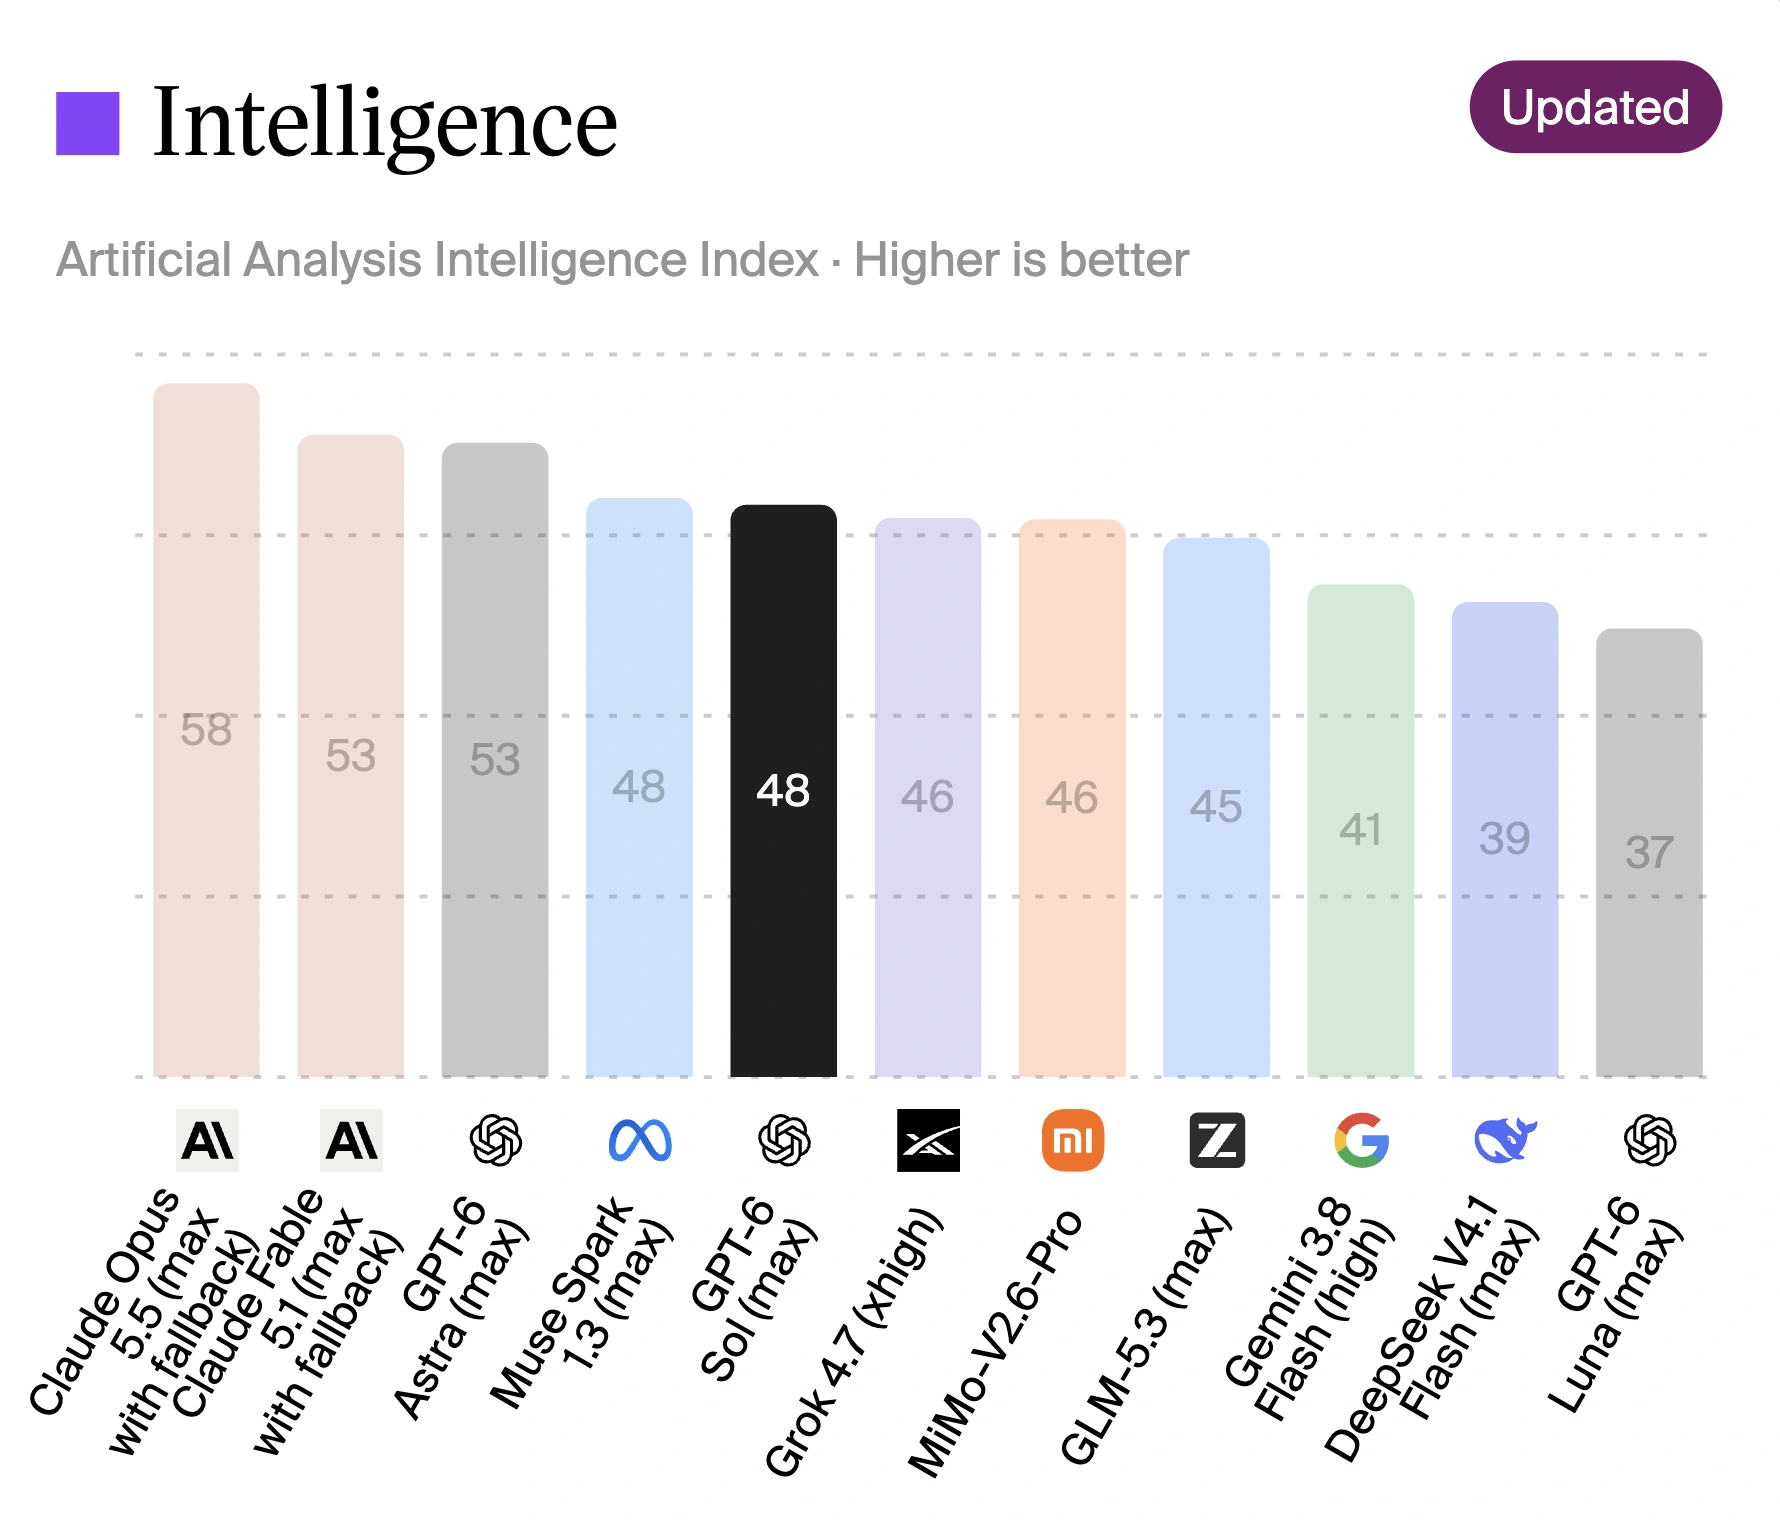
Keunggulan Opus 5.5 paling jelas pada tugas yang menuntut penalaran, pengodean, dan pemahaman materi yang beragam. Dalam pengujian yang dilakukan pada rangkaian ukurannya sendiri, model ini mencatat Intelligence Index 57,6, Humanity’s Last Exam 61,4%, SciCode 66,9%, Terminal-Bench 4.0 59,6%, serta daya ingat konteks panjang 84,7%. Dukungan gambar dan berkas juga berguna saat aplikasi harus membaca tangkapan layar, kontrak PDF, atau diagram desain. Mercury 3 menawarkan daya tarik berbeda: keluaran cepat dan biaya token yang rendah, sehingga menarik untuk antrean teks atau respons rutin. Namun, klaim kecepatannya belum diuji ulang secara independen, dan belum ada hasil yang membandingkan kedua model pada tolok ukur agen yang sama. Karena itu, jangan anggap selisih harga sebagai bukti bahwa keduanya dapat saling menggantikan pada semua tugas.
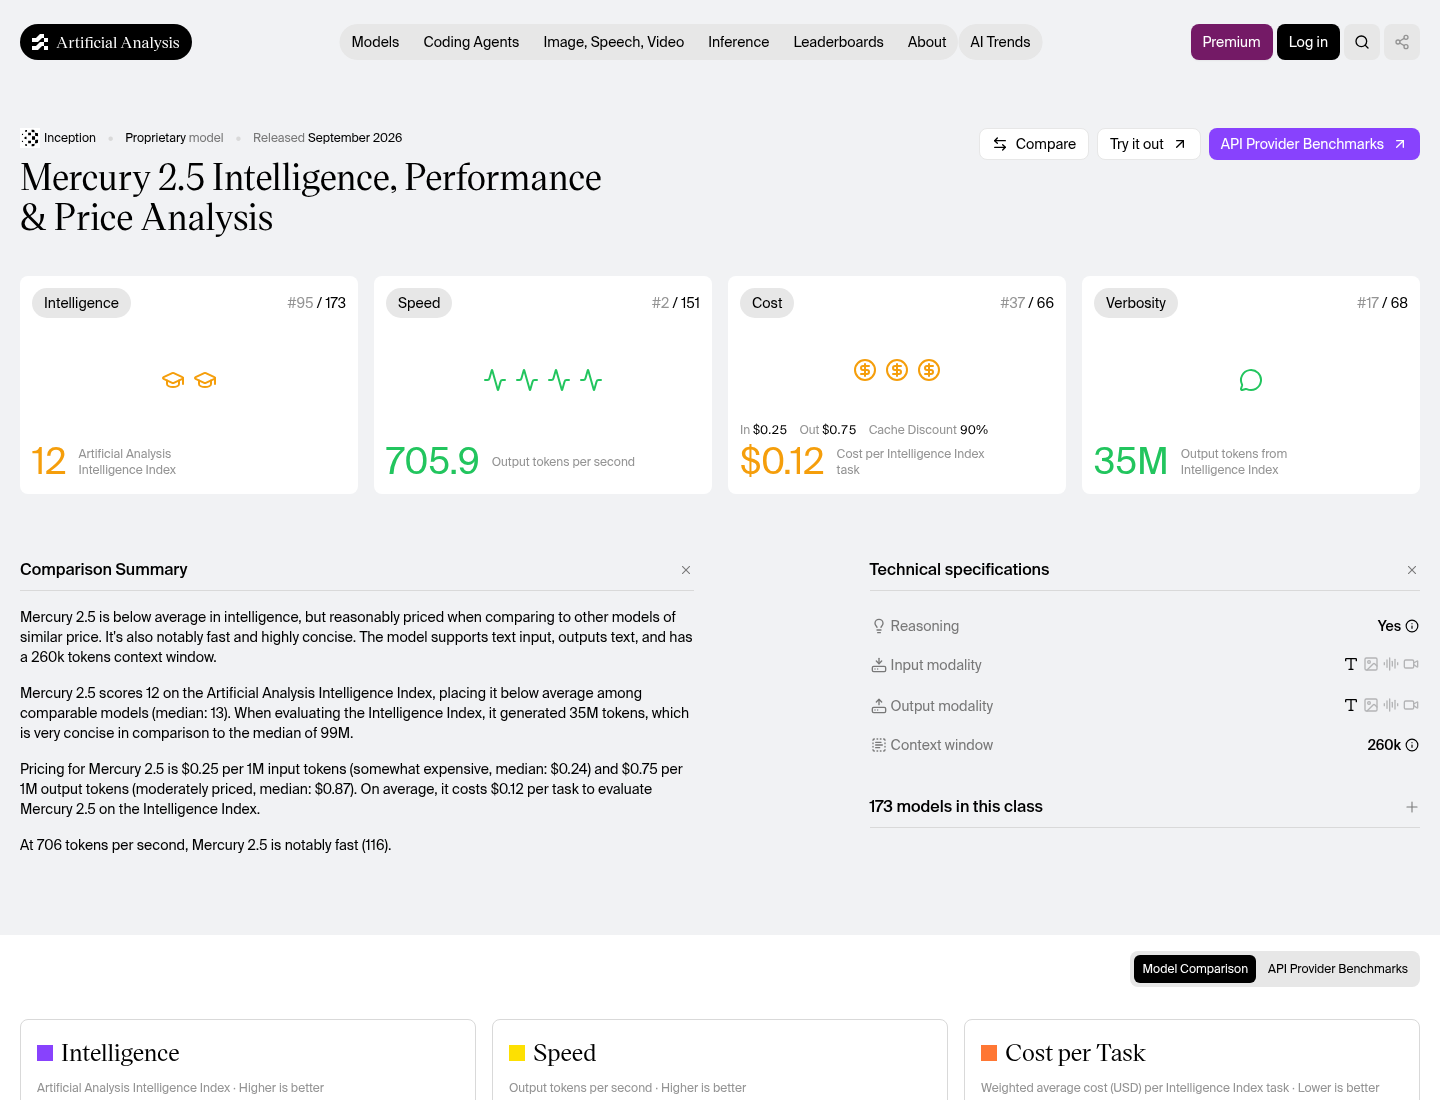
Biaya token murah belum tentu menurunkan tagihan total
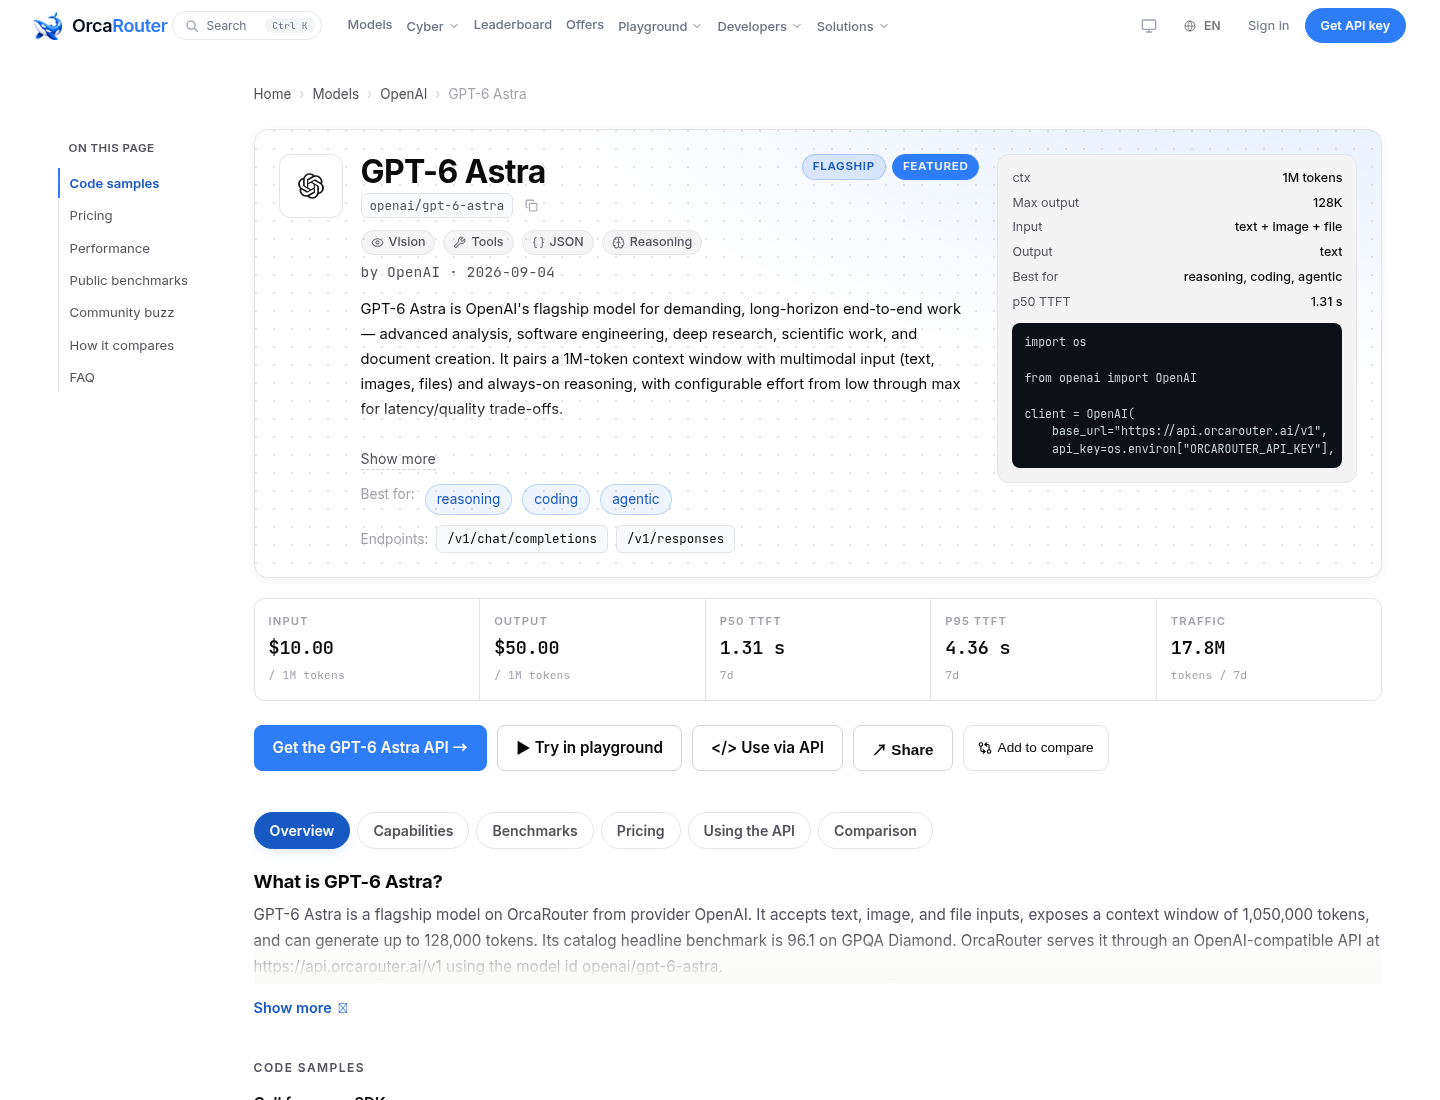
Harga per token hanya satu bagian dari biaya penggunaan. Jika Mercury 3 memerlukan beberapa percobaan, eskalasi ke model lain, atau tinjauan manusia sebelum jawaban dapat dipakai, pengeluaran dan waktu kerja tambahan bisa menghapus penghematan awal. Sebaliknya, model premium tidak otomatis menjadi pilihan terbaik untuk tugas sederhana yang sudah ditangani dengan baik oleh model AI termurah. GPT-6 Astra memperlihatkan mengapa perbandingan perlu mempertimbangkan tingkat kemampuan: model itu memiliki lima tingkat upaya, dengan skor yang bergerak dari 46 hingga 53; jadi pekerjaan tertentu mungkin tidak membutuhkan pengaturan tertinggi. Biayanya disebut sekitar 28 kali lipat dibanding Mercury 3, tetapi angka itu bukan alasan untuk memakai model yang lebih murah tanpa pengujian. Uji alur kerja Anda sendiri: ukur ketepatan, jumlah keluaran yang perlu diperbaiki, dan biaya keseluruhan untuk memperoleh hasil yang layak.