
Kemajuan terukur, bukan bukti bahwa riset sudah bisa diotomatisasi
Agen AI riset adalah sistem yang dapat menjalankan rangkaian pekerjaan penelitian, seperti membaca bahan, menulis atau menguji kode, dan memeriksa eksperimen, dengan campur tangan manusia yang terbatas. Laporan OpenAI pada 18 November 2026 mengukur sejauh mana agen internalnya mempercepat riset, dan temuannya menunjukkan kemajuan yang berarti—namun tidak merata. Keberhasilan menuntaskan tugas riset menengah yang diperkirakan memerlukan dua hingga empat jam kerja manusia naik dari 23 persen pada Maret menjadi 46 persen pada Oktober 2026. Untuk tugas berdurasi empat hingga delapan jam, angkanya meningkat dari 13 menjadi 35 persen. Angka 46 persen patut diperhatikan, tetapi bukan bukti bahwa agen dapat menggantikan peneliti. Itu adalah hasil pengukuran internal untuk jenis tugas tertentu, bukan ukuran universal bagi mutu atau kebenaran penelitian. Pembaca sebaiknya melihatnya sebagai tanda kemajuan, bukan lampu hijau untuk menyerahkan seluruh proses ilmiah kepada mesin.
Pola keberhasilan OpenAI memperjelas batas tersebut: agen internalnya berhasil 79 persen saat memantau pelatihan model dan 72 persen saat menjawab pertanyaan teknis, tetapi hanya 35 persen saat meluncurkan pelatihan dan 25 persen saat menulis kode infrastruktur inferensi. Kemampuan yang timpang seperti ini membuat satu skor keseluruhan berpotensi menyesatkan. Agen bisa membantu pekerjaan berulang, misalnya menguji kode atau memindai kumpulan data besar, tetapi peninjauan manusia tetap diperlukan agar keputusan arsitektur dan hasil akhir tidak bermasalah. Bagi pengembang, pekerja digital, dan mahasiswa, manfaat praktisnya adalah mempercepat sebagian pekerjaan—bukan menghapus kebutuhan memahami serta memeriksa hasilnya.
Klaim Faraday menuntut uji yang bisa diperiksa
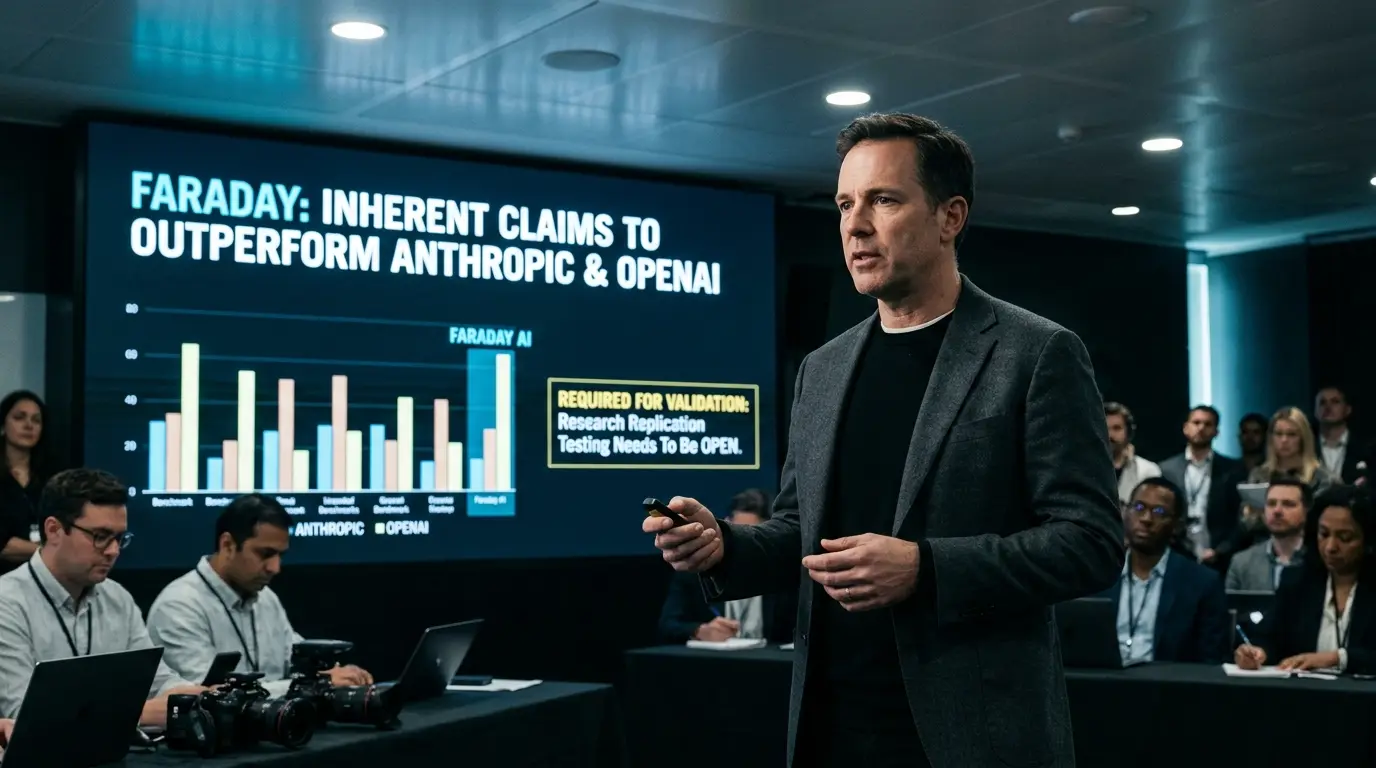
Faraday, agen rekan riset yang diluncurkan laboratorium Inherent, dirancang untuk membantu membaca literatur, memilih eksperimen, dan menguji apakah temuan ilmiah dapat direplikasi. Inherent mengklaim Faraday mengungguli Claude Opus 4.8 dari Anthropic dan GPT-5.5 dari OpenAI dalam tugas replikasi makalah ilmiah. Klaim itu menarik, tetapi belum cukup untuk menetapkan Faraday sebagai rekan kerja ilmiah yang lebih unggul. Inherent belum membuka dataset evaluasi, jumlah makalah yang diuji, variasi bidang ilmu, atau tingkat kegagalan eksperimennya. Tanpa informasi tersebut, pihak luar tidak bisa menilai apakah hasilnya berlaku luas atau hanya muncul pada pilihan uji tertentu. Replikasi riset AI justru harus tunduk pada standar yang hendak ditegakkannya: metode dapat diperiksa, hasil dapat diuji ulang, dan kegagalan dilaporkan, bukan disembunyikan di balik angka terbaik.
Perbandingan juga perlu mengurai kontribusi model dasar dan perangkat pendukungnya. Faraday menggunakan model Qwen 3.6 berukuran 27 miliar parameter, tetapi kemampuan agen tidak ditentukan oleh model saja. Sistem yang mengatur alat, memori, dan pengawasan—sering disebut harness—dapat mengubah hasil secara besar. Uji Nvidia yang dikutip dalam materi sumber menunjukkan sebuah model meraih skor 100 persen pada ARC-AGI-3 dengan dukungan supervisor dan memori khusus, lalu turun menjadi 30 persen tanpa dukungan itu. Karena itu, evaluasi kemampuan AI yang adil harus mengungkap konfigurasi sistem, prosedur pengujian, dan hasil lengkap, bukan hanya skor pemenang. Sampai uji Faraday dapat direplikasi secara independen, klaim keunggulannya lebih tepat diperlakukan sebagai hipotesis yang perlu dibuktikan.
Transparansi dan pengawasan adalah syarat kemajuan
Pengukuran internal OpenAI juga menunjukkan bahwa penggunaan agen oleh para penelitinya meningkat. Pada Oktober 2026, median penggunaan per peneliti tercatat setara 2.400 dolar AS per hari, naik 62 persen dari September; kelompok pengguna teratas mencapai 23.000 dolar AS per hari, naik 105 persen. Angka penggunaan itu menggambarkan ketergantungan yang bertambah, bukan dengan sendirinya membuktikan mutu riset. Laporan tersebut juga menyebut jam kerja terdokumentasi di bidang keselamatan dan penyelarasan meningkat 77 persen dari Januari hingga September, didorong perekrutan baru dan pergeseran fokus setelah insiden Hugging Face pada Juli 2026. OpenAI menyatakan akan terus memantau metrik internal dan memperluas pelaporan publik tentang percepatan riset AI. Langkah itu layak dinilai dari keterbukaan data dan kemampuan pihak luar menguji temuannya, bukan dari janji pelaporan semata.
Bagi lembaga riset dan universitas, agen dapat mengurangi pekerjaan rutin, tetapi otomatisasi tanpa jejak audit berisiko membuat kesalahan sulit ditemukan. Kode, versi perangkat lunak, parameter eksperimen, sumber data, serta perubahan yang dilakukan agen perlu dicatat. Pengujian Faraday semestinya membuka metode dan repositori yang relevan, melaporkan kegagalan, serta mengundang evaluasi pihak ketiga. Pengawasan ilmuwan manusia juga harus tetap ada untuk memeriksa halusinasi, menjaga integritas bukti, dan mencegah data sensitif tersingkap. Kesimpulannya, capaian OpenAI menandakan agen mulai berguna untuk tugas riset menengah, tetapi angka keberhasilan tidak menghapus batas kemampuan maupun tanggung jawab peneliti. Klaim Faraday dan sistem serupa baru pantas menjadi dasar keputusan setelah diuji secara terbuka, direplikasi secara independen, dan diawasi manusia.