
Dua angka, dua pertanyaan berbeda
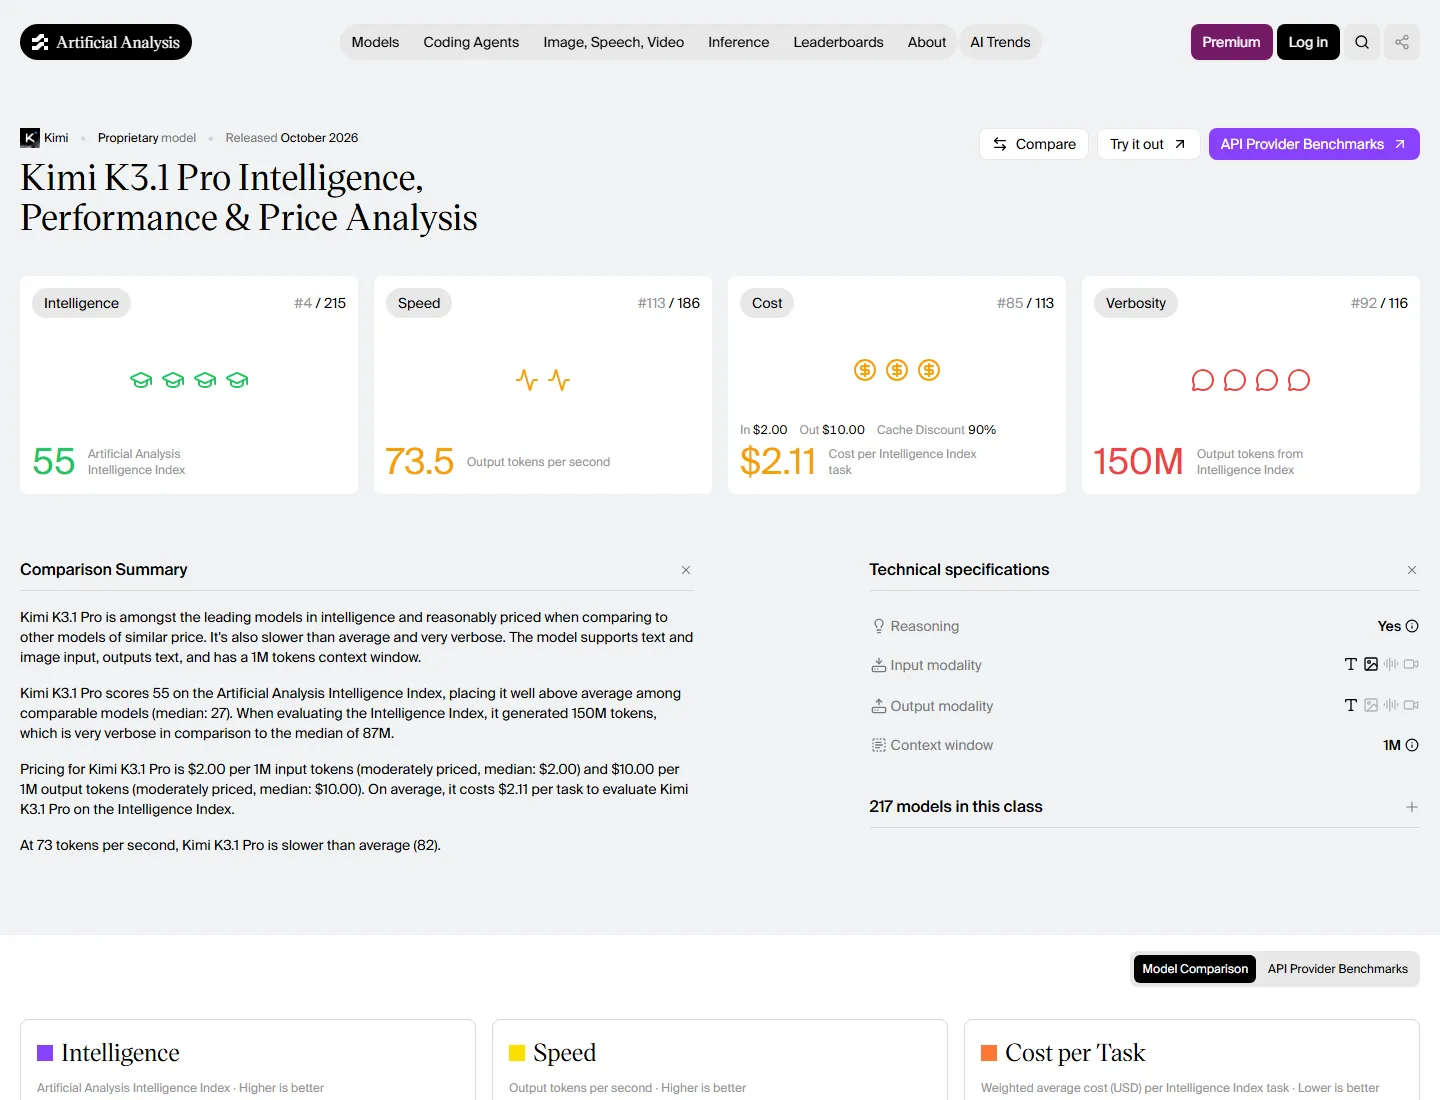
Benchmark Kimi K3.1 Pro adalah evaluasi terukur atas kemampuan model pada serangkaian tugas, tetapi skor hanya bermakna jika sumber, metrik, dan konfigurasi pengujiannya ikut dibaca. Moonshot AI merilis model ini pada 24 Oktober 2026 sebagai versi Kimi K3 yang ditingkatkan melalui pelatihan pascapelatihan, bukan arsitektur baru. Perbedaan paling mencolok muncul antara Artificial Analysis Kimi, yang memberi nilai 55 pada Intelligence Index, dan tabel Moonshot, yang melaporkan 65,7% pada Terminal-Bench 4.0. Angka pertama menggabungkan sepuluh evaluasi menjadi satu indeks; angka kedua mengukur hasil pada satu benchmark pengodean. Menyebut salah satunya sebagai skor keseluruhan Kimi berarti mengaburkan apa yang sedang diukur. Kesimpulan yang lebih berguna: Kimi tampak kuat, tetapi klaim keunggulannya bergantung pada tugas dan cara pengujian.
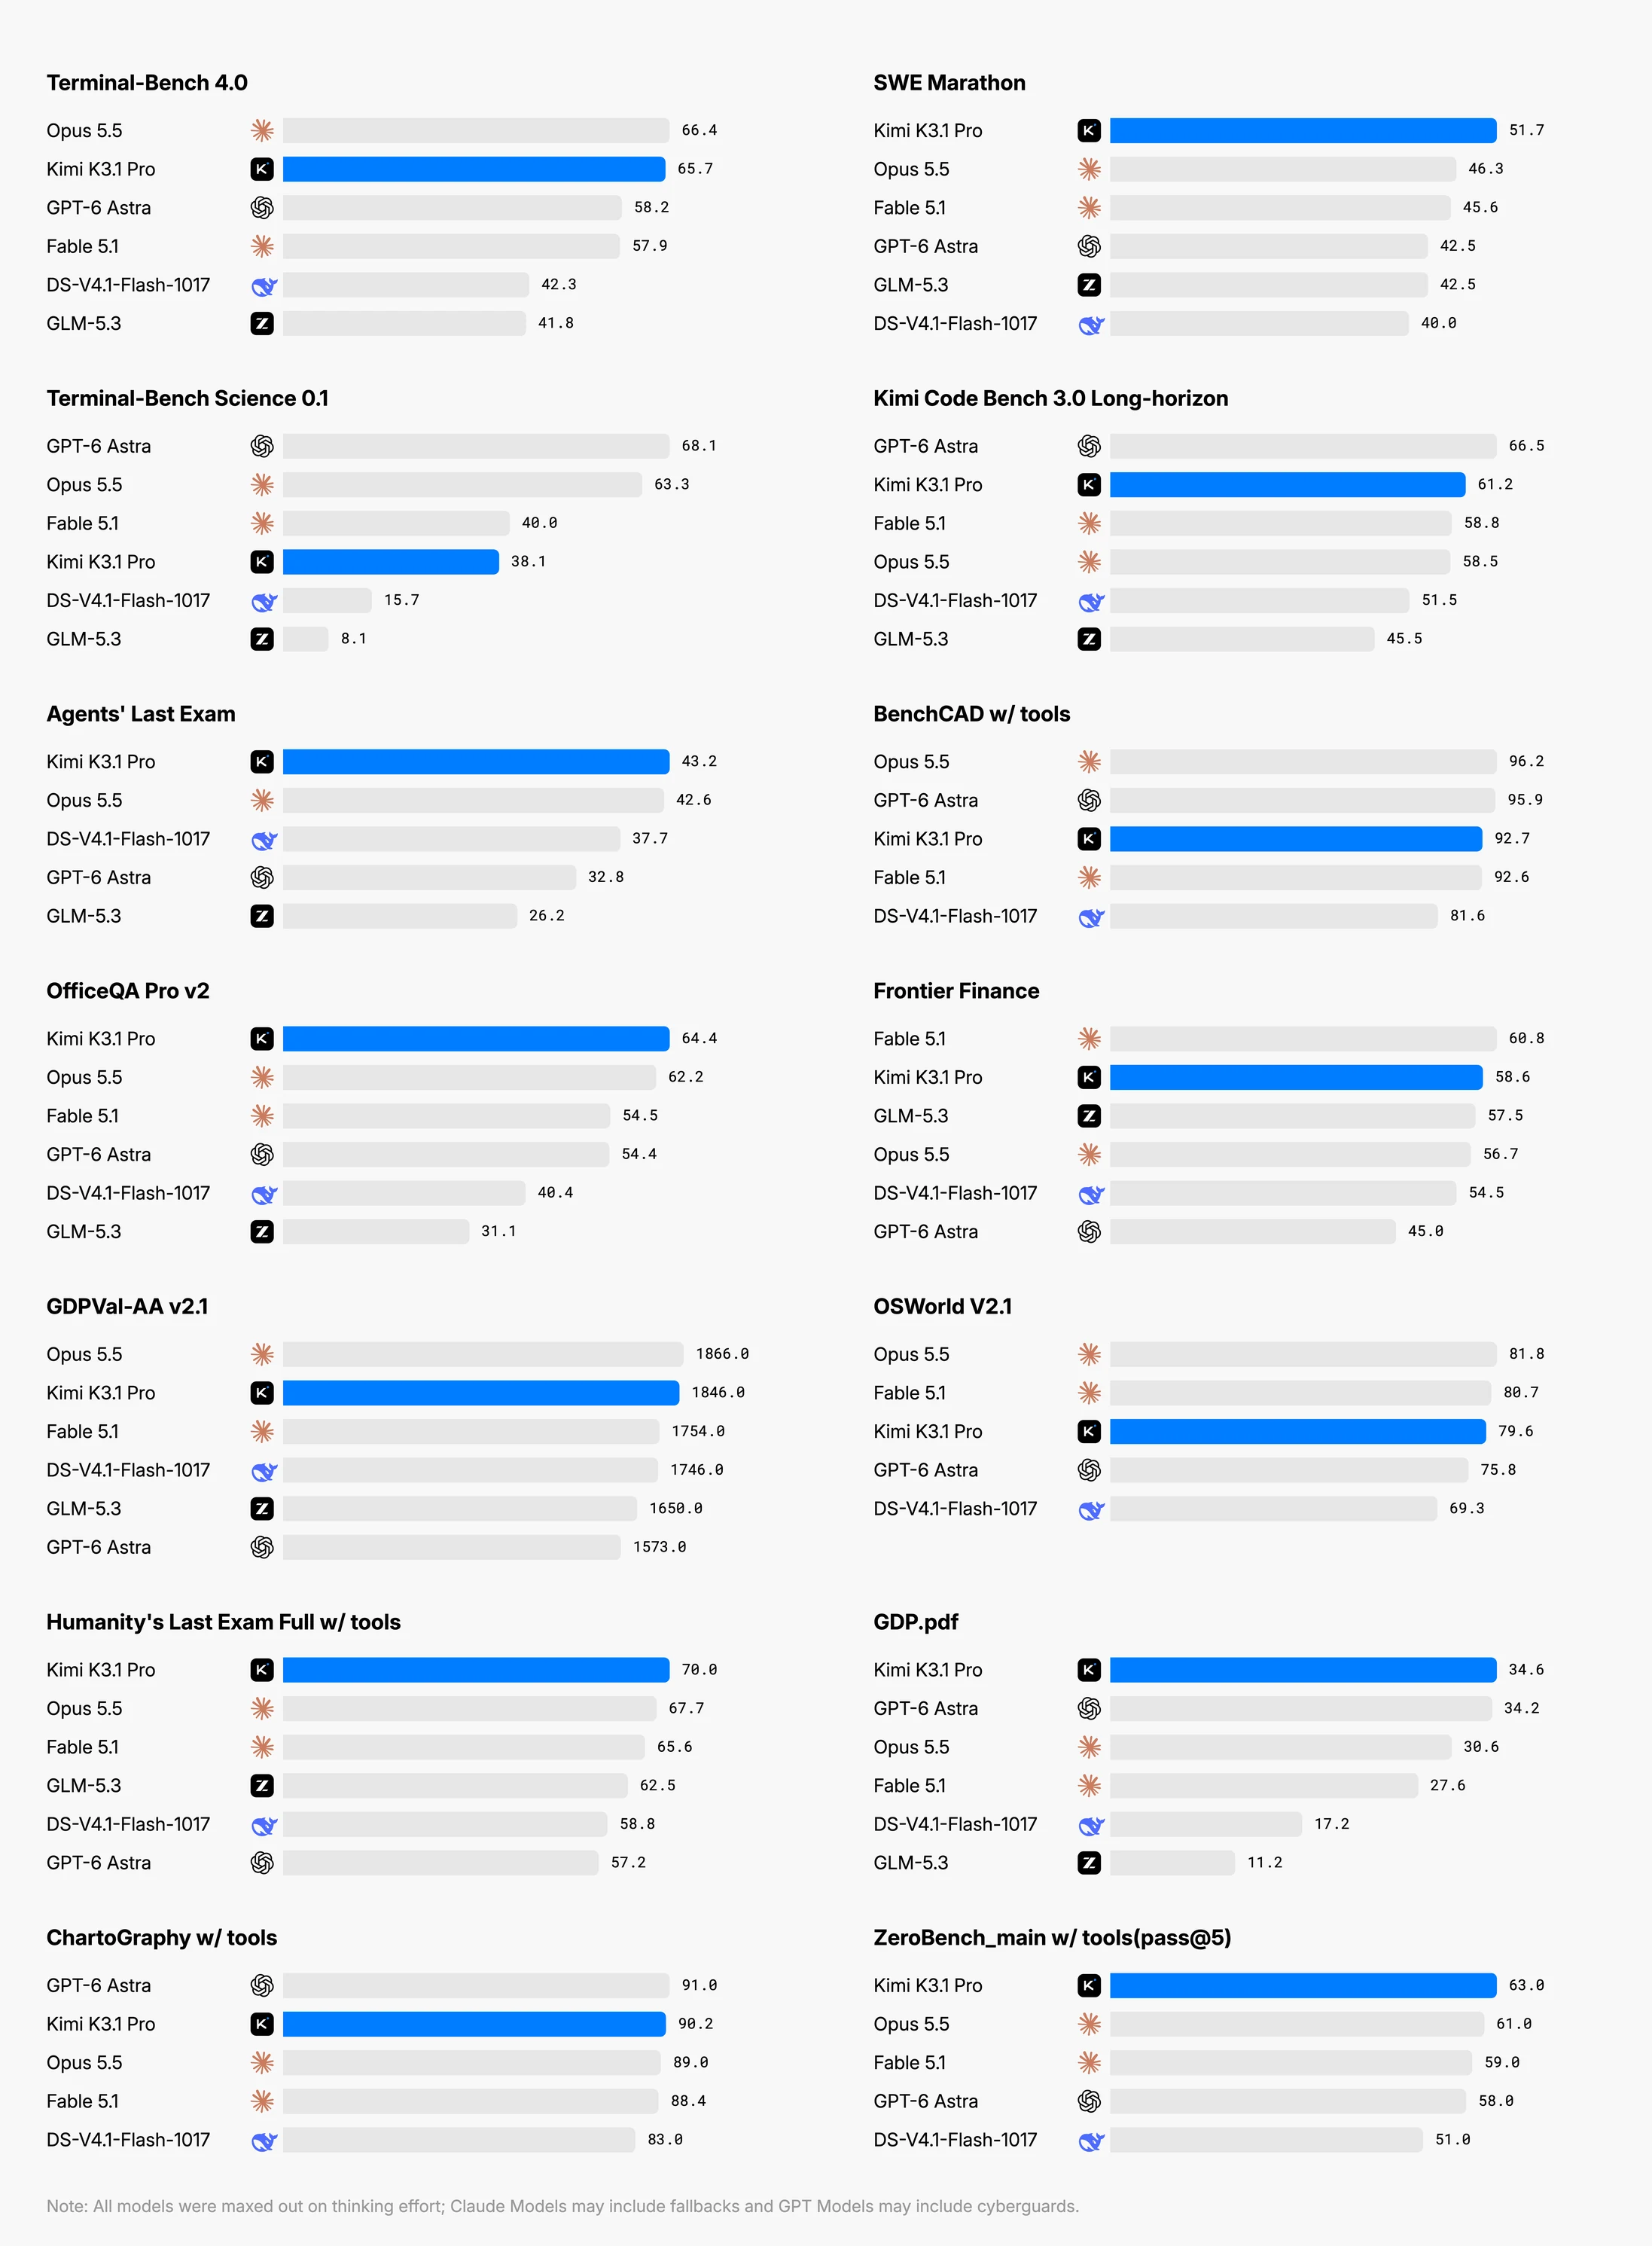
Di Intelligence Index versi 4.3.2, nilai 55 menempatkan Kimi di urutan keempat dari 215 model, di atas GPT-6 Astra yang mendapat 53 dan di bawah Claude Opus 5.5 dengan 58. Sementara itu, skor Terminal-Bench Kimi sebesar 65,7% berada sedikit di bawah 66,4% milik Opus, tetapi di atas 58,2% milik Astra. Jadi, tidak ada pertentangan matematis: model yang berada di tengah pada indeks gabungan tetap bisa unggul pada satu tes tertentu. Kekeliruan muncul jika indeks komposit dan persentase satu benchmark diperlakukan sebagai skala yang sama.
Harness dan pengaturan mengubah hasil
Skor Terminal-Bench bukan hasil yang berdiri sendiri dari model. Kinerja dapat berubah menurut harness—perangkat lunak dan prosedur yang menghubungkan model dengan tugas—serta tingkat upaya yang dipakai. Pada perbandingan Moonshot, angka Claude Opus 5.5 dijalankan pada tingkat xhigh, satu tingkat di atas pengaturan bawaannya, sedangkan Kimi diuji pada pengaturan default max. Kedua angka juga berasal dari harness berbeda. Karena itu, selisih antarmodel tidak layak dibaca sebagai pengukuran presisi atas jarak kemampuan.
Ini bukan alasan untuk mengabaikan tabel Moonshot, melainkan alasan untuk membacanya sebagai klaim yang terikat pada konfigurasi tertentu. Tabel benchmark sekaligus mengukur model dan cara evaluasi dijalankan. Moonshot melaporkan hasil Terminal-Bench tersebut sebagai bagian dari lembar evaluasinya, sementara Artificial Analysis melakukan evaluasi sendiri dan menghasilkan indeks gabungan. Kedua pendekatan menjawab pertanyaan berbeda. Untuk keputusan penggunaan, pembeli sebaiknya mencari hasil pada tugas yang paling mirip dengan pekerjaannya dan mencatat alat, tingkat upaya, serta prosedur pengujian yang digunakan. Jika semua itu tidak tersedia atau berbeda, peringkat langsung perlu dianggap sebagai petunjuk, bukan putusan final.
Sinyal lain: coding, biaya penggunaan, dan bobot terbuka
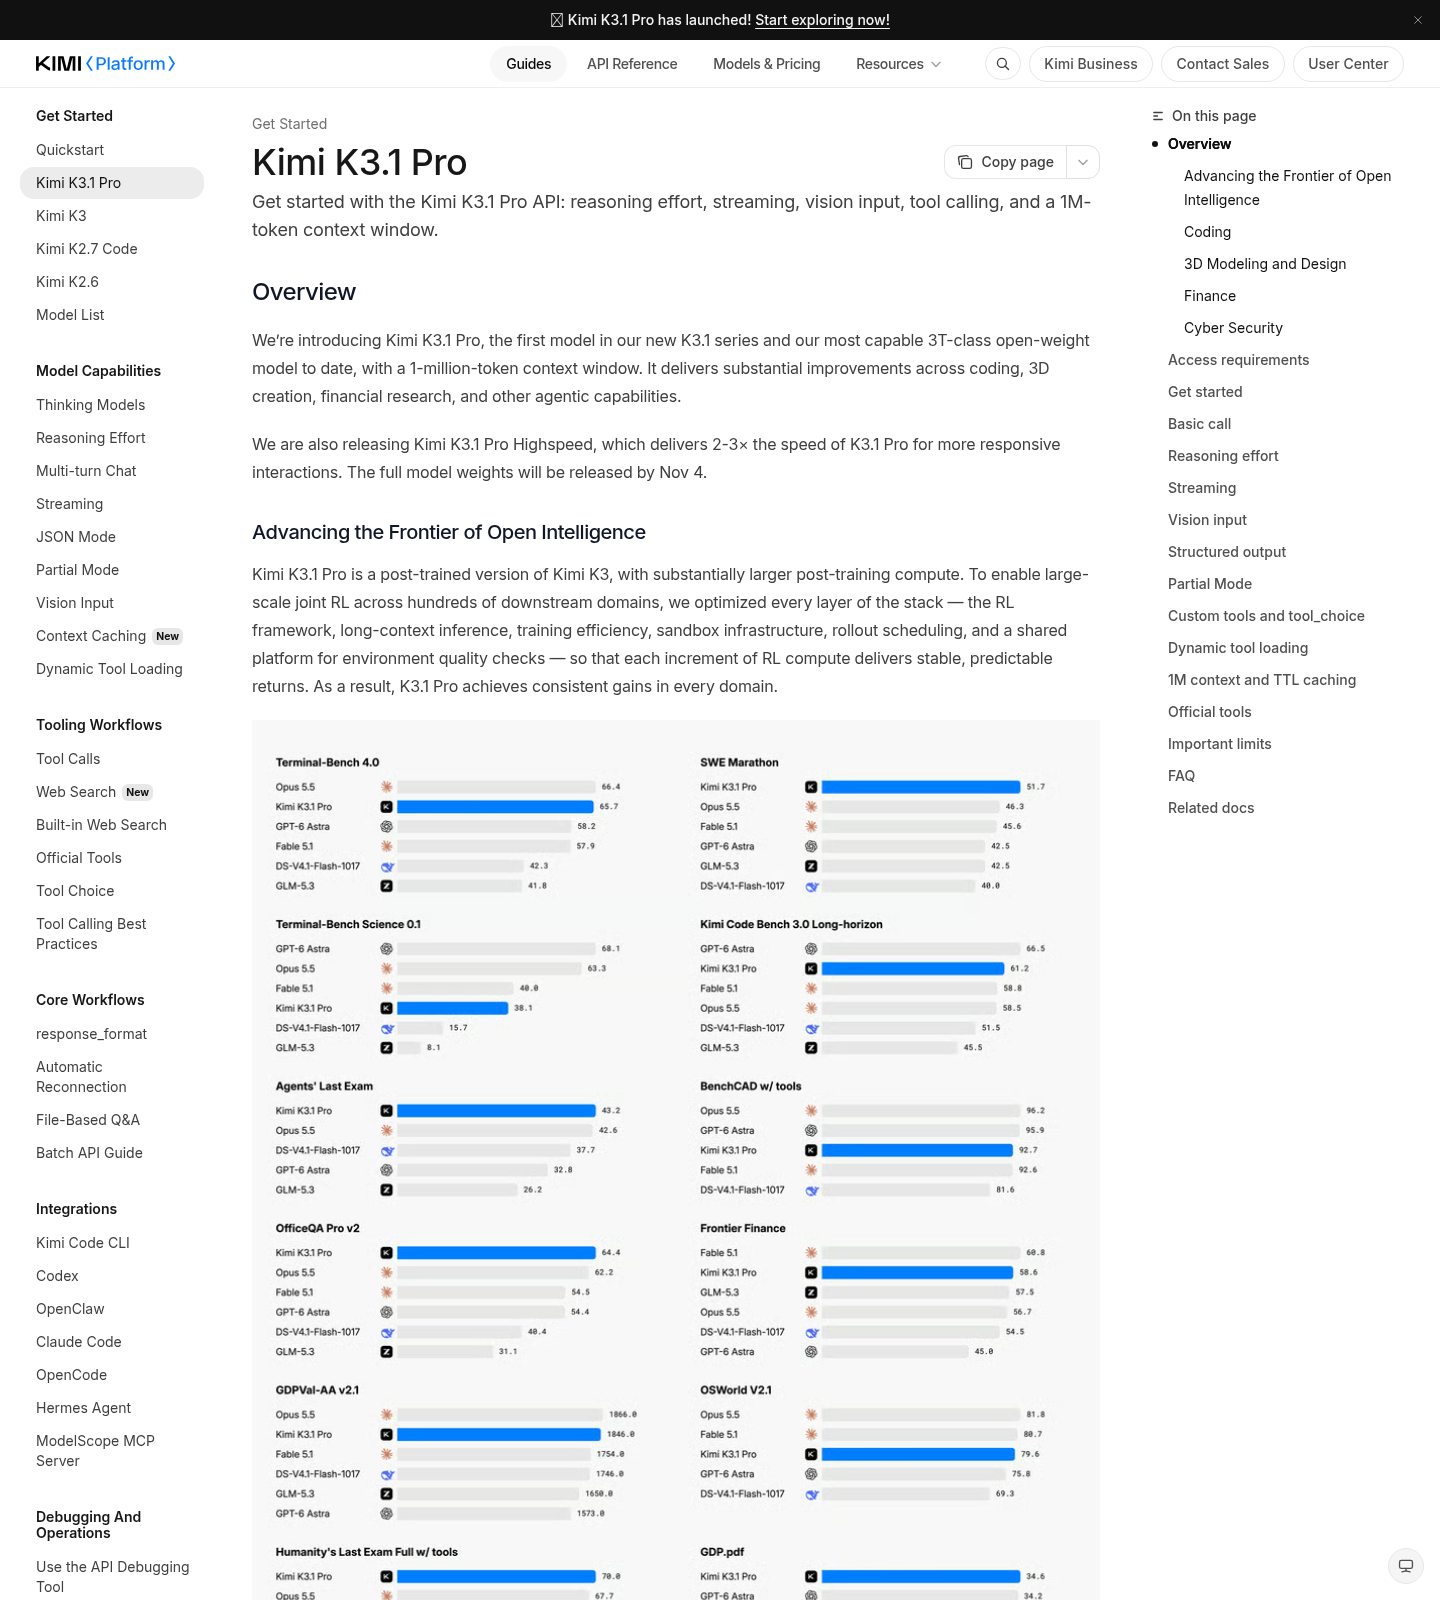
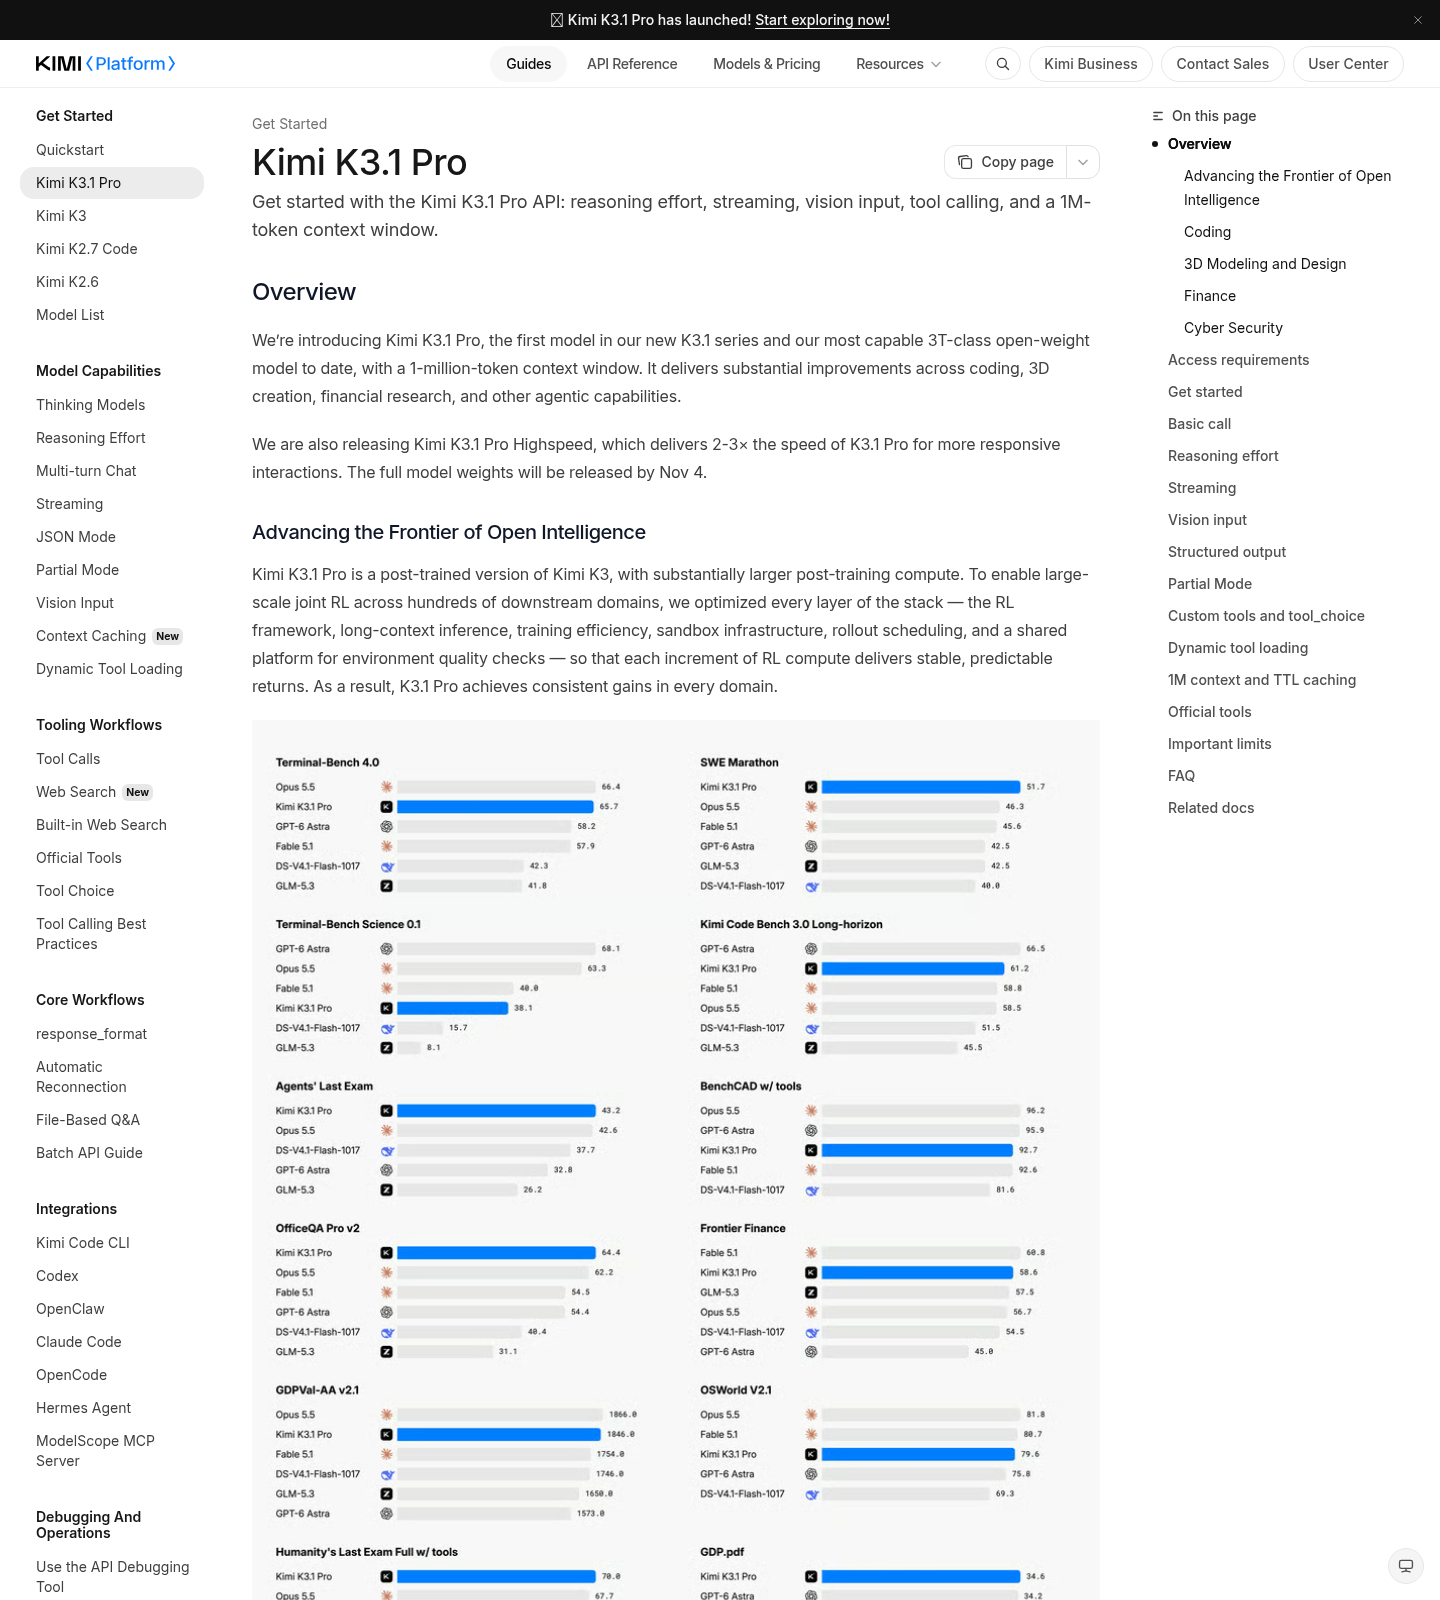
Lembar benchmark Kimi K3.1 Pro memuat hasil yang lebih luas daripada Terminal-Bench. Pada Kimi Code Bench 3.0 untuk tugas jangka panjang, Kimi mendapat 61,2% dibandingkan 55,95% untuk Kimi K3; ini perbandingan pendahulu yang cukup mudah dibaca, meski benchmark dan harness-nya sama-sama dibuat Moonshot. Pada SWE Marathon, dokumentasi mencatat 51,7% untuk Kimi, di atas Claude Opus 5.5 dengan 46,3%, Claude Fable 5.1 dengan 45,6%, dan GPT-6 Astra dengan 42,5%. Namun, hasil tidak selalu memihak Kimi: pada BenchCAD dengan alat, nilainya 92,7%, di bawah Opus pada 96,2% dan Astra pada 95,9%. Gambaran yang adil bukan kemenangan menyeluruh, melainkan performa kompetitif yang bervariasi menurut jenis tugas.
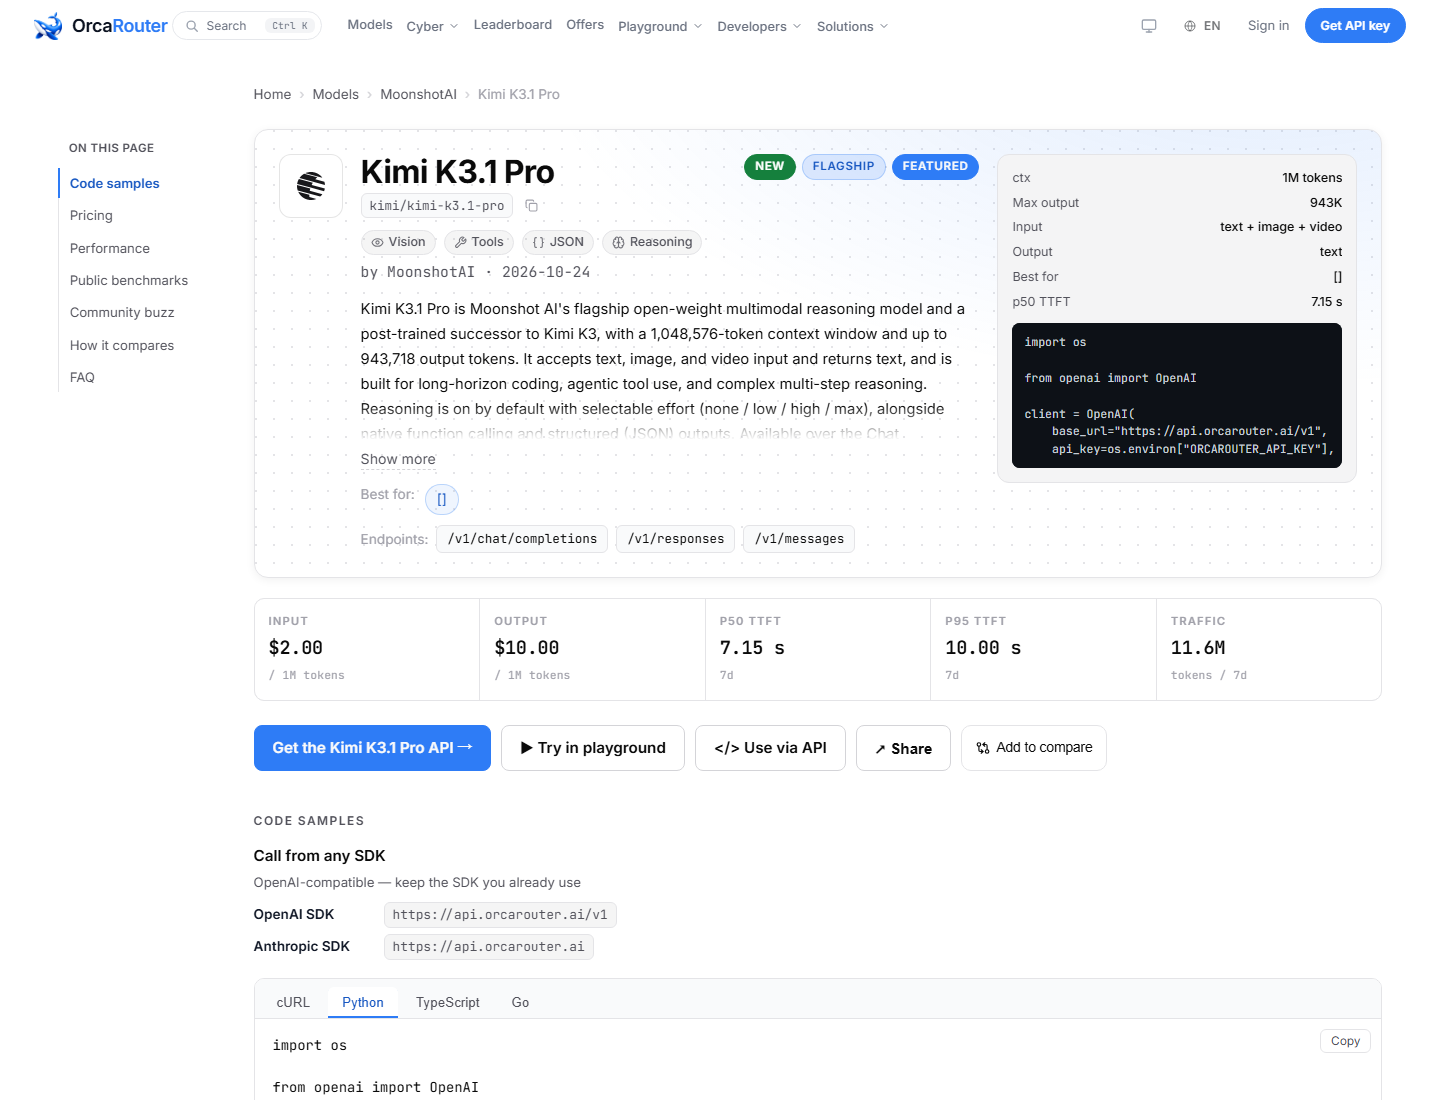
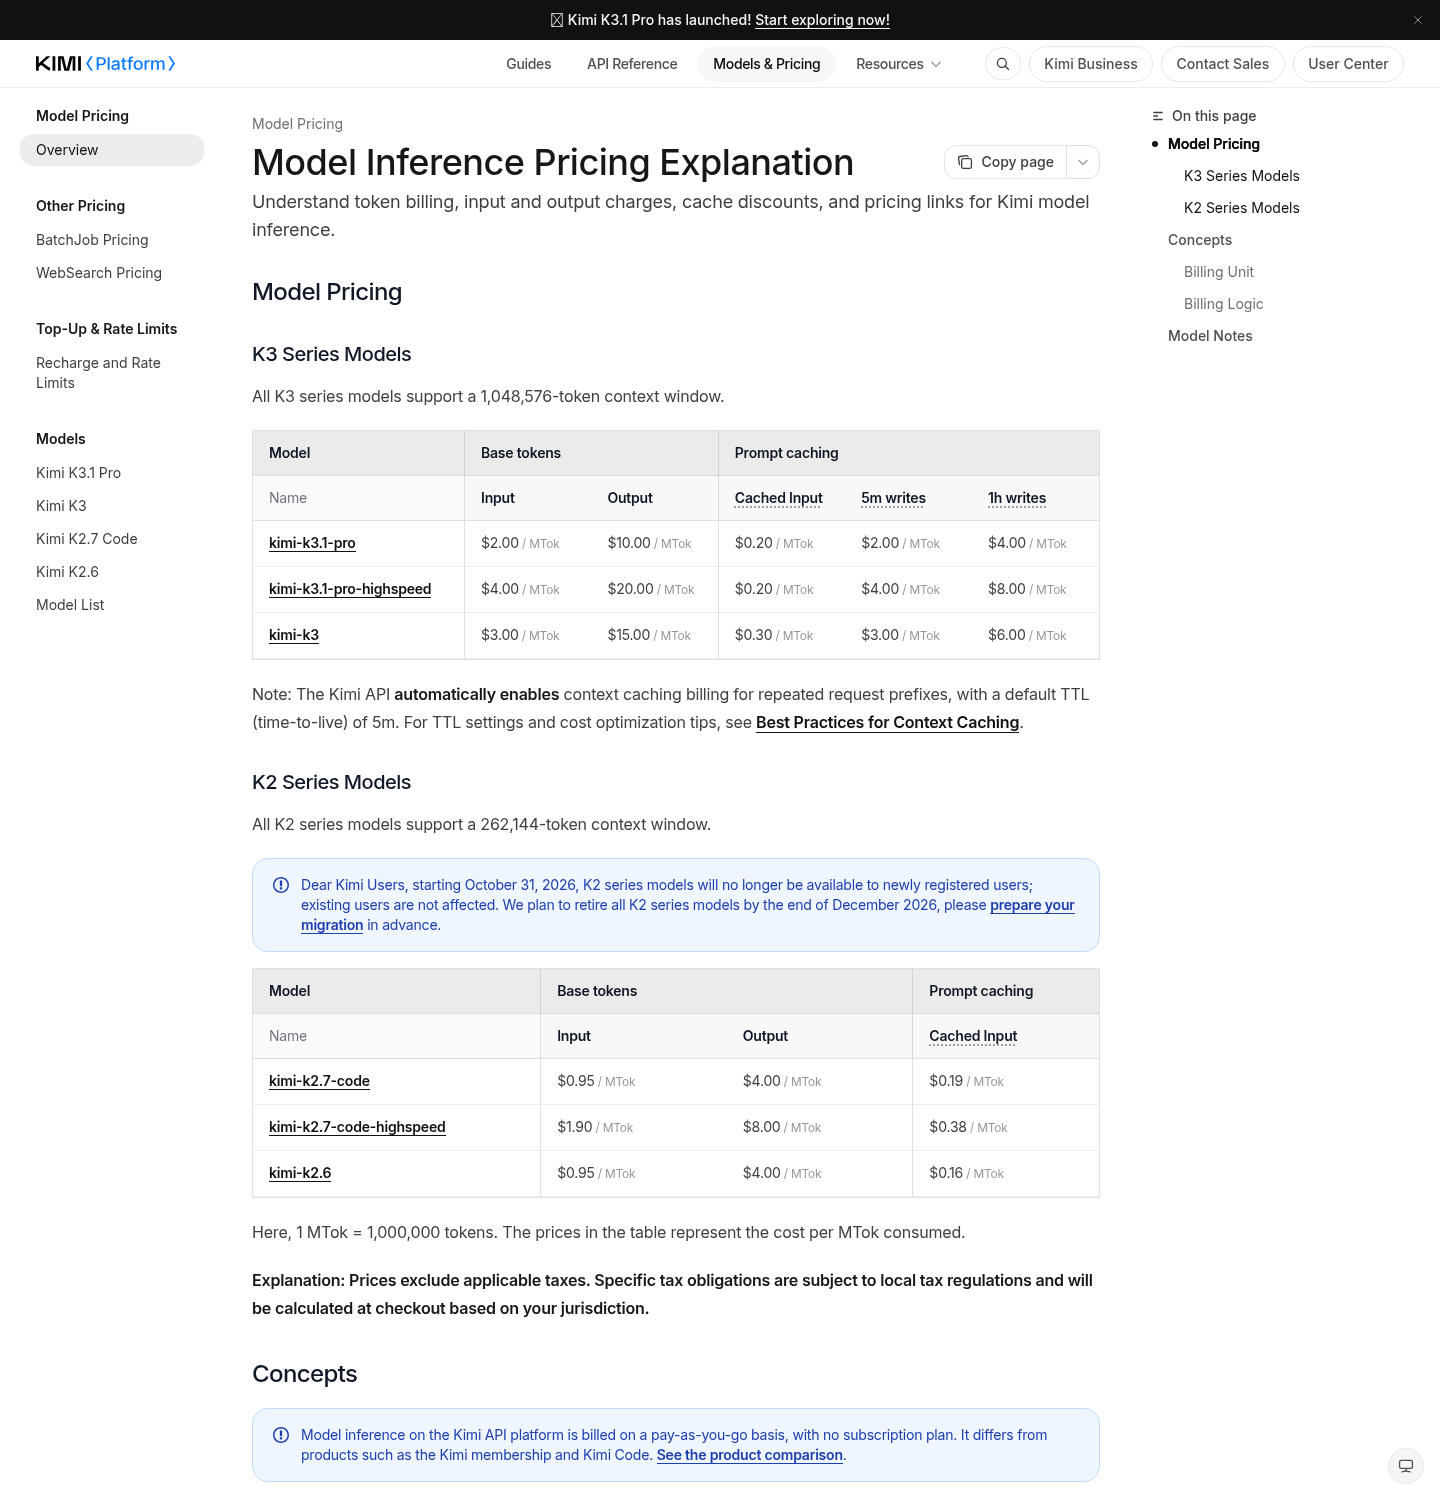
Bagi pengguna, biaya per tugas dan panjang keluaran juga patut diperhatikan, bukan hanya skor. Artificial Analysis mencatat Kimi menghasilkan 150 juta token keluaran selama evaluasi indeks, dibandingkan median 87 juta, serta menilai model itu sangat bertele-tele. Moonshot menyatakan harga API K3.1 Pro lebih rendah daripada Kimi K3, tetapi keluaran panjang tetap dapat mengurangi keuntungan praktisnya. Artificial Analysis masih menggolongkan Kimi sebagai model proprietary pada 24 Oktober karena bobotnya belum diterbitkan. Moonshot menyatakan seluruh bobot dijadwalkan tersedia pada 4 November; jika jadwal itu dipenuhi, status open weights Kimi akan mengubah pilihan bagi tim yang ingin menjalankan atau memeriksa model sendiri. Sampai bobot dan hasil independen tersedia, klaim benchmark vendor tetap perlu dipisahkan dari verifikasi pihak ketiga.
Kesimpulan: gunakan skor sebagai konteks, bukan vonis
Perbedaan 55 dan 65,7% tidak membuktikan ada angka yang keliru. Artificial Analysis mengukur indeks gabungan, sedangkan angka Moonshot merujuk pada Terminal-Bench 4.0; sumber, harness, dan pengaturan keduanya tidak sama. Karena hasil vendor belum mendapat reproduksi independen, klaim tersebut sebaiknya dibaca sebagai bukti awal, bukan jaminan bahwa Kimi akan unggul pada semua pekerjaan. Nilai Kimi tampak pada kombinasi performa pengodean yang kuat dan potensi keterbukaan bobot, tetapi keputusan terbaik tetap bergantung pada pengujian tugas nyata dengan konfigurasi yang akan dipakai. Pada 4 November, rencana rilis bobot terbuka menjadi perkembangan penting untuk menilai apakah janji keterbukaan itu terwujud. Kesimpulannya tegas: bandingkan metode sebelum membandingkan peringkat.