
Konteks panjang menjadi daya tarik utama
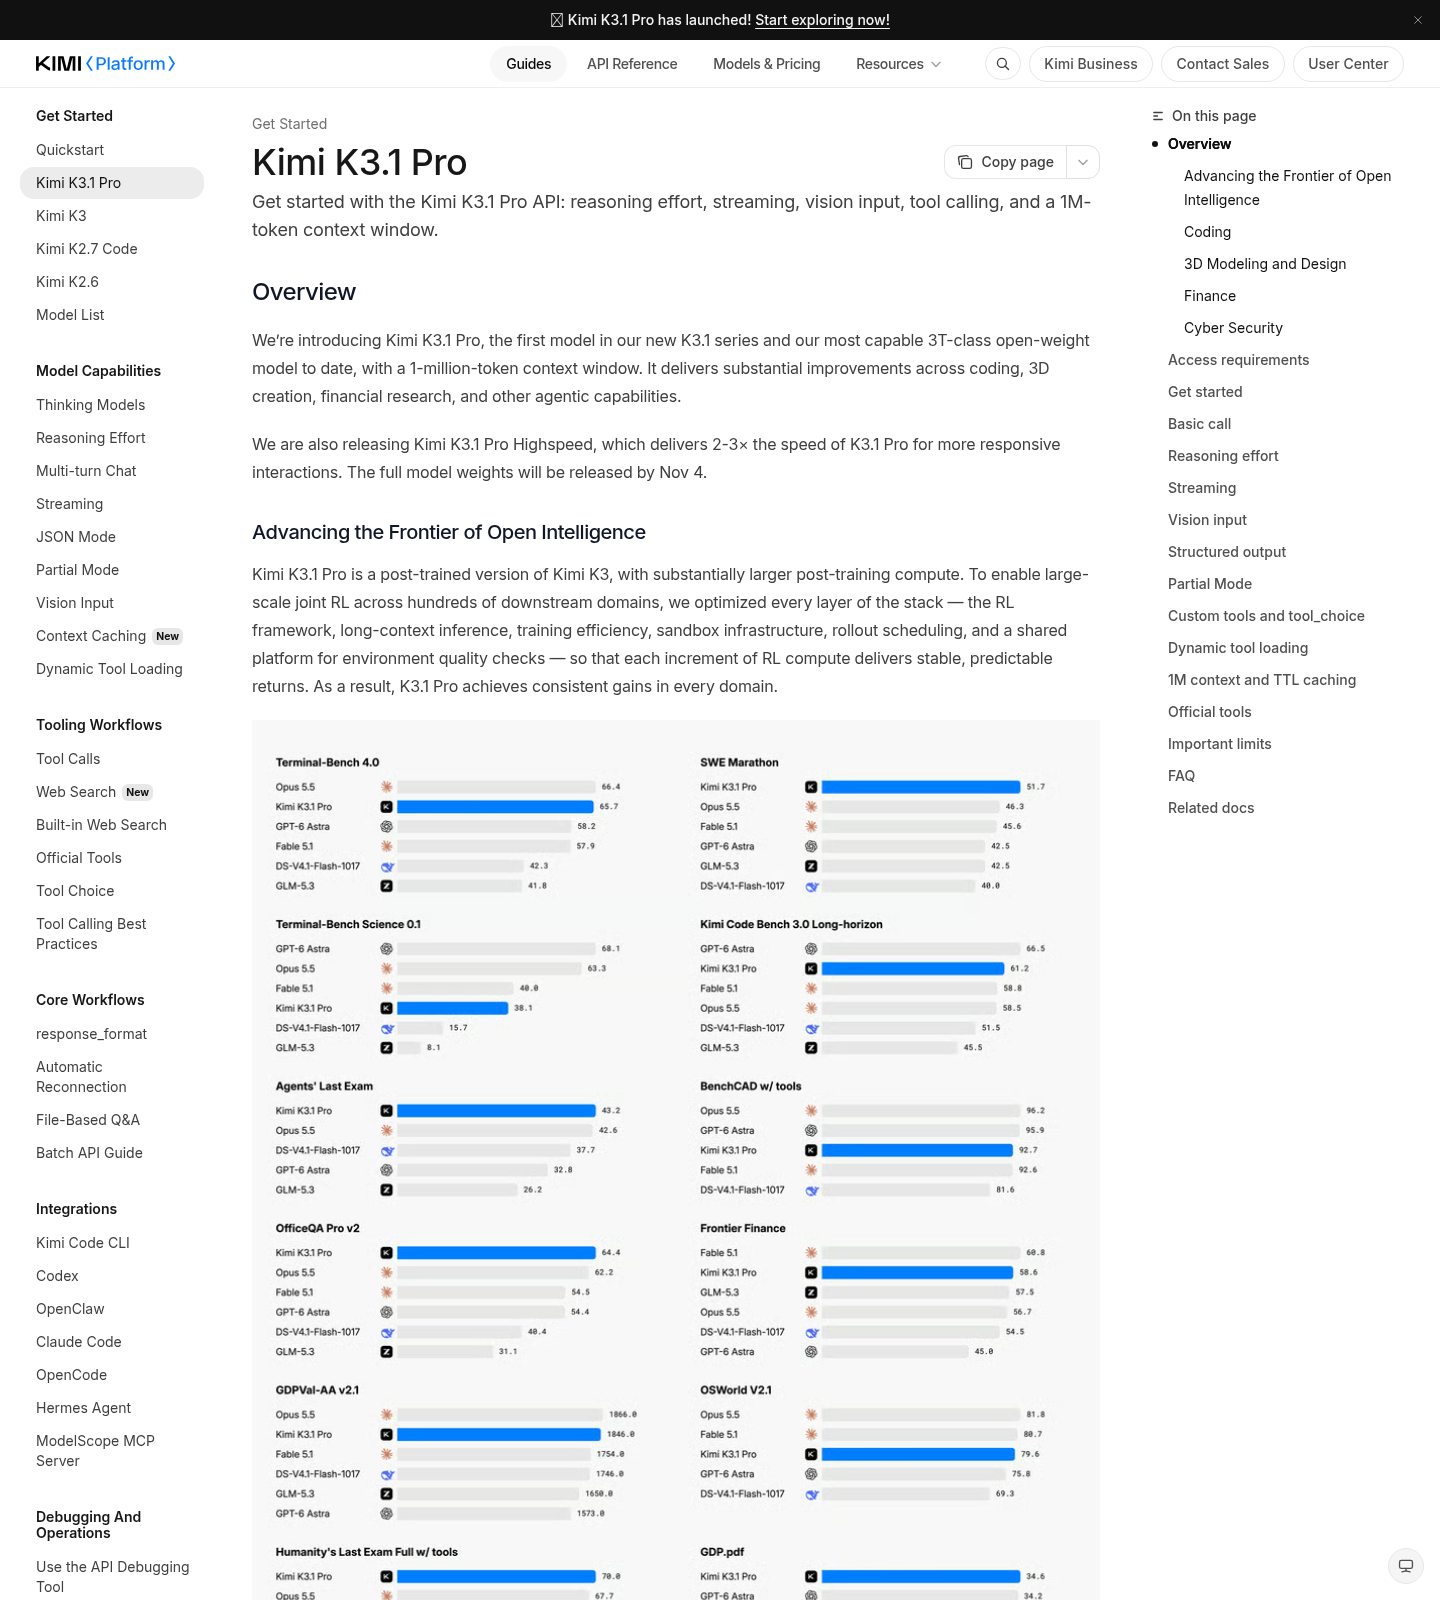
Kimi K3.1 Pro adalah model AI terbuka dari Moonshot yang dirancang untuk memahami konteks panjang, menjalankan tugas bertahap, dan membantu pekerjaan coding maupun pengetahuan. Moonshot AI memperkenalkannya pada 23 Oktober 2026 sebagai penerus Kimi K3, dengan konteks 1 juta token dan arsitektur campuran pakar berskala 2,8 triliun parameter total. Bagi pengguna, konteks sebesar ini berpotensi membantu mengolah dokumen panjang atau menjaga informasi proyek tetap tersedia dalam satu percakapan. Model AI Kimi ini juga sudah dapat dipilih melalui situs dan aplikasi Kimi, Kimi Work, serta Kimi Code; pengembang dapat mengaksesnya lewat API. Namun, kapasitas konteks besar bukan jaminan jawaban selalu tepat. Nilainya bergantung pada kemampuan model memilih informasi yang relevan dan menyelesaikan tugas dengan konsisten.
Pembaruan ini bukan model dasar yang sepenuhnya baru. Moonshot menggambarkannya sebagai hasil post-training Kimi K3: siklus pelatihan lanjutan dengan komputasi lebih besar, yang menargetkan pembelajaran penguatan, penalaran dalam konteks panjang, dan lingkungan sandbox untuk menjalankan kode. Arah tersebut masuk akal: agen AI perlu lebih dari sekadar menghasilkan teks, karena ia harus merencanakan langkah, memakai alat, lalu memeriksa hasil. Moonshot juga mempromosikan kemampuan mengerjakan proyek coding utuh dan tugas pemodelan 3D. Klaim itu menarik, tetapi ukuran konteks saja tidak membuktikan bahwa model dapat menyelesaikan pekerjaan kompleks tanpa kesalahan.
Skor tinggi, tetapi belum mengungguli Opus
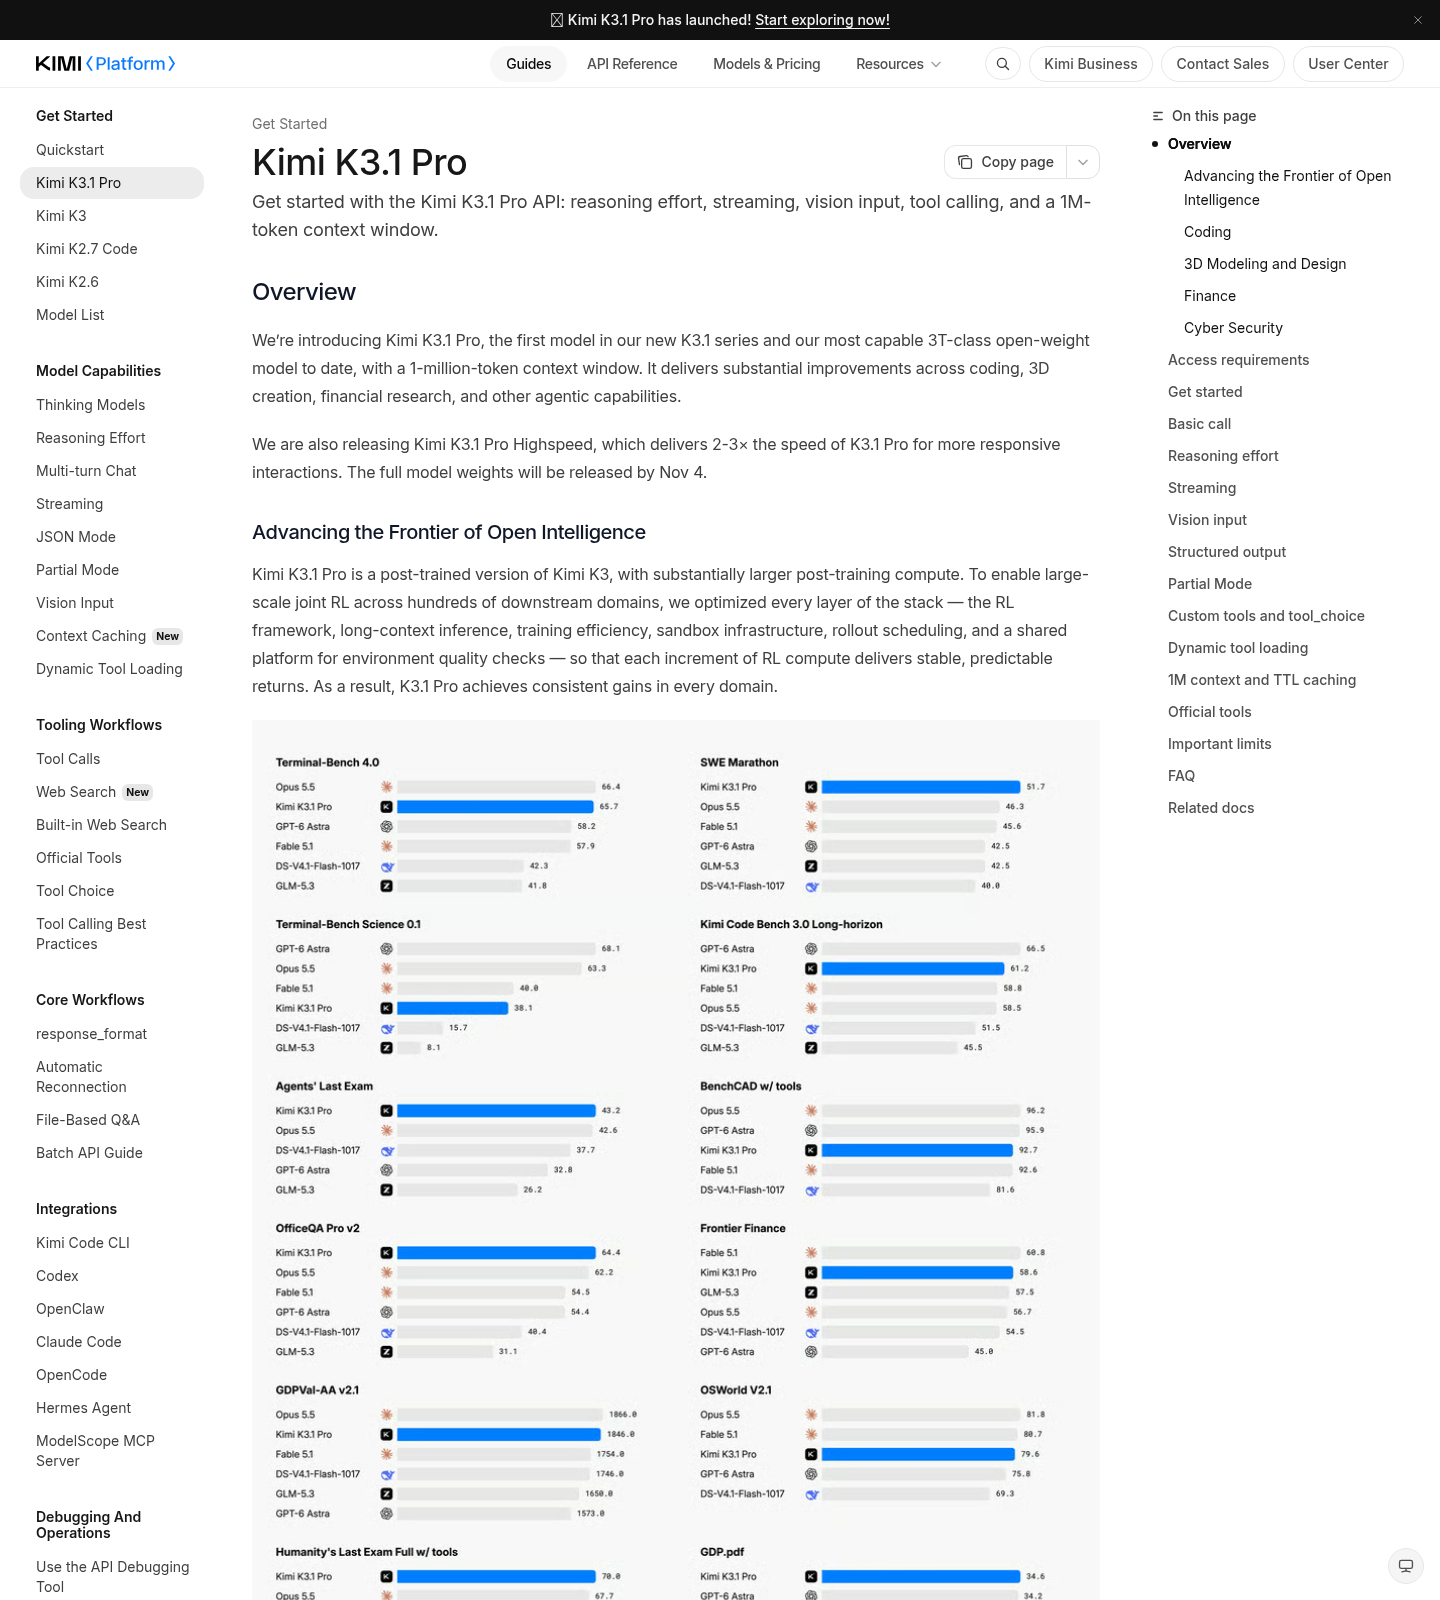
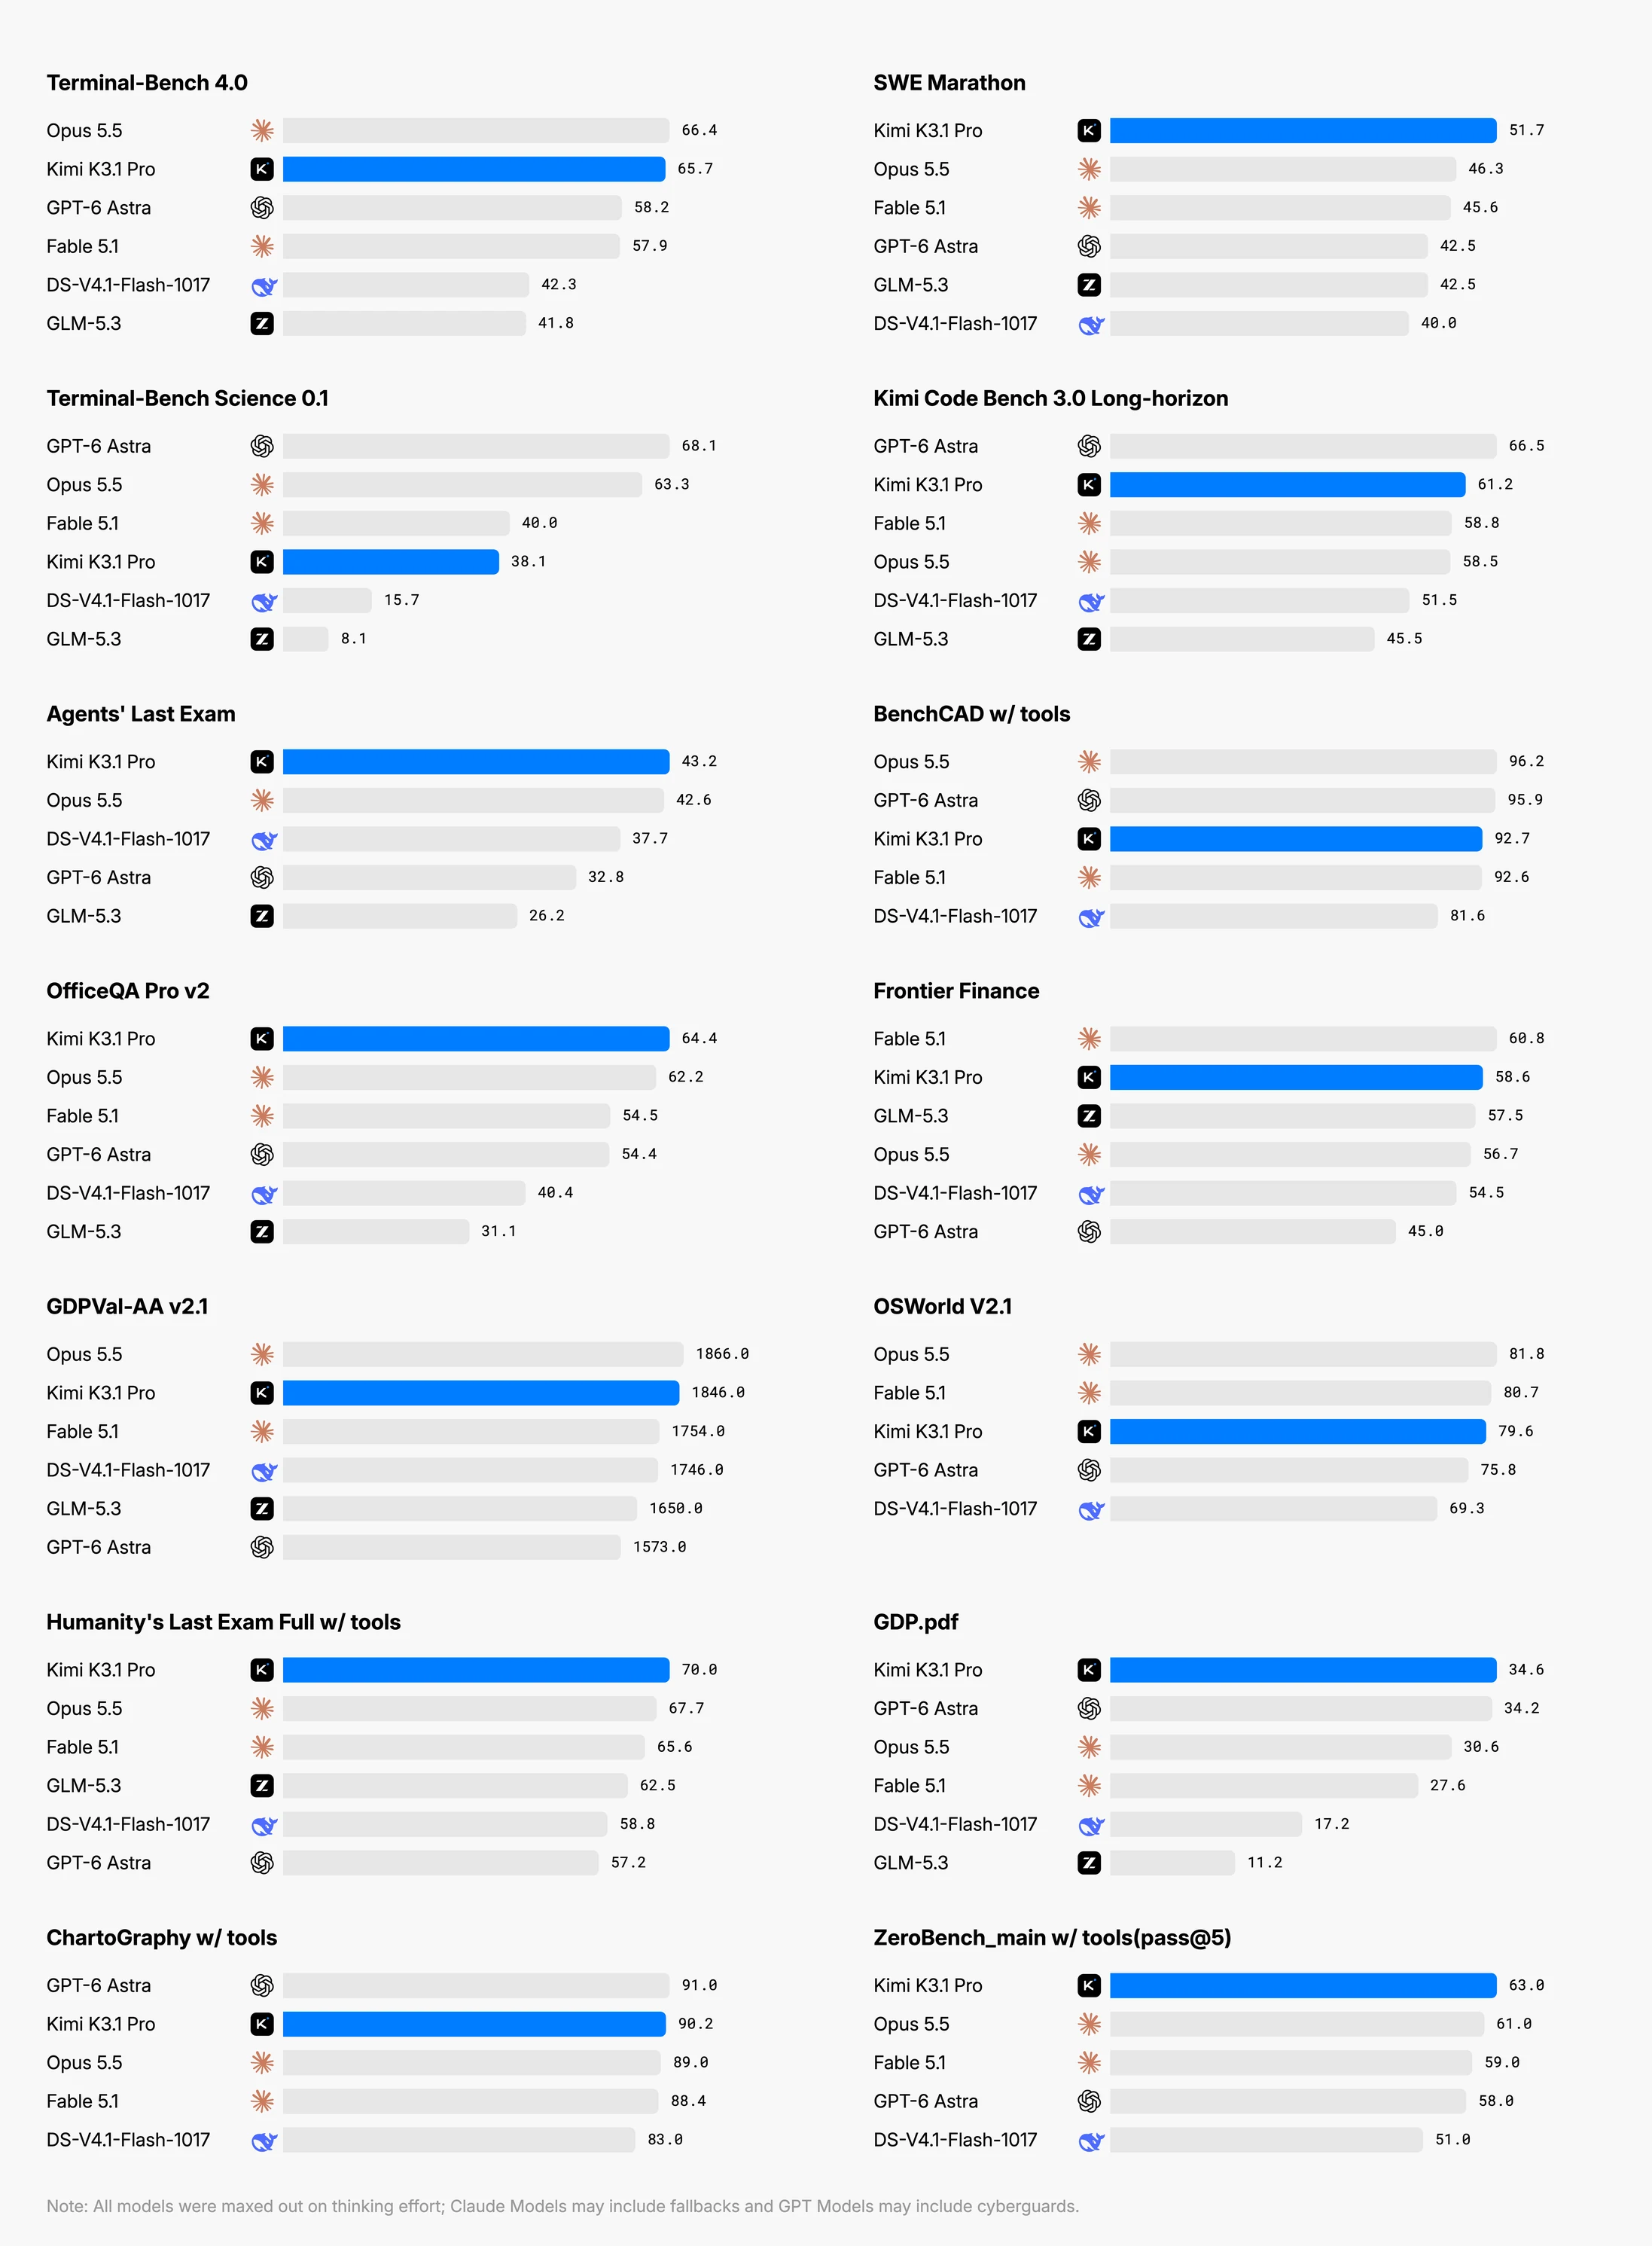
Angka benchmark mendukung klaim peningkatan, meski belum menunjukkan kemenangan menyeluruh. Dalam Terminal-Bench 4.0, yang menguji kemampuan agen menuntaskan tugas melalui terminal komputer, Kimi K3.1 Pro meraih 65,7%, dibanding 66,4% untuk Claude Opus 5.5 dan 58,2% untuk GPT-6 Astra. Selisih tipis dari Opus membuat Kimi layak diperhatikan untuk pekerjaan teknis bertahap, tetapi hasil itu bukan bukti bahwa ia lebih baik pada semua jenis coding. Angka tersebut berasal dari pengujian yang dipublikasikan Moonshot, sehingga pembaca sebaiknya melihatnya sebagai satu titik perbandingan, bukan keputusan akhir tentang mutu model.
Ada pula ukuran yang berbeda: dalam Artificial Analysis Intelligence Index versi 4.3.2, Kimi K3.1 Pro mendapat 55 poin, terpaut tiga poin dari Claude Opus 5.5 yang memperoleh 58 poin. Kedua hasil itu tidak boleh dicampuradukkan: skor 65,7% merujuk pada Terminal-Bench 4.0, sedangkan selisih tiga poin merujuk pada indeks kecerdasan. Bersama-sama, keduanya memberi gambaran model yang kompetitif, bukan pemimpin mutlak. Pengguna yang memilih model untuk agen coding sebaiknya menilai jenis tugas, konsistensi, dan kebutuhan alat, bukan terpaku pada satu angka.
| Ukuran | Kimi K3.1 Pro | Claude Opus 5.5 | Catatan |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7% | 66,4% | Kimi terpaut 0,7 poin persentase |
| Artificial Analysis Intelligence Index 4.3.2 | 55 poin | 58 poin | Kimi terpaut 3 poin |
Bobot terbuka akan menguji nilai jangka panjang
Janji bobot terbuka adalah kabar penting bagi pengembang yang ingin menjalankan model di infrastruktur sendiri, menyesuaikannya, atau memeriksa cara kerjanya. Moonshot menyatakan bobot Kimi K3.1 Pro akan dirilis paling lambat 4 November 2026, tetapi belum menjelaskan lisensinya. Karena itu, label “terbuka” belum cukup untuk menyimpulkan seberapa bebas model boleh digunakan; ketentuan lisensi akan menentukan batas penggunaan dan modifikasi. Sampai bobot benar-benar tersedia dan persyaratannya jelas, klaim keterbukaan masih merupakan janji yang patut ditunggu, bukan manfaat yang sudah bisa dipastikan.
Untuk pengguna biasa, ketersediaan lewat situs, aplikasi, dan alat coding membuat model ini dapat dicoba tanpa menunggu rilis bobot. Namun, keputusan apakah Kimi K3.1 Pro layak dijadikan pilihan utama sebaiknya mengikuti hasil pada pekerjaan nyata: apakah ia mampu mempertahankan konteks, menjalankan rangkaian instruksi, dan menghasilkan kode yang dapat dipakai. Kesimpulannya, Kimi K3.1 Pro adalah langkah maju yang menjanjikan berkat konteks 1 juta token serta peningkatan agen dan coding. Skornya mendekati Claude Opus 5.5, tetapi belum menyalipnya; bobot terbuka dan lisensi yang akan datang menjadi ujian berikutnya.