
Satu keluarga, bukan satu model serbaguna
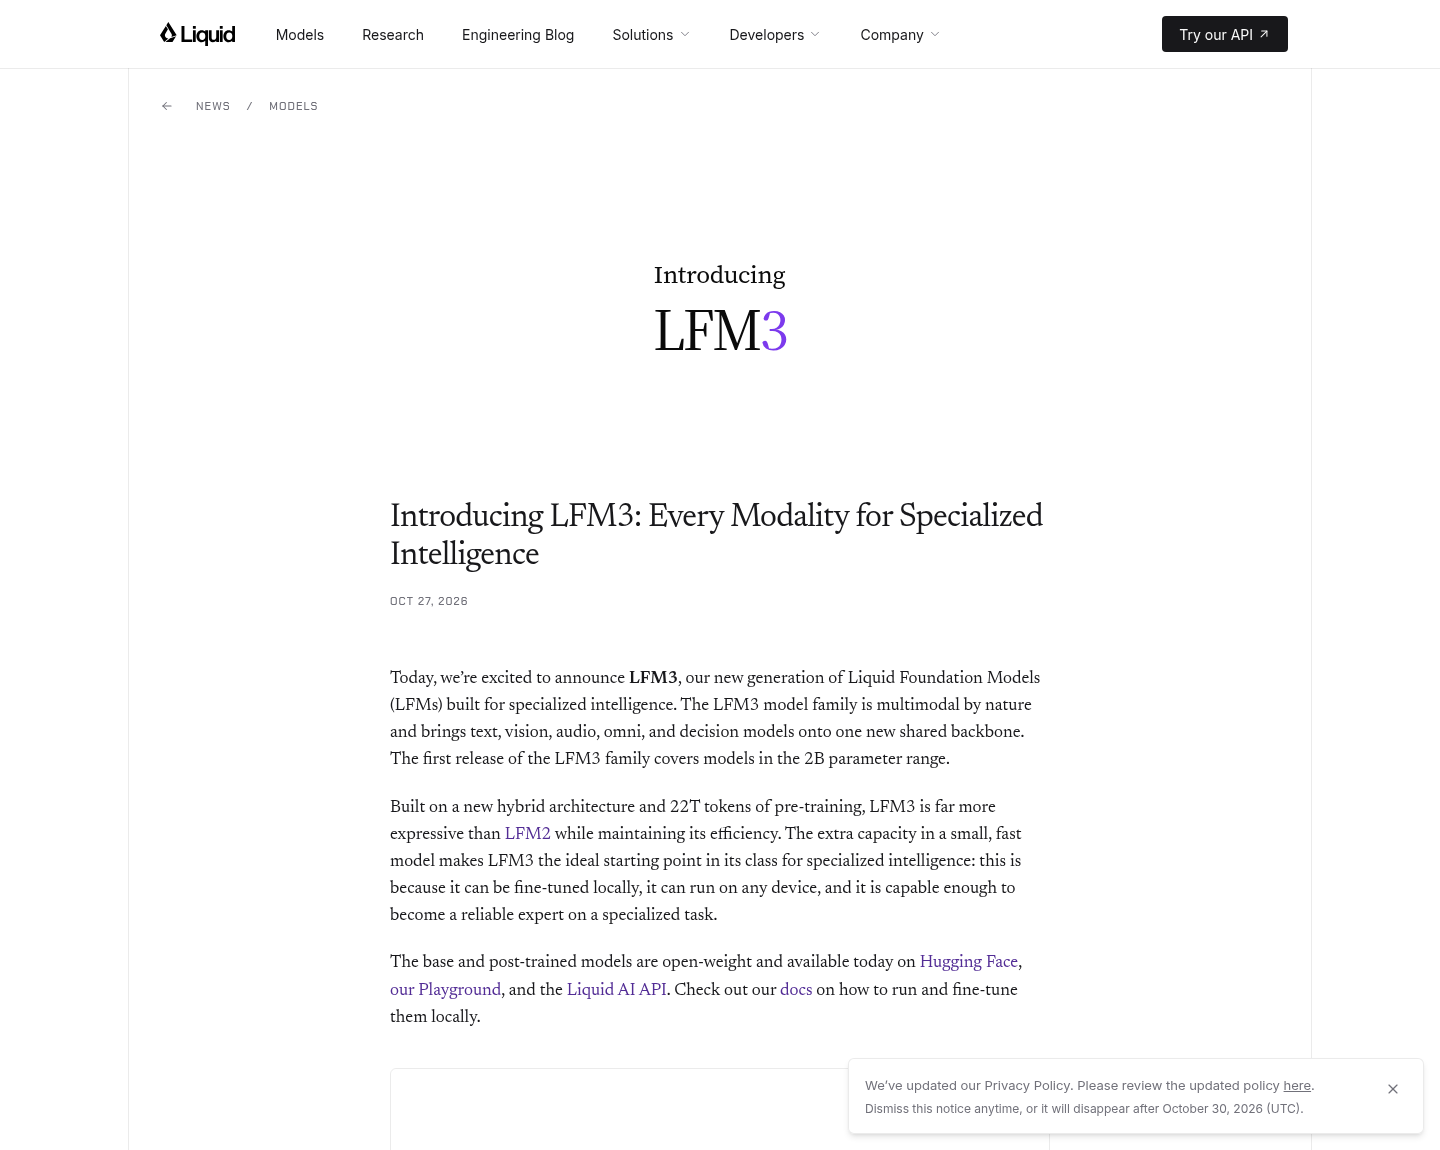
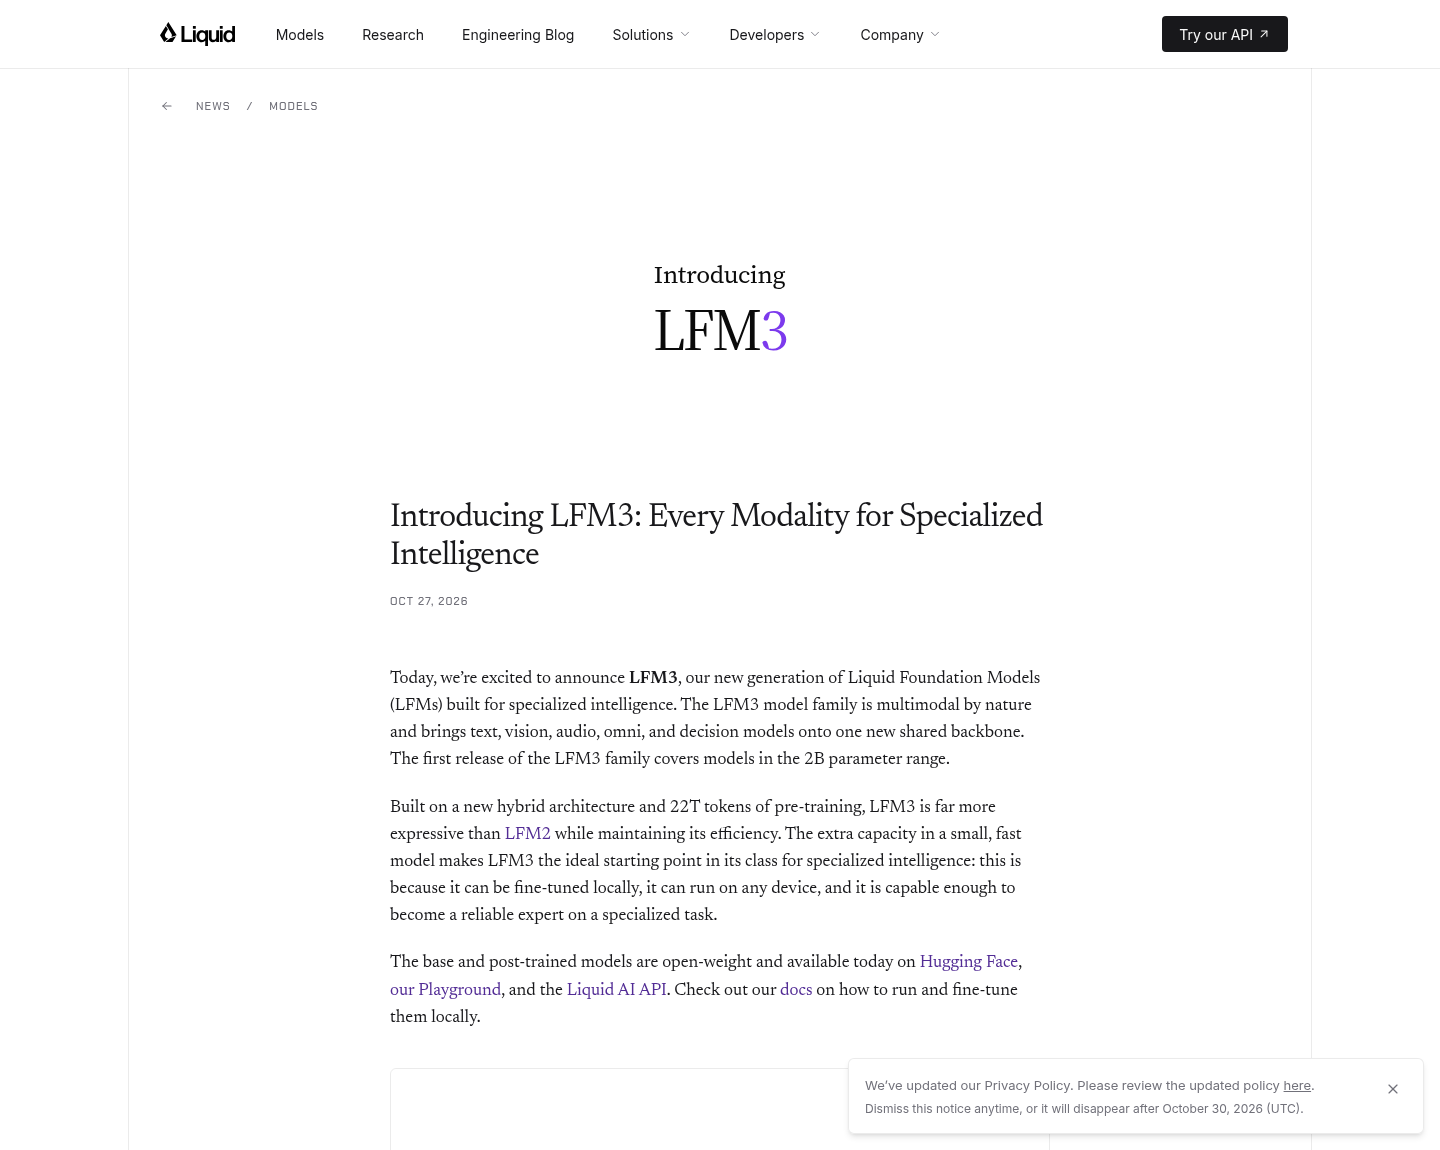
Keluarga LFM3 adalah rangkaian enam checkpoint kelas 2B dari Liquid AI yang berbagi satu backbone pra-latih, lalu disesuaikan untuk teks, visi, audio, pemrosesan omni, dan tugas pengambilan keputusan. Diluncurkan pada 27 Oktober 2026, keluarga ini mencakup LFM3-1.7B untuk teks, LFM3-VL-2B untuk visi, LFM3-Audio-2B untuk ucapan, LFM3-Omni-2B untuk berbagai modalitas, serta d1-2B dan d1-omni-2B untuk keputusan. Pilihan desain ini lebih berguna daripada memaksakan satu model kecil untuk semua kebutuhan: tim dapat memilih antarmuka dan kemampuan yang sesuai tanpa menganggap seluruh checkpoint sebagai tingkatan kemampuan. Semua berangkat dari LFM3-1.7B-Base, tetapi bukan berarti setiap model cocok untuk tugas yang sama. Untuk memilih model AI 2B ini, pertanyaan pertama bukan “mana yang paling kuat?”, melainkan “apa yang perlu masuk dan keluar dari sistem saya?”
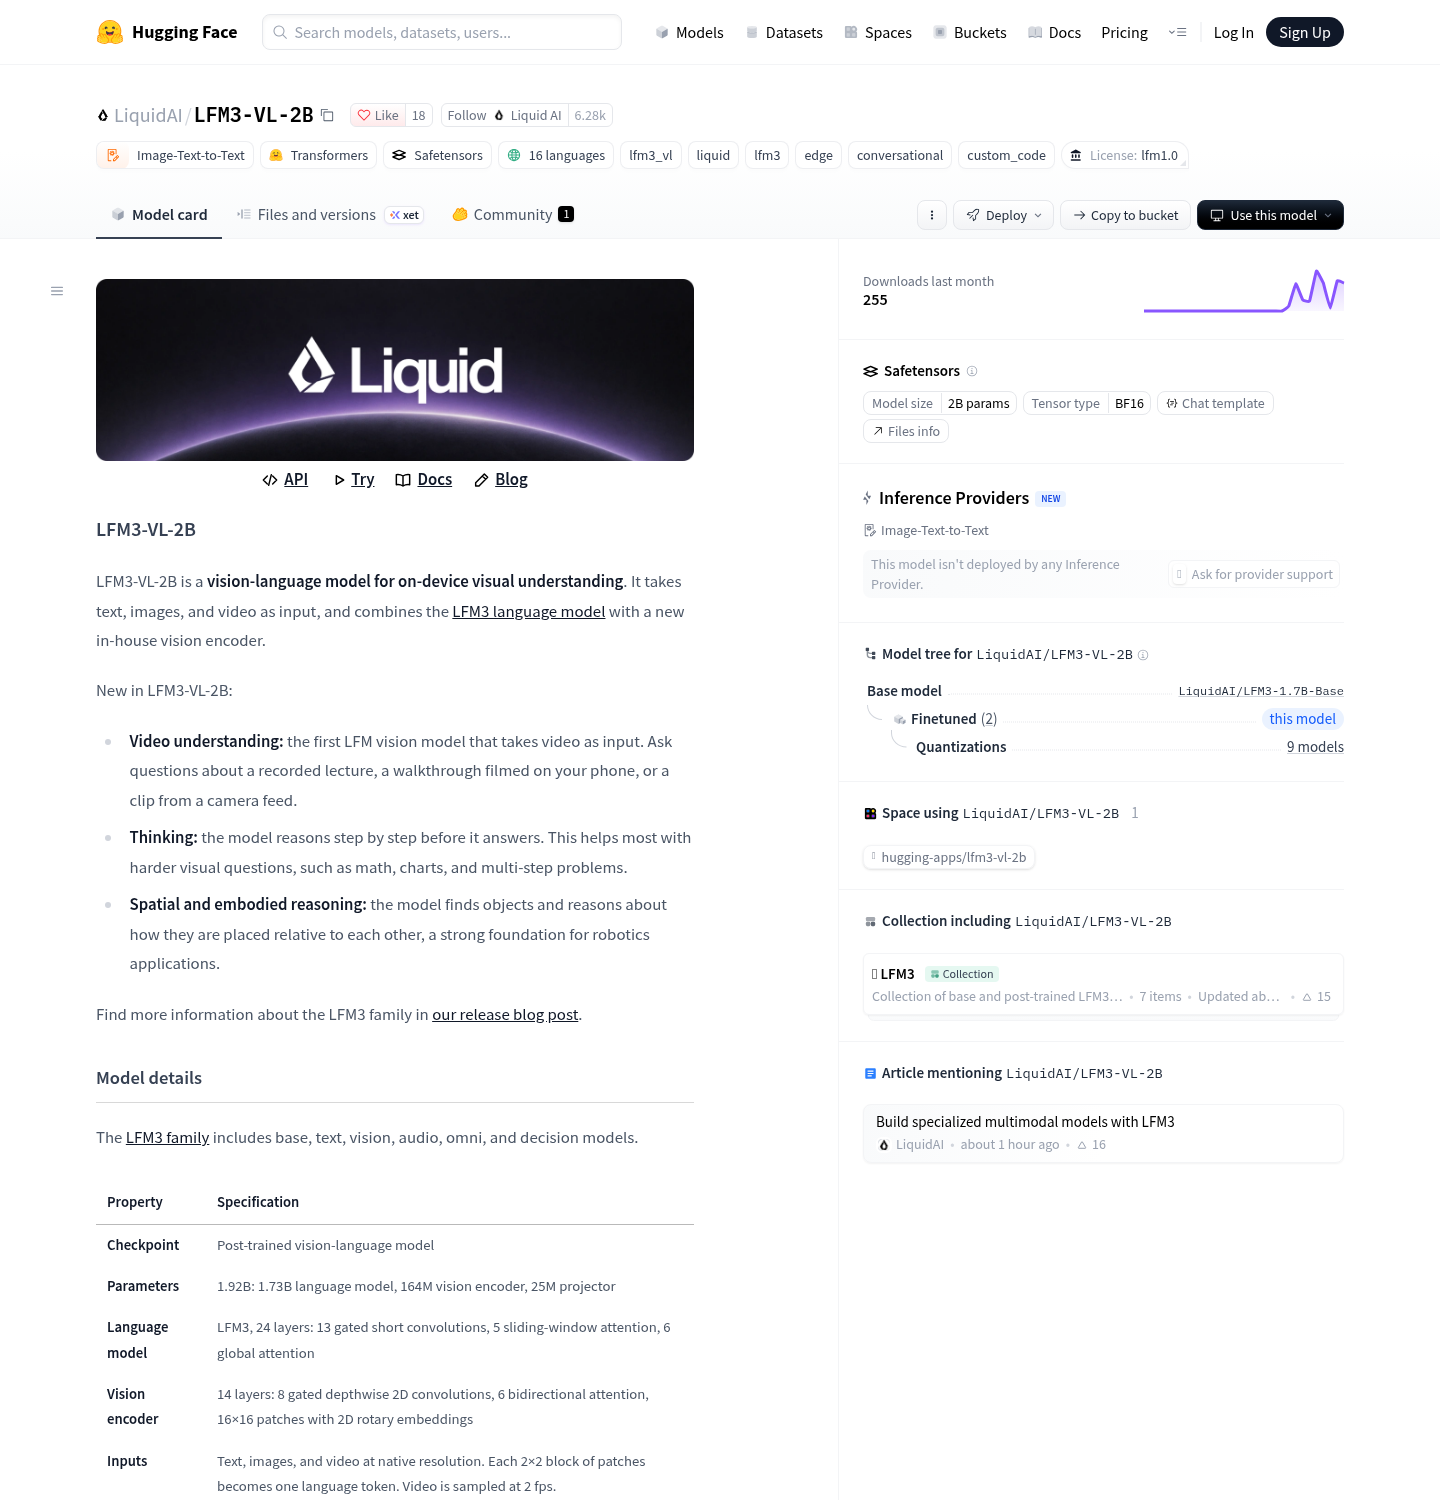
Backbone-nya memakai desain tri-hybrid dalam 24 lapisan: 13 lapisan konvolusi pendek bergerbang, lima lapisan atensi jendela geser, dan enam lapisan atensi global penuh. Pembagiannya masuk akal: konvolusi menangani pola lokal dengan biaya lebih rendah, atensi sparse menangani jarak menengah, sementara atensi global menghubungkan konteks yang lebih luas. Angka 256 token pada jendela atensi geser kerap tertukar dengan batas konteks. Itu ukuran jendela per lapisan, bukan panjang konteks keseluruhan; model teks LFM3 mendukung konteks hingga 256K token. Perbedaan ini penting bagi pengguna yang memproses dokumen panjang: arsitektur lokal tidak berarti model hanya dapat melihat beberapa ratus token.
Pilih modalitas sesuai pekerjaan
Untuk tugas bahasa, LFM3-1.7B menjadi pilihan langsung. LFM3-VL-2B ditujukan bagi sistem yang membaca gambar atau layar, memahami video, dan mendukung otomasi antarmuka maupun persepsi robotika; model ini memiliki encoder visi internal. LFM3-Audio-2B menangani pengenalan ucapan, sintesis suara, terjemahan ucapan, dan pemahaman audio. Namun, jangan samakan kemampuan audio tersebut dengan percakapan suara yang dapat disela secara langsung. Audio-2B menerima teks atau audio 16 kHz dan dapat menghasilkan teks, ucapan 24 kHz, atau keduanya secara bergantian; jendela konteks audionya 32K token menurut materi yang tersedia. Antarmuka ini tidak dirancang untuk interaksi full-duplex yang harus menanggapi pengguna saat sedang berbicara. Jika produk mengharuskan percakapan yang bisa dipotong dan disela, memilih model audio lain bukan perkara penyetelan lanjutan: kebutuhan itu harus cocok sejak awal dengan antarmuka model.
LFM3-Omni-2B adalah opsi AI multimodal yang menerima teks, gambar, video, dan audio, lalu menghasilkan teks atau ucapan. Secara konsep, inilah pilihan paling luas; secara praktis, cakupan modalitas saja tidak membuktikan bahwa ia terbaik untuk setiap tugas. Pilih VL untuk alur kerja visual yang jelas, Audio untuk ucapan, dan Omni bila sistem memang perlu menggabungkan beberapa jenis masukan. Dua model d1 melengkapi keluarga untuk kebutuhan keputusan, tetapi nama dan kategori itu saja belum cukup untuk menyimpulkan kinerjanya pada aplikasi tertentu. Keuntungan satu backbone adalah fondasi bersama, bukan jaminan perilaku yang seragam atau alasan untuk mengabaikan pengujian pada alur kerja sendiri.
Keterbukaan dan benchmark perlu dibaca dengan hati-hati
Liquid AI menerbitkan bobot keluarga LFM3 di bawah LFM Open License v1.0, tetapi istilah terbuka tidak otomatis berarti syarat komersialnya setara dengan lisensi permisif seperti Apache 2.0. Periksa ketentuan penggunaan sebelum mengintegrasikan checkpoint ke produk; keterbukaan bobot membantu pengunduhan dan penyesuaian, tetapi lisensi tetap menentukan ruang gerak. LFM3-Audio-2B, misalnya, tersedia sebagai checkpoint 2B parameter dengan build Ollama sekitar 2,1 GB, selain konversi dan bobot terkait audio yang disebutkan dalam materi. Artinya, pengembang dapat menguji model secara langsung, tetapi ketersediaan bobot bukan bukti bahwa model sudah cocok untuk produksi atau bahwa seluruh kemampuan audio telah dinilai pihak luar.
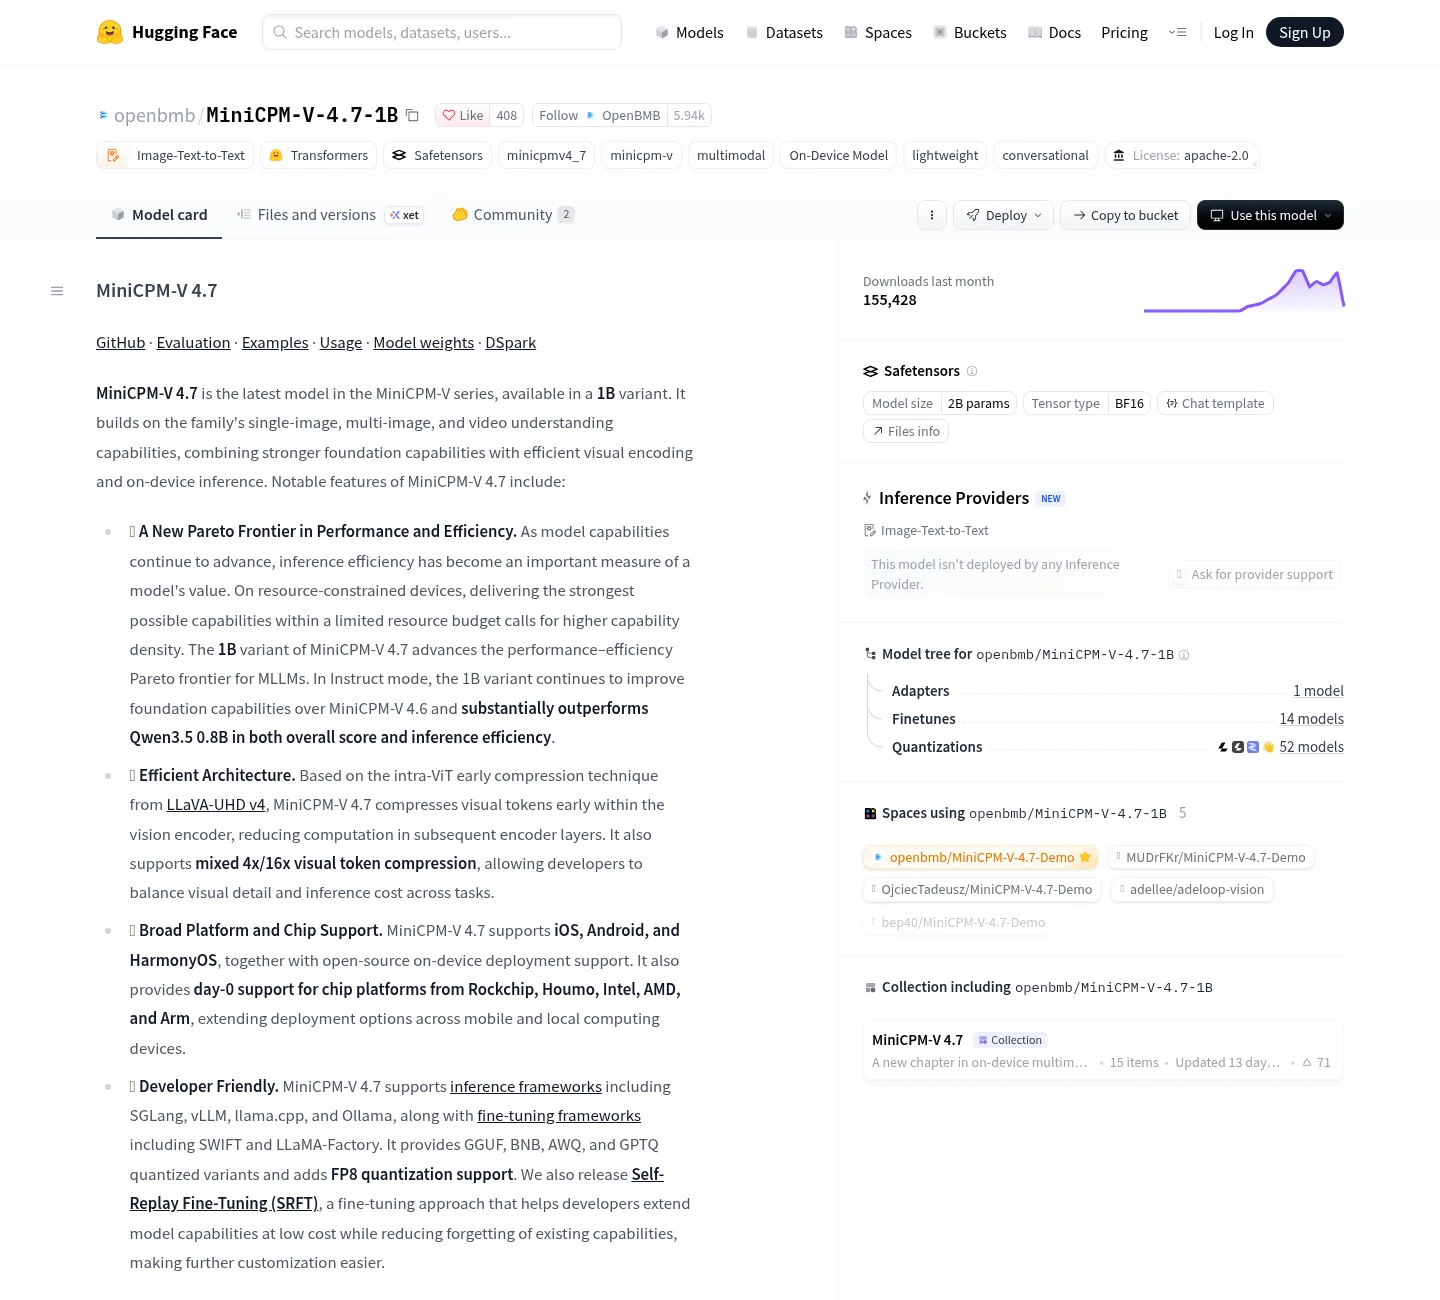
Perbandingan visi memberi gambaran sekaligus peringatan. Dalam suite 62 benchmark milik Liquid, LFM3-VL-2B mencatat rata-rata 71,4 dengan penalaran aktif dan 62,1 tanpa penalaran, sedangkan MiniCPM-V 4.7 1B mencatat 57,5 dalam perbandingan yang disajikan. Selisihnya tampak besar, tetapi angka itu berasal dari evaluasi vendor sendiri; tidak ada hasil tersebut yang direproduksi secara independen menurut materi yang tersedia. Perbedaan lisensi juga nyata: LFM Open License v1.0 membawa ketentuan komersial, sementara MiniCPM-V 4.7 1B menggunakan Apache 2.0. Untuk audio, bukti perbandingan bahkan lebih tipis: materi yang tersedia menyatakan belum ada benchmark independen untuk LFM3-Audio-2B, sementara pesaing yang dibahas tidak menyediakan bobot atau spesifikasi kinerja terukur. Jadi, angka benchmark layak menjadi petunjuk awal, bukan putusan akhir.
Kesimpulan: cocokkan model dengan kebutuhan, bukan label keluarga
Kekuatan utama LFM3 adalah pembagian kerja yang jelas di atas satu backbone: teks, visi, audio, omni, dan keputusan hadir sebagai pilihan terspesialisasi, bukan satu model mungil yang dipaksa melakukan semuanya. Konteks 256K pada model teks dan desain tri-hybrid memberi landasan menarik untuk tugas panjang, sementara varian visual dan audio memperluas keluarga ke penggunaan multimodal. Namun, pemilihan yang bertanggung jawab tetap harus mempertimbangkan bentuk masukan-keluaran, syarat lisensi, serta mutu bukti yang tersedia. Mulailah dari tugas konkret, cocokkan dengan checkpoint yang tepat, lalu uji pada data dan kondisi penggunaan sendiri. Kesimpulannya, satu backbone membuat keluarga ini koheren; kecocokan antarmuka, lisensi, dan hasil uji—bukan nama LFM3 semata—yang menentukan apakah sebuah model layak dipakai.