
Pilihan model atau pengalaman suara?
Model audio AI adalah sistem yang menerima, memahami, atau menghasilkan suara, tetapi nilai praktisnya bagi pengembang bergantung pada akses ke bobot, cara menguji kinerjanya, dan jalur integrasi ke produk. Jika prioritas Anda adalah membangun dan merilis, LFM3-Audio-2B adalah pilihan paling konkret: checkpoint terbuka berukuran 2B tersedia untuk diunduh. Dessa AI lebih tepat dipandang sebagai demo percakapan dalam daftar tunggu, sedangkan Sesame Preview adalah pengalaman aplikasi dengan suara yang terdengar alami, bukan API suara untuk disematkan ke layanan Anda. Ketiganya tidak bisa dinilai hanya dari kesan mendengarkan. LFM3 memberi bahan untuk eksperimen, tetapi bukti kinerjanya masih berasal dari vendor. Dessa menonjol lewat percakapan dupleks penuh, sementara Sesame menarik sebagai referensi kualitas suara. Jadi, keputusan utama bukan suara mana yang paling memikat, melainkan apakah Anda butuh produk yang bisa dicoba atau komponen yang bisa dirilis.
| Aspek | LFM3-Audio-2B | Dessa AI | Sesame Preview |
|---|---|---|---|
| Akses | Checkpoint 2B di repositori Hugging Face; build Ollama 2,1 GB | Daftar tunggu dan klip demo; bobot tidak tersedia | Aplikasi iOS dan Android; bukan API untuk produksi |
| Masukan dan keluaran | Teks atau audio 16 kHz masuk; teks, ucapan 24 kHz, atau gabungan teks dan ucapan keluar | Audio masuk dan audio keluar, tanpa perantara teks | Aplikasi suara; rincian spesifikasi model produksi tidak disediakan |
| Pola percakapan | Permintaan dan respons dengan streaming | Dupleks penuh: dapat mendengar saat berbicara dan disela | Pengalaman percakapan dalam aplikasi |
| Parameter dan konteks | 2B parameter; konteks 32K token | Tidak diungkapkan | Tidak diungkapkan untuk suara produksi |
| Bahasa | Mengklaim 18 bahasa di 19 lokal; ASR langsung hanya bahasa Inggris | Belum diterbitkan | Resmi hanya bahasa Inggris; bahasa lain disebut masih tahap awal |
| Bukti kinerja | Tabel vendor enam baris, tanpa benchmark independen yang ditemukan | Tidak ada tolok ukur yang dipublikasikan | Kesan mendengar demo; kinerja model produksi belum dinilai pihak ketiga |
LFM3-Audio-2B: paling siap untuk eksperimen pengembang
Keunggulan LFM3-Audio-2B adalah sesuatu yang dapat diperiksa dan dijalankan: bobot tersedia, ada konversi untuk beberapa format, dan dukungan llama.cpp telah digabungkan. Model menerima teks atau audio 16 kHz dan dapat menghasilkan teks, ucapan 24 kHz, maupun keluaran teks-suara yang berselang-seling. Dengan konteks 32K token dan klaim dukungan 18 bahasa di 19 lokal, model ini memberi tim bahan untuk prototipe, fine-tuning, dan evaluasi sendiri. Namun, angka bahasa tidak berarti semua tugas sama kuatnya: ASR langsung hanya disebut tersedia untuk bahasa Inggris. Ada pula batas lisensi yang perlu diperiksa sebelum rilis komersial, khususnya jika pendapatan tahunan melampaui ambang yang ditentukan. Kelemahan terbesar adalah bukti kualitas. Tabel enam baris yang diterbitkan Liquid membandingkan model dengan pendahulunya, tanpa set uji atau perangkat evaluasi yang dijelaskan. Belum ada reproduksi pihak ketiga yang dapat menguatkan angka tersebut. Jadi, ini kandidat nyata untuk dikirim, bukan jaminan kinerja.
Bagi tim yang memilih model audio AI untuk produk, keterbukaan bobot membuat pengujian internal lebih bernilai daripada demo yang hanya bisa didengar. Anda dapat mengukur latensi, mutu transkripsi, perilaku pada aksen dan bahasa yang relevan, serta kebutuhan perangkat keras dalam alur kerja sendiri. Tetapi jangan menganggap tersedianya checkpoint sebagai bukti bahwa kualitasnya sudah terbukti secara independen. Angka vendor dapat membantu menentukan apa yang layak diuji lebih dulu, bukan menggantikan evaluasi pada data dan beban kerja Anda. LFM3 juga bukan pilihan tepat jika inti produk adalah percakapan yang dapat disela saat model sedang berbicara: bentuk interaksinya berbasis permintaan dan respons, bukan dupleks penuh.
Dessa dan Sesame: demo menarik, integrasi belum tersedia
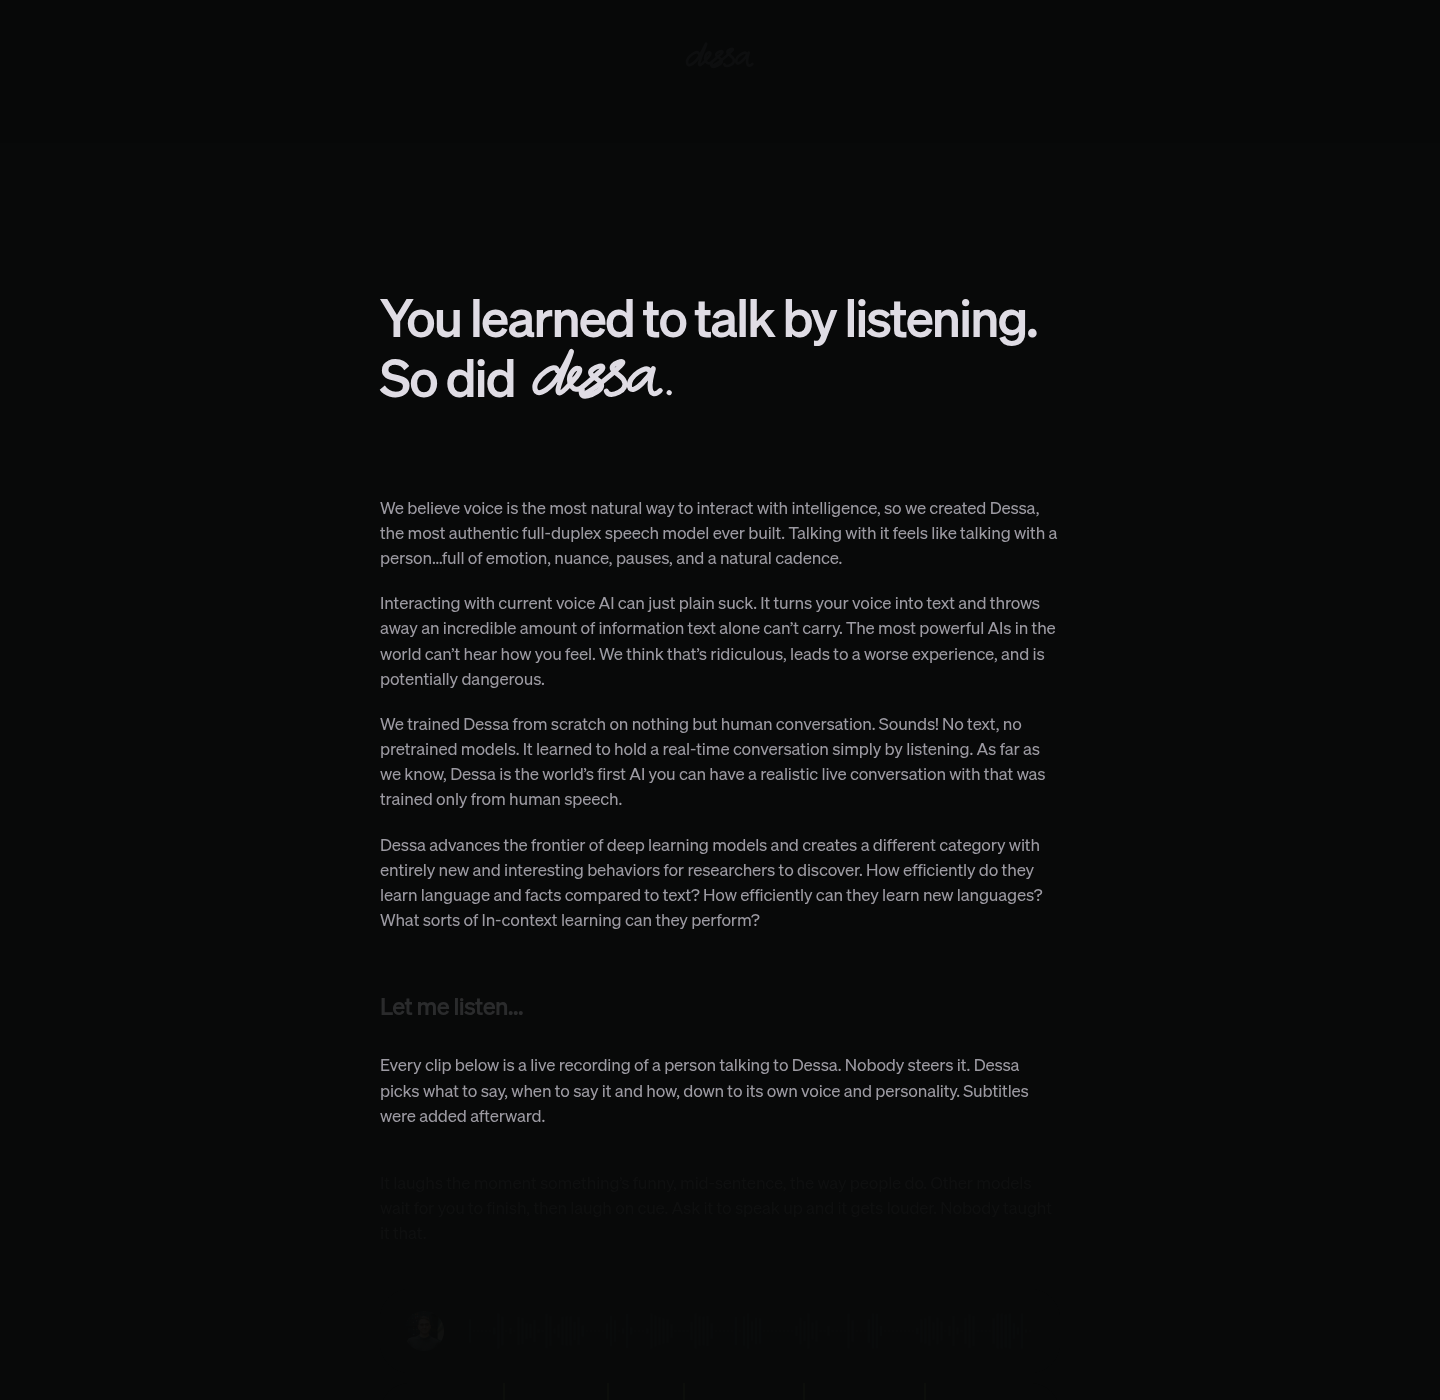
Dessa AI memperlihatkan keunggulan yang tidak ditawarkan LFM3: model dupleks penuh yang mendengar sambil berbicara, dapat disela di tengah kalimat, dan mampu menyisipkan respons singkat ketika lawan bicara masih berbicara. Itu membuat demonya relevan untuk merancang pengalaman percakapan yang terasa bergiliran secara alami. Namun, pengembang belum mendapat bobot, ukuran model, API, ataupun benchmark publik—yang tersedia berupa daftar tunggu dan klip. Anda dapat menilai contoh yang disediakan, tetapi belum dapat menguji model sendiri atau memasukkannya ke aplikasi. Karena itu, kekuatan Dessa saat ini adalah demonstrasi pola interaksi, bukan kesiapan rilis. Jika fitur interupsi langsung menjadi syarat produk, Dessa patut dipantau; jika Anda harus membangun sekarang, kekurangan akses tersebut membuatnya sulit dijadikan fondasi.
Sesame Preview punya daya tarik berbeda: suaranya terdengar alami dan aplikasi selulernya menyatukan agen, memori, serta konektor. Itu menjadikannya tempat yang berguna untuk menilai nada suara, jeda, dan tempo percakapan. Namun, pengalaman tersebut tidak menyediakan API, ID model, atau tingkat layanan untuk perusahaan. Sesame juga memiliki checkpoint riset CSM-1B, tetapi itu bukan model asisten produksi yang menjalankan Preview. CSM-1B berfokus pada sintesis suara, hanya mendukung bahasa Inggris, dan dapat mengkloning suara dari klip referensi 10–15 detik; demo interaktifnya menggunakan varian fine-tuned yang tidak dapat diunduh. Dengan demikian, demo yang mengesankan bukan bukti bahwa pengembang dapat merilis perilaku yang sama. Gunakan Preview sebagai acuan desain, bukan rencana integrasi.
Batas bukti berlaku bagi semua pilihan. Untuk LFM3, angka performa berasal dari vendor dan membandingkan model dengan versi sebelumnya, bukan pesaing, tanpa evaluasi independen yang ditemukan. Untuk Dessa, klip yang dikurasi memperlihatkan perilaku tertentu, tetapi bukan hasil pengujian yang dapat direproduksi. Untuk Sesame Preview, kesan bahwa suara terdengar manusiawi tetap merupakan penilaian terhadap pengalaman aplikasi, bukan validasi pihak ketiga atas model produksi. Karena itu, pisahkan dua pertanyaan: apa yang terdengar bagus dalam demo, dan apa yang dapat diuji, dikendalikan, serta dirilis. LFM3 unggul pada akses dan kemampuan untuk dievaluasi sendiri; Dessa unggul pada interaksi dupleks penuh yang diperlihatkan; Sesame unggul sebagai referensi suara dalam aplikasi. Tak satu pun memberi dasar lengkap untuk menyimpulkan kualitas relatif secara independen.
Buy if / Skip if
- Buy the LFM3-Audio-2B if Anda perlu checkpoint yang dapat diunduh, diuji, disesuaikan, dan dimasukkan ke produk dengan batasan lisensi yang sudah Anda periksa.
- Skip the LFM3-Audio-2B if produk Anda mengharuskan pengguna menyela model ketika model sedang berbicara, atau Anda membutuhkan bukti benchmark independen sebelum memilih.
- Buy the Dessa AI if Anda sedang meneliti percakapan dupleks penuh dan ingin memakai demonya untuk memahami interupsi, jeda, serta respons singkat.
- Skip the Dessa AI if Anda harus mengintegrasikan model sekarang; bobot, API, spesifikasi ukuran, dan tolok ukur publik belum tersedia.
- Buy the Sesame Preview if Anda ingin mengkalibrasi karakter suara dan ritme percakapan melalui pengalaman aplikasi.
- Skip the Sesame Preview if Anda membutuhkan API suara produksi atau ingin menanamkan suara Preview ke produk Anda.