
Model LFM3: keluarga kecil dengan spesialisasi berbeda
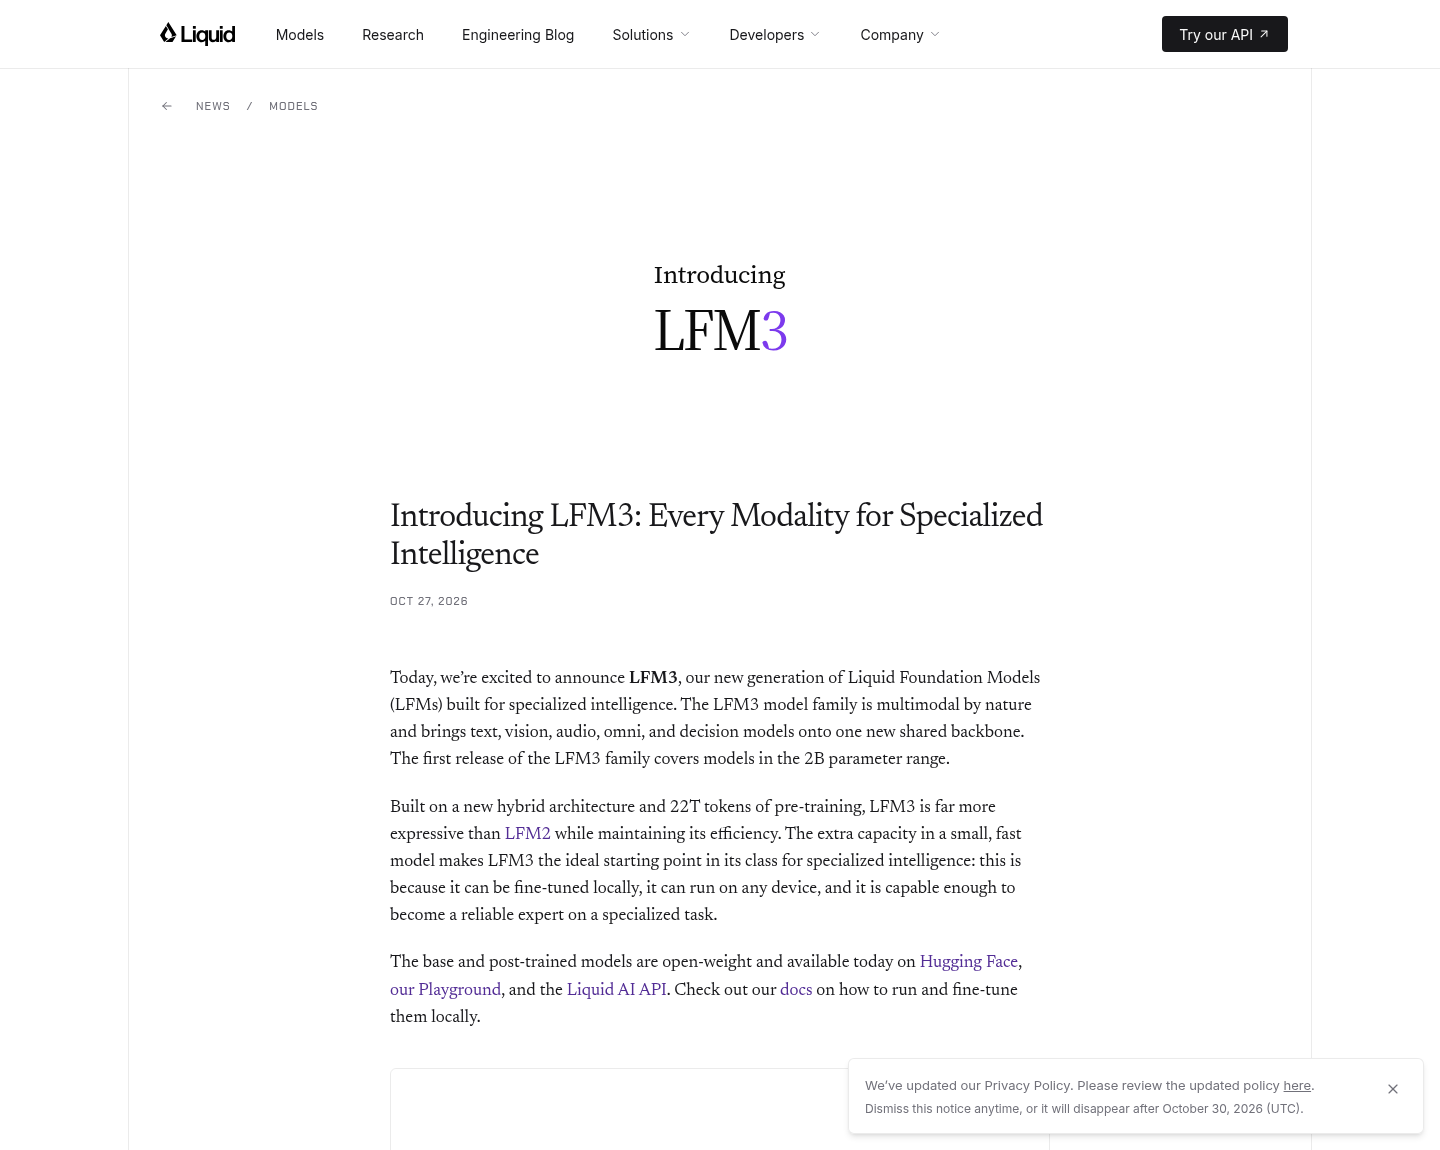
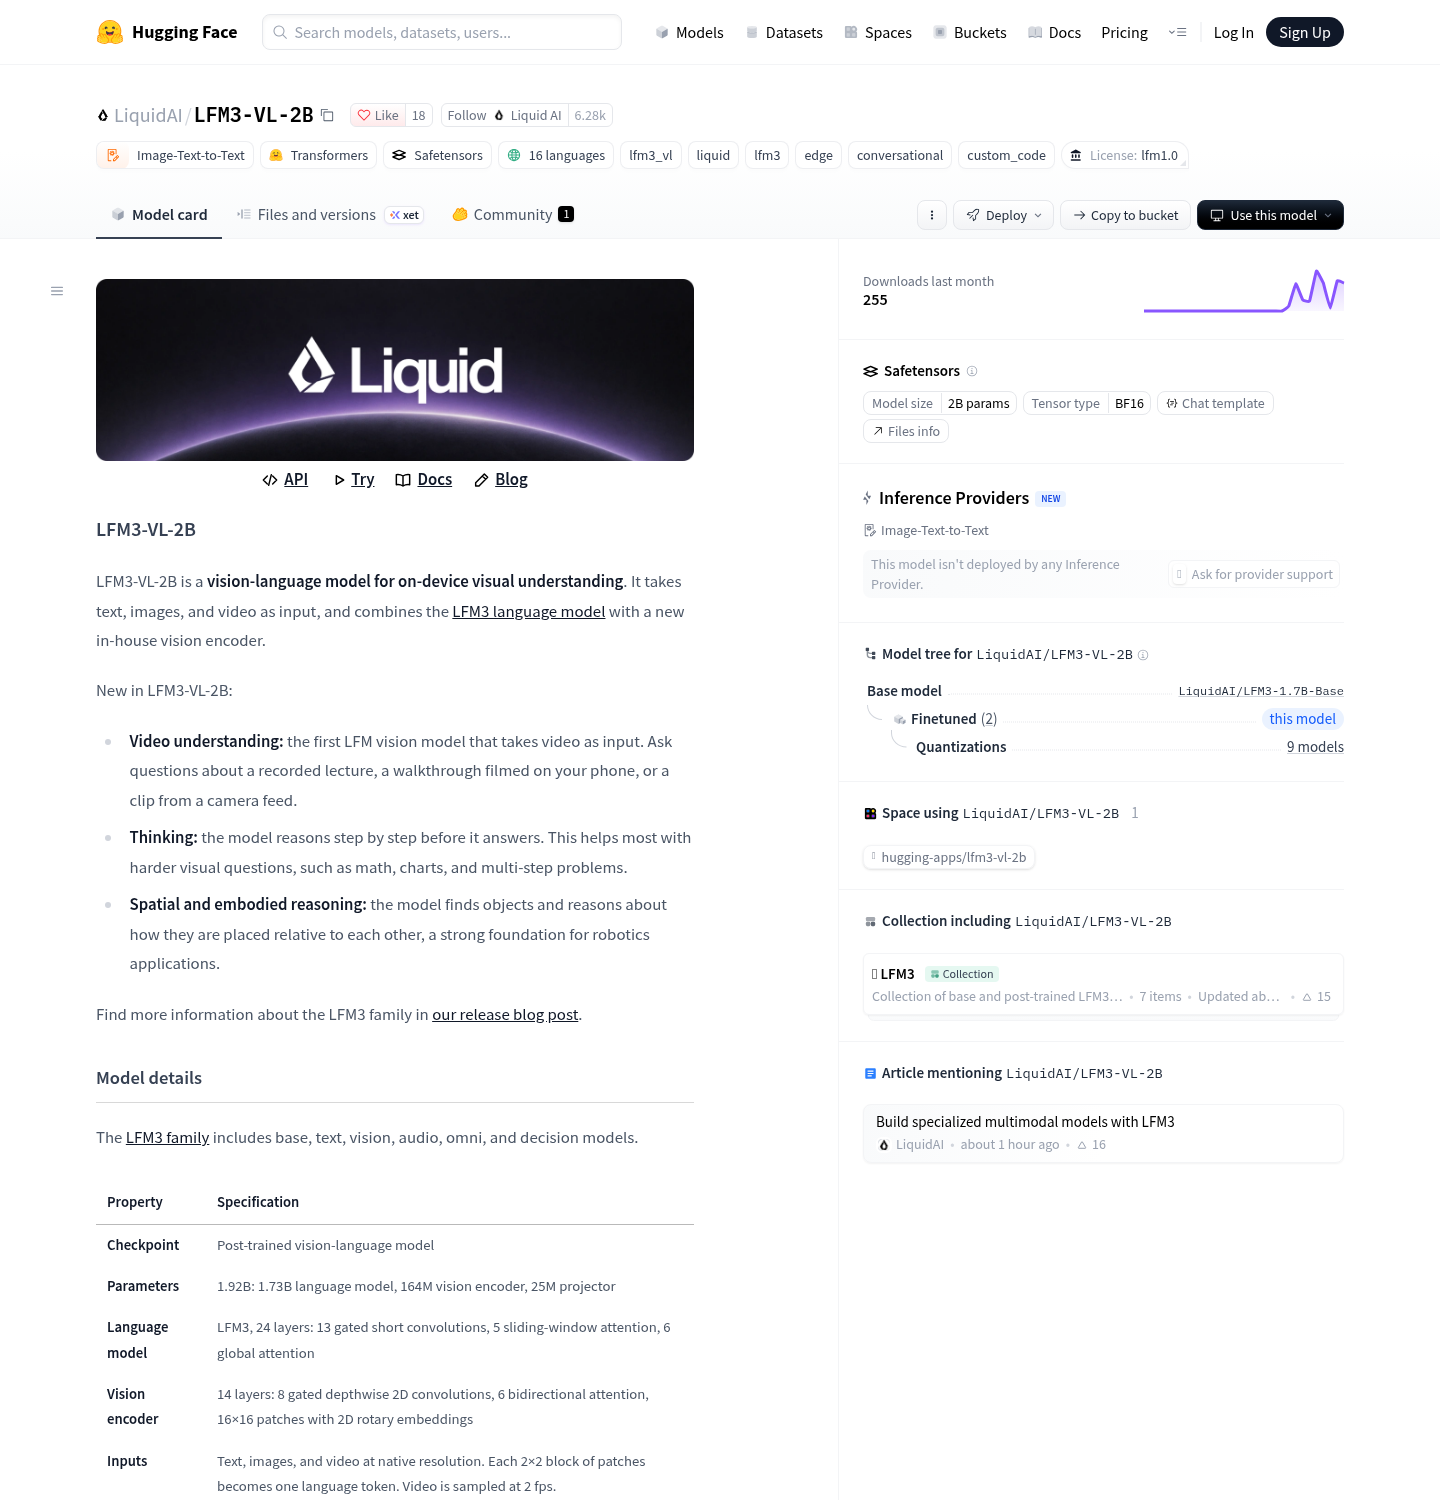
Model LFM3 adalah keluarga model multimodal ringkas dari Liquid AI yang membagi kemampuan teks, visi, audio, omni, dan pengambilan keputusan ke enam checkpoint berbasis satu backbone pra-latih, sehingga pengguna dapat memilih model sesuai tugas alih-alih mengandalkan satu model serbaguna. Jika prioritas Anda adalah pemahaman gambar, LFM3-VL-2B layak masuk daftar pendek; untuk bahasa saja, audio, atau alur multimodal lebih luas, ada anggota keluarga yang lebih sesuai. Konteks 256K token berlaku pada model teks LFM3-1.7B, bukan spesifikasi yang boleh digeneralisasi ke semua model LFM3. Untuk kebutuhan visual, perbandingan paling berguna adalah dengan MiniCPM-V 4.7 1B dan Moondream 3: yang pertama bersaing lewat benchmark, sementara yang kedua menawarkan keluaran visual terstruktur. Pilihan terbaik bergantung pada apakah Anda mengutamakan skor, memori, atau hasil yang bisa langsung dipakai aplikasi.
| Aspek | LFM3-VL-2B | MiniCPM-V 4.7 1B | Moondream 3.1 9B A2B |
|---|---|---|---|
| Fokus | Pemahaman visi-bahasa; menerima teks, gambar, dan video | Pemahaman visi-bahasa | Tugas visual dengan keluaran bertipe |
| Parameter dan bobot | 1,92B; sekitar 4 GB dalam BF16, sebelum cache dan token gambar | 1,55B menurut dokumentasi | 9B parameter tersimpan; sekitar 18 GB sebelum aktivasi |
| Konteks | 128K token terdokumentasi | 256K token diklaim dalam dokumentasi vendor | 32K token pada perbandingan versi 3.1 |
| Keluaran atau kemampuan pembeda | Teks; video disampel pada 2 fps; mode berpikir tersedia | Kompresi token visual 4× atau 16× yang dapat dipilih | Kotak deteksi, titik, dan mask dalam format terstruktur; tanpa audio |
| Lisensi | LFM Open License v1.0 | Apache 2.0 | Bobot terbuka |
LFM3-VL-2B atau MiniCPM: pilih berdasarkan jenis penalaran
Pada 62 benchmark multimodal yang dipilih Liquid, LFM3-VL-2B meraih rata-rata 71,4, dibandingkan 57,5 untuk MiniCPM-V 4.7 1B. Keunggulan 13,9 poin itu menyusut menjadi 4,6 ketika mode berpikir LFM3-VL dimatikan. Ini membuat mode berpikir bagian penting dari keputusan: jangan memakai angka agregat seolah-olah mewakili pengalaman tanpa penalaran. LFM3-VL-2B menonjol pada pemahaman GUI, dengan skor 83,1 dalam mode berpikir dan 81,5 tanpa berpikir, dibandingkan 45,3 untuk MiniCPM; pada ScreenSpot-Pro hasilnya 55,5 versus 4,9. Namun MiniCPM unggul pada We-Math ketat, 47,8 berbanding 20,1 untuk LFM3-VL tanpa berpikir, meskipun LFM3-VL mencapai 68,6 dengan mode berpikir. Jadi, untuk antarmuka dan grounding visual, LFM3 lebih menarik; untuk matematika visual tanpa mode berpikir, MiniCPM lebih meyakinkan.
Hasilnya tidak satu arah di semua tugas. MiniCPM mencatat 88,8 pada ChartQA, sedangkan LFM3-VL meraih 81,4 tanpa berpikir dan 92,7 dengan berpikir; pada MMMU, MiniCPM mendapat 51,0, dibandingkan 48,6 tanpa berpikir atau 55,7 dengan berpikir untuk LFM3-VL. Dengan kata lain, mode berpikir dapat mengubah pemenang pada sebagian tugas. Ada pula faktor penerapan: MiniCPM lebih kecil sekitar 370 juta parameter dan berlisensi Apache 2.0, sedangkan LFM3 menggunakan lisensi dengan ketentuan komersial. Keduanya belum memiliki reproduksi benchmark pihak ketiga dalam bahan yang tersedia, sehingga angka vendor sebaiknya diperlakukan sebagai petunjuk, bukan keputusan final. Pilih MiniCPM jika lisensi permisif dan tugas matematika tanpa penalaran tambahan lebih penting; pilih LFM3-VL jika hasil GUI, grounding, atau penalaran aktif menjadi sasaran.
Moondream: kebutuhan memori dan bentuk keluaran mengubah pilihan
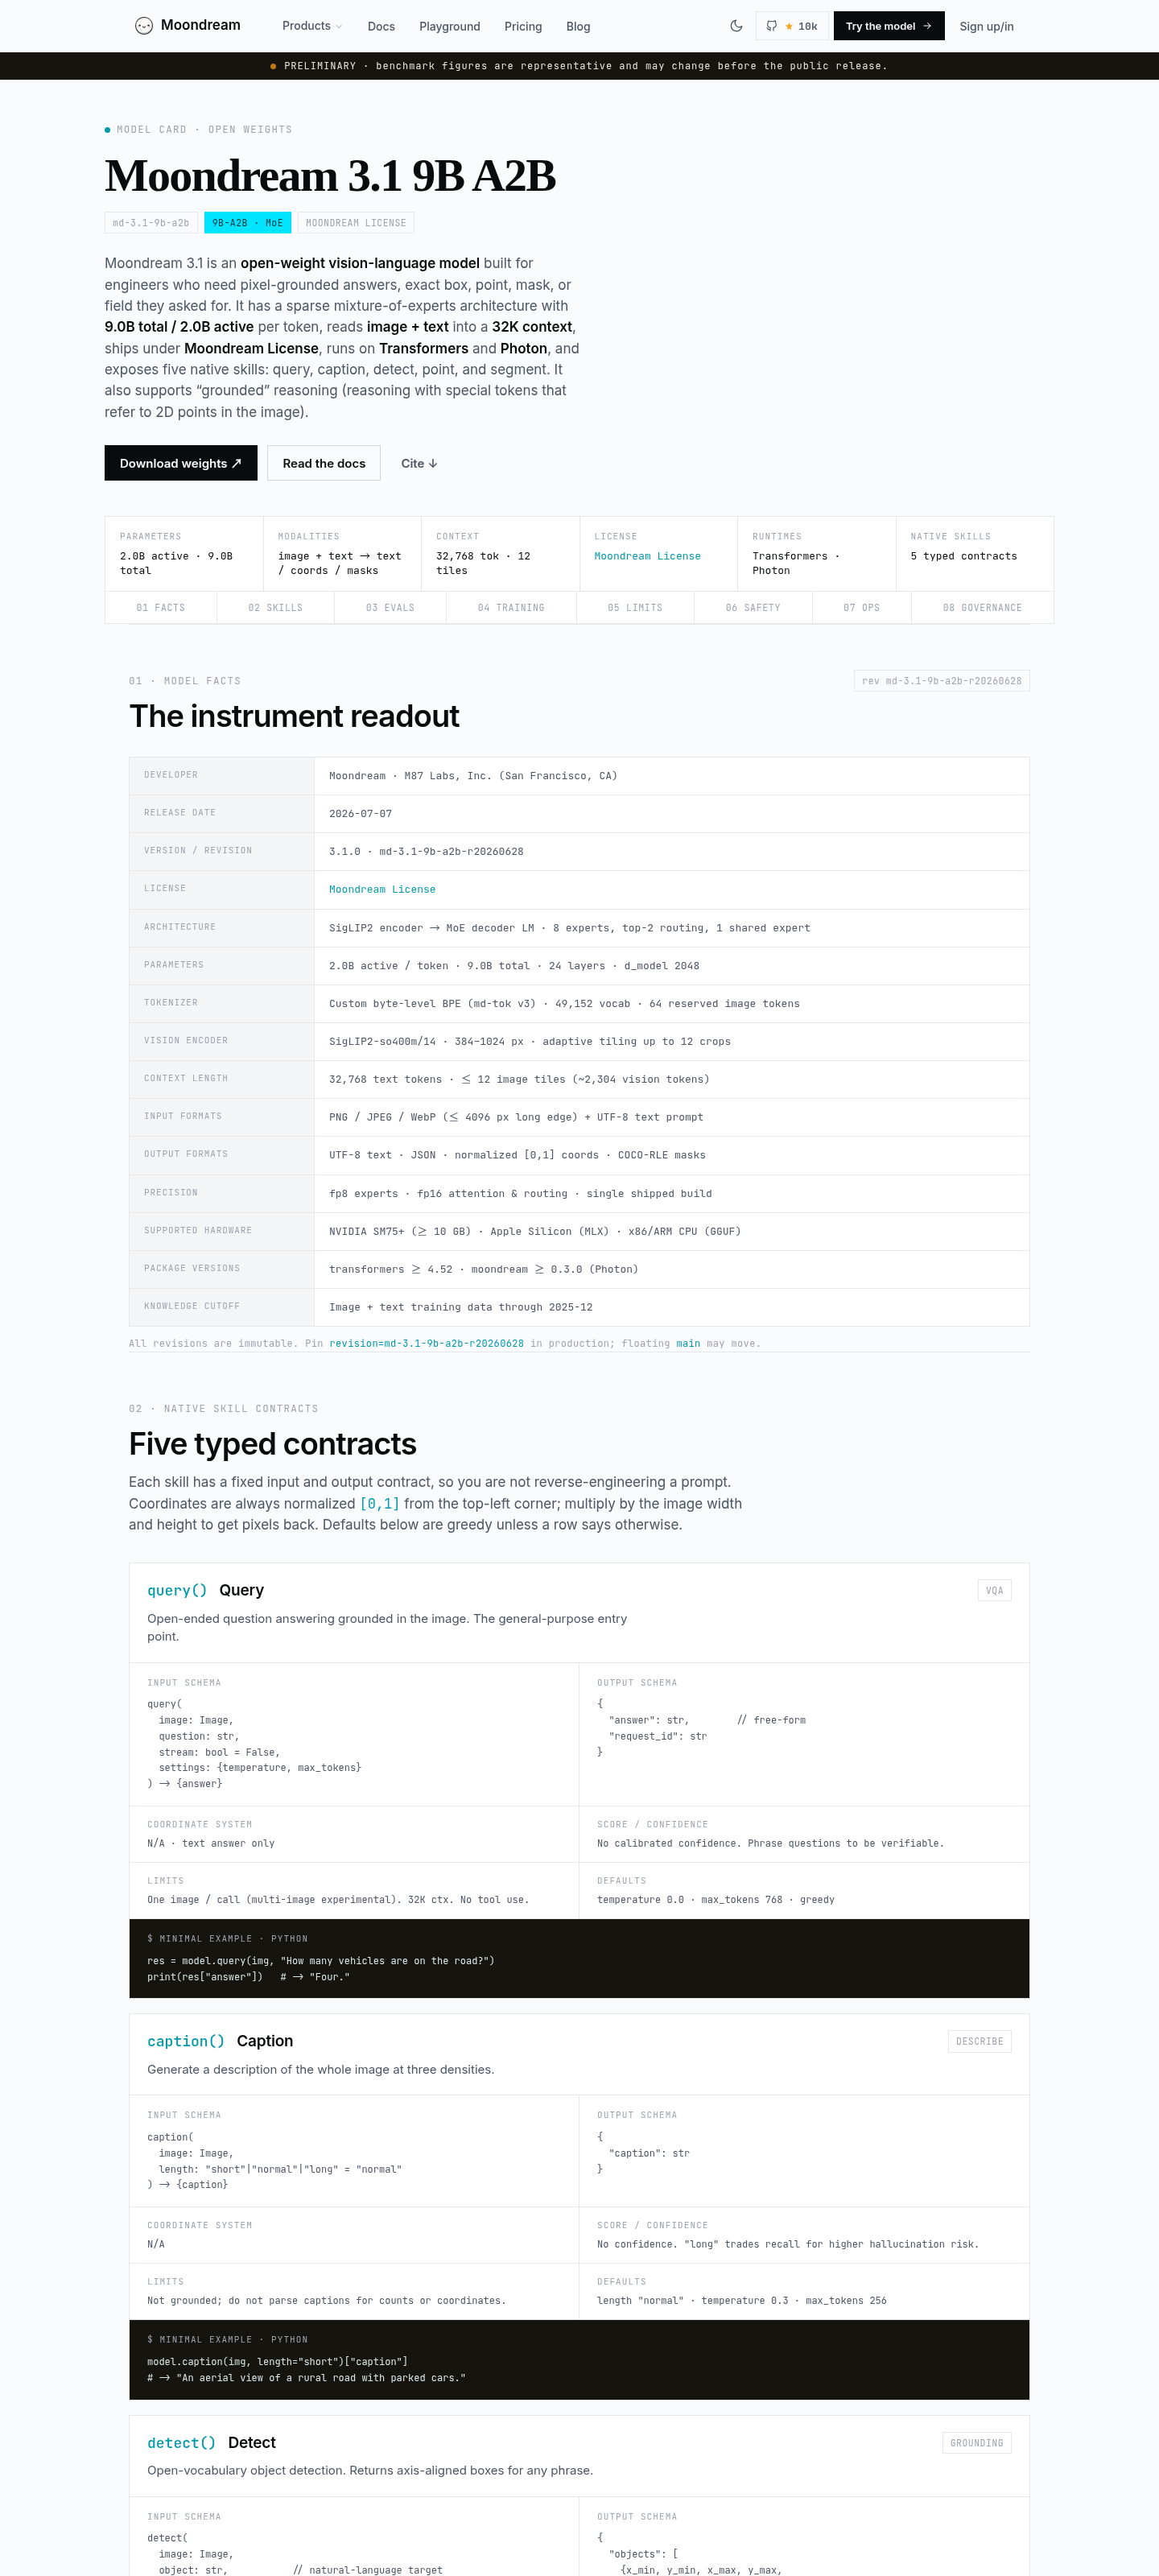
LFM3-VL-2B lebih cocok untuk perangkat dengan memori terbatas: bobot BF16-nya sekitar 4 GB, meski penggunaan nyata membutuhkan ruang tambahan untuk cache dan token gambar. Moondream 3.1 9B A2B berada di kelas berbeda dalam kebutuhan memori, dengan sekitar 18 GB untuk bobot sebelum aktivasi. Perbandingan ini bukan duel adil berdasarkan angka parameter aktif saja: Moondream menyimpan sembilan miliar parameter, meskipun mengaktifkan dua miliar per token. Sebagai model AI ringan untuk laptop, LFM3-VL punya keunggulan praktis yang jelas, sedangkan Moondream menuntut sumber daya lebih besar. Namun, angka memori bukan keseluruhan cerita. Moondream menyediakan fungsi query, caption, detect, point, dan segment dengan keluaran tetap: hingga 200 kotak, 64 titik, atau 50 mask dalam koordinat ternormalisasi berbentuk JSON. Itu berguna untuk otomasi visual yang memerlukan lokasi terstruktur, tanpa harus mengurai deskripsi bebas.
Untuk tugas pembacaan visual, LFM3-VL melaporkan 96,7 pada DocVQA, 92,7 pada pembacaan grafik, dan 86,3 pada OCRBench v1; Moondream masing-masing mencatat 88,6, 86,6, dan 61,2 pada angka yang dibandingkan. Namun kedua set skor dilaporkan vendor menggunakan pengujian yang dipilih vendor, dan belum direproduksi secara independen. Jadi, jangan menyimpulkan LFM3 selalu lebih baik: Moondream bisa lebih tepat ketika keluaran kotak, titik, atau mask langsung dibutuhkan, sedangkan LFM3-VL lebih menarik untuk pemahaman gambar umum dengan batas memori lebih ketat. Pertimbangkan juga lisensi serta format keluaran sebelum memilih. Skor menjawab seberapa baik model pada pengujian tertentu; kebutuhan memori dan kontrak keluaran menentukan apakah model cocok masuk ke sistem Anda.
LFM3-Omni dan Moondream tidak mengerjakan tugas yang sama
LFM3-Omni-2B menerima teks, gambar, video dengan atau tanpa soundtrack, serta audio 16 kHz; keluarannya dapat berupa teks, ucapan 24 kHz, atau gabungan keduanya. Moondream 3.1 tidak memiliki jalur audio dan berfokus pada masukan gambar serta teks. Karena itu, membandingkan kemampuan audio Omni dengan deteksi visual Moondream seperti membandingkan dua alat yang menjawab pertanyaan berbeda. Moondream memberikan kotak pembatas, titik, dan mask berkoordinat, sementara Omni tidak menyediakan jalur keluaran koordinat. Untuk menggerakkan robot atau mengotomasi antarmuka berdasarkan posisi objek, kontrak visual Moondream lebih langsung. Untuk aplikasi yang perlu memahami ucapan atau menghasilkan suara, Moondream bukan pilihan pengganti. Satu-satunya skor bersama yang dilaporkan pada kartu keduanya adalah DocVQA: 92,47 untuk Omni dan 88,6 untuk Moondream. Keunggulan itu terbatas pada tanya jawab dokumen, bukan bukti bahwa Omni lebih baik dalam deteksi.
Buy if / Skip if
- Buy the LFM3-VL-2B if Anda membutuhkan pemahaman GUI atau grounding visual dan dapat menyediakan ruang memori di atas kebutuhan bobot BF16 sekitar 4 GB.
- Skip the LFM3-VL-2B if aplikasi Anda mengandalkan keluaran koordinat, kotak, atau mask yang langsung terstruktur tanpa penguraian teks.
- Buy the MiniCPM-V 4.7 1B if Anda mengutamakan lisensi Apache 2.0 atau hasil matematika visual tanpa mode berpikir.
- Skip the MiniCPM-V 4.7 1B if tugas utama Anda adalah pemahaman GUI, karena hasil ScreenSpot-Pro yang dilaporkan jauh di bawah LFM3-VL-2B.
- Buy the Moondream 3.1 if sistem Anda membutuhkan deteksi, penunjukan, dan segmentasi dengan hasil JSON terstruktur.
- Skip the Moondream 3.1 if perangkat Anda tidak mampu menyediakan sekitar 18 GB untuk bobot atau Anda memerlukan jalur audio.
- Buy the LFM3-Omni-2B if aplikasi Anda perlu menerima audio dan menghasilkan ucapan, teks, atau keduanya.
- Skip the LFM3-Omni-2B if aplikasi Anda memerlukan keluaran koordinat visual yang dijamin, seperti kotak pembatas atau mask.