
Nemotron 3.5 Bolt: Saat Model AI Lokal Menjadi Arus Utama
Nemotron 3.5 Bolt adalah keluarga model AI lokal terbuka dari NVIDIA yang dirancang untuk menjalankan agen AI offline langsung di laptop dan PC berchip RTX Spark, memindahkan beban komputasi dari pusat data ke perangkat pengguna dan membuka cara baru membangun aplikasi yang lebih cepat, privat, dan hemat biaya infrastruktur. Peluncuran Nemotron 3.5 Bolt 74B, model bahasa dengan 74 miliar parameter dan 9 miliar parameter aktif per token yang dikompresi ke dua bit sehingga hanya membutuhkan memori 24 GB, menandai momen penting: model kelas besar kini masuk akal untuk komputasi edge AI di perangkat konsumen. Bukan sekadar rilis teknis, ini adalah pernyataan strategi bahwa masa depan laptop AI development tidak harus bergantung pada cloud setiap kali pengguna mengetik prompt.
NVIDIA merilis Nemotron 3.5 Bolt 74B pada 15 Oktober 2026 sebagai model bahasa terbuka yang siap digunakan untuk keperluan komersial dan nonkomersial, dengan lisensi OpenMDW-1.1 dan konteks hingga 256K token. Pada hari yang sama, perusahaan juga memperluas portofolio Nemotron 3.5 dengan dua varian lain: Super VL dan Bolt E4B 4GB, sehingga pengembang dapat memilih model AI lokal sesuai kebutuhan memori dan jenis tugas. Menariknya, pengumuman Bolt dikaitkan langsung dengan platform laptop RTX Spark yang diperkenalkan sebelumnya bersama mitra sistem operasi, menunjukkan bahwa model ini bukan eksperimen laboratorium, melainkan bagian dari ekosistem perangkat keras–perangkat lunak yang sengaja dibangun untuk agen AI offline.
Arsitektur 74B dalam 24 GB: Kompresi Bukan Sekadar Trik, Tapi Strategi
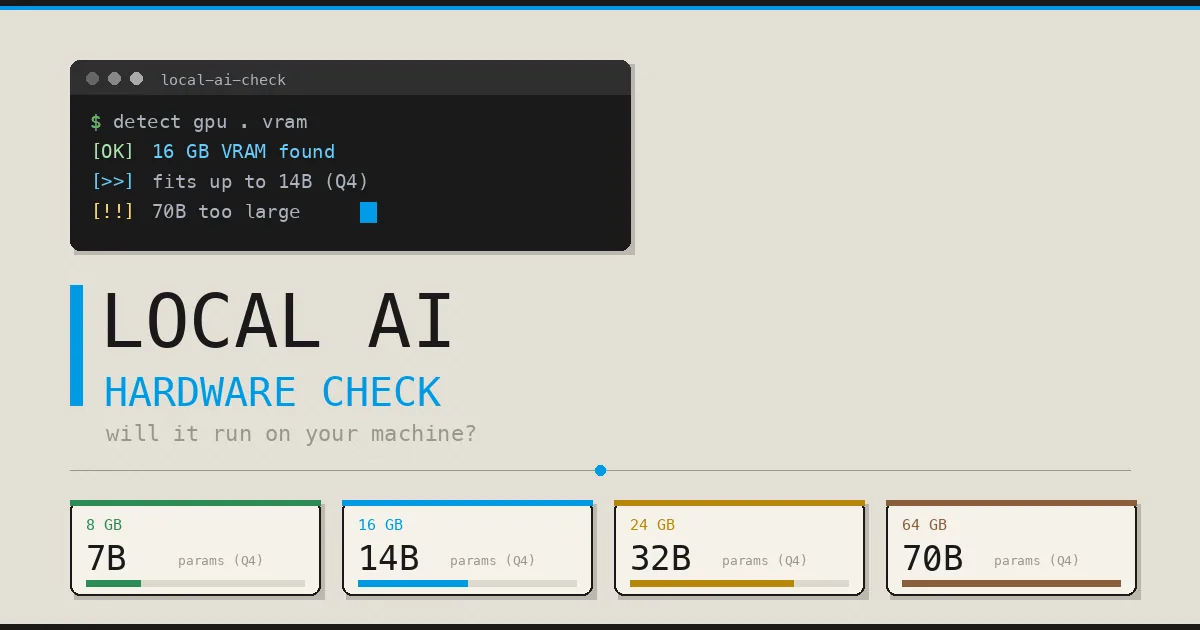
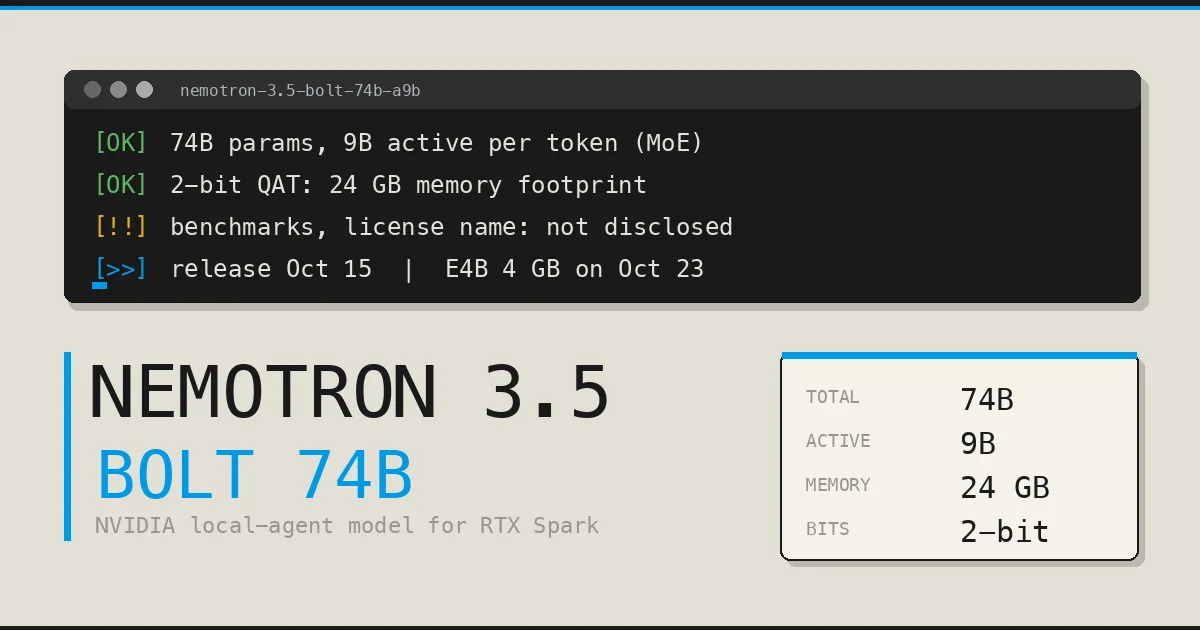
Keputusan NVIDIA untuk mengemas 74 miliar parameter ke dalam footprint memori 24 GB bukan sekadar prestasi teknis; ini adalah strategi untuk menjadikan komputasi edge AI layak di laptop dan workstation kelas menengah. Dengan arsitektur campuran pakar (Mixture of Experts), Nemotron 3.5 Bolt menyimpan 74 miliar parameter tetapi hanya mengaktifkan 9 miliar per token, sehingga beban komputasi per langkah mendekati model 9B sambil tetap menyimpan kapasitas pengetahuan model besar. Dikombinasikan dengan quantization-aware training ke 2 bit, pengembang mendapatkan model AI lokal yang cukup padat untuk dimuat di GPU RTX Spark tanpa mengorbankan terlalu banyak kecerdasan. Dalam konteks laptop AI development, ini berarti satu mesin bisa menjalankan agen AI offline yang canggih sambil tetap menyisakan memori untuk IDE, browser, dan konteks panjang hingga ratusan ribu token.
Secara praktis, dengan memori terpadu hingga 128 GB pada platform RTX Spark, alokasi 24 GB untuk bobot model masih meninggalkan ruang lega untuk konteks, tool tambahan, dan aplikasi lain yang berjalan bersamaan. Di sinilah kompresi menjadi strategi, bukan kompromi: pengembang tidak dipaksa memilih antara model besar dan pengalaman pengguna yang layak. Model card resmi menjelaskan bahwa bagian pakar menggunakan format IQ2-XXS, sementara lapisan lain memakai NVFP4 dan Q8_0, kombinasi yang menunjukkan pendekatan sadar terhadap trade-off presisi dan performa. "Nemotron 3.5 Bolt 74B adalah model bahasa terbuka buatan NVIDIA dengan 74 miliar parameter, 9 miliar di antaranya aktif untuk setiap token, dikompresi ke dua bit sehingga hanya memakan memori 24 GB".
Tiga Varian Nemotron 3.5: Spektrum Baru untuk Agen AI Offline
Peluncuran tiga model Nemotron 3.5 pada 15 Oktober 2026 memperjelas ambisi NVIDIA: membangun spektrum model AI lokal dari kelas ringan hingga berat untuk berbagai skenario agen AI offline. Di ujung atas, Nemotron 3.5 Bolt 74B-A9B 24GB menyasar laptop dan PC dengan GPU RTX Spark dan kartu grafis kelas atas seperti RTX 5090, H100, dan akselerator pusat data, menjadi otak agen pribadi yang selalu menyala untuk pemrograman, riset, dan pemantauan. Di ujung bawah, Bolt E4B 4GB yang dijadwalkan meluncur pada 23 Oktober menawarkan opsi model AI lokal yang jauh lebih kecil untuk gim dan aplikasi ringan, sementara Super VL mengisi ruang vision-language untuk tugas multimodal yang menggabungkan teks dan visual.
Konfigurasi memori yang beragam—4 GB untuk Bolt E4B dan 24 GB untuk Bolt 74B—secara eksplisit menargetkan pengembang yang ingin menyesuaikan agen AI offline dengan kelas perangkat yang berbeda, dari PC gim hingga workstation kreatif. Ini mengubah cara merancang aplikasi: alih-alih memanggil API cloud generik, pengembang dapat memilih model AI lokal yang pas dengan profil hardware pengguna, lalu mengemasnya dalam runtime seperti vLLM atau llama.cpp yang sudah didukung oleh model card. Dalam ekosistem seperti ini, komputasi edge AI tidak lagi terbatas pada prototipe; ia menjadi pilihan desain utama, terutama untuk aplikasi yang membutuhkan latensi rendah dan kontrol penuh atas data.
Dampak untuk Pengembang: Dari Chatbot Cloud ke Agen Pribadi di Laptop
Bagi pengembang, Nemotron 3.5 Bolt menggeser paradigma dari sekadar membangun chatbot berbasis API cloud ke merancang agen AI offline yang hidup di perangkat pengguna. Model ini menerima masukan teks, gambar, dan video hingga dua menit, lalu menjawab dengan teks berformat JSON, penalaran berantai, dan pemanggilan alat. Artinya, satu model AI lokal dapat menjadi pusat orkestrasi workflow: membaca dokumen, menganalisis screenshot, menonton klip singkat, lalu memanggil tool lokal seperti skrip, browser, atau IDE. Agen seperti Hermes dan OpenClaw sudah memanfaatkan Bolt sebagai otak yang selalu menyala di komputer, menyelesaikan tugas atas nama pengguna tanpa perlu koneksi konstan ke cloud. Ini bukan lagi demo futuristik; ini adalah pola kerja baru untuk laptop AI development yang memprioritaskan respons cepat dan kontrol penuh atas lingkungan eksekusi.
Dari sisi biaya dan keamanan, dampaknya jelas: dengan model AI lokal yang dapat berjalan di perangkat keras sendiri, pengembang dan organisasi dapat mengurangi ketergantungan pada infrastruktur pusat data dan menghindari pengiriman data sensitif ke layanan eksternal. Situs teknologi menggambarkan Bolt sebagai "otak agen pribadi" yang cocok untuk pemrograman, riset, dan pemantauan, menegaskan bahwa kasus penggunaan utama adalah pekerjaan intensif pengetahuan yang sebelumnya dianggap domain eksklusif cloud. Kombinasi lisensi terbuka, dukungan komersial, dan kemampuan konteks panjang menjadikan Nemotron 3.5 Bolt menarik untuk membangun aplikasi yang lebih responsif, aman, dan hemat biaya—dari asisten pengembang di laptop hingga agen riset yang terus berjalan di workstation lokal.
Apa yang Berubah untuk Pengguna dan Ke Mana Arah Berikutnya?
Untuk pengguna akhir, konsekuensi paling terasa dari hadirnya Nemotron 3.5 Bolt adalah pengalaman agen AI yang tidak lagi bergantung pada kualitas koneksi internet. Dengan komputasi AI hingga 1 petaflop di platform RTX Spark dan memori terpadu besar, agen lokal dapat merespons dengan cepat, tetap aktif di latar belakang, dan menangani tugas kompleks seperti penjelajahan web, analisis data, atau pemantauan sistem tanpa mengirim setiap permintaan ke server jauh. Portable Computer yang dikembangkan bersama mitra pencarian menunjukkan arah ini: agen yang berjalan di perangkat keras sendiri, memanfaatkan model AI lokal sebagai mesin penalaran inti. Bagi pengguna yang peduli privasi, ini adalah perubahan besar: data kerja sehari-hari dapat tetap berada di laptop, sementara kemampuan AI terus meningkat.
Ke depan, rilis Bolt E4B untuk gim dan kemungkinan kehadiran Super VL di ajang teknologi besar menunjukkan bahwa ekosistem Nemotron 3.5 belum selesai berkembang. Kita masih menunggu pengukuran pihak ketiga untuk menguji klaim kecepatan dan kecerdasan Bolt dibanding model padat lain, tetapi arah strateginya sudah jelas: membawa AI kelas besar ke komputasi edge AI dan menjadikannya standar baru untuk agen AI offline. Jika tren ini berlanjut, developer yang tetap bergantung penuh pada API cloud akan tampak ketinggalan. Masa depan yang lebih menarik adalah ketika setiap laptop pengembang menjadi laboratorium AI lengkap, dengan model AI lokal seperti Nemotron 3.5 Bolt sebagai inti, dan cloud hanya menjadi pelengkap, bukan tulang punggung.