
Dari Cloud ke Perangkat: Paradigma Baru Model AI Lokal
Model AI lokal adalah pendekatan komputasi kecerdasan buatan di mana model besar dijalankan langsung di perangkat pengguna—seperti PC, laptop, atau perangkat edge—tanpa bergantung pada server cloud eksternal, sehingga organisasi dapat menjaga data tetap berada di infrastruktur sendiri, mengurangi latensi jaringan, dan mengendalikan biaya komputasi jangka panjang sambil tetap memanfaatkan kemampuan agen AI canggih untuk otomatisasi, analisis, dan interaksi multimodal yang sebelumnya hanya mungkin di pusat data besar. Nemotron Bolt 74B menandai titik balik: model bahasa terbuka dengan 74 miliar parameter, 9 miliar di antaranya aktif per token, dikompresi hingga muat dalam 24 GB memori dan dirilis pada 15 Oktober sebagai otak agen AI lokal di laptop ber-GPU RTX AI. Ini bukan sekadar peningkatan teknis, melainkan pergeseran kekuasaan dari penyedia cloud ke pemilik perangkat.
Nemotron Bolt 74B: 74 Miliar Parameter di 24 GB, Bukan Sekadar Trik Teknis
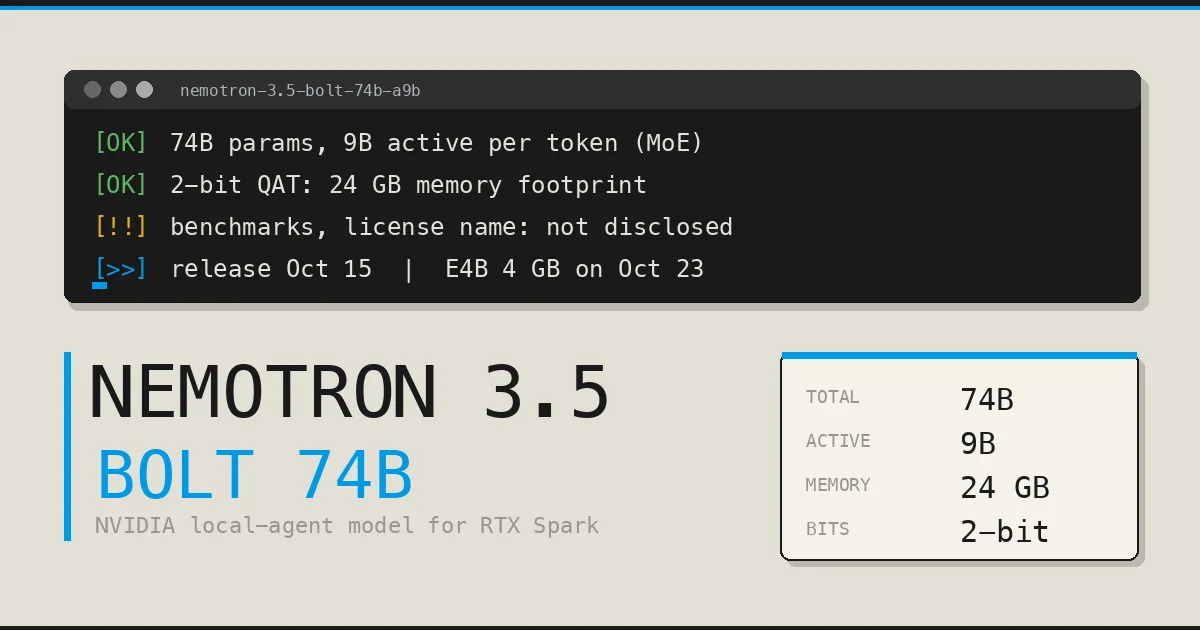
Nemotron Bolt 74B adalah jawaban keras terhadap anggapan bahwa agen AI serius harus hidup di pusat data. Dengan arsitektur campuran pakar (Mixture of Experts), ia menyimpan 74 miliar parameter tetapi hanya mengaktifkan 9 miliar per token, lalu mengompres bobot ke format 2-bit sehingga totalnya muat di 24 GB memori dan dapat dijalankan lokal di GPU RTX dan sistem Spark. Ini membuat deployment AI offline bukan lagi eksperimen, melainkan opsi produksi yang masuk akal. Kuantisasi sadar pelatihan mengurangi kerugian akurasi, sementara konteks hingga ratusan ribu token membuka pintu untuk agen yang memantau sistem, dokumen, atau alur kerja dalam jangka panjang. "Bolt 74B-A9B 24GB menggunakan kuantisasi native 2-bit agar muat dalam memori 24GB dan dapat dijalankan secara lokal di NVIDIA RTX dan DGX Spark bersama aplikasi lain". Pernyataan ini pada dasarnya adalah manifesto: AI kelas enterprise harus bisa tinggal di PC.
| Spesifikasi | Nemotron 3.5 Bolt 74B-A9B | Nemotron 3.5 Super VL |
|---|---|---|
| Jenis | Model bahasa lokal untuk agen AI | Model multimodal untuk agen kompleks |
| Parameter total | 74 miliar | 120 miliar |
| Parameter aktif per token | 9 miliar | 12 miliar |
| Kebutuhan memori | 24 GB, kuantisasi 2-bit | Tidak disebut, kelas pusat data |
| Target perangkat | Laptop/PC dengan GPU RTX AI dan Spark | Server perusahaan dan perangkat edge |
Super VL dan Bolt E4B: Spektrum Penuh Agen AI Edge Computing
Bolt 74B bukan berdiri sendiri; ia bagian dari strategi yang lebih besar untuk agen AI edge computing. Pada hari yang sama, NVIDIA merilis Nemotron 3.5 Super VL, model multimodal terbuka dengan 120 miliar parameter dan 12 miliar parameter aktif per token, ditujukan untuk agen khusus yang selalu aktif dan menangani tugas multimodal kompleks seperti mengikuti instruksi, menggunakan alat, dan memahami teks, gambar, dokumen, serta video. Di ujung lain, Bolt E4B berukuran 4 GB ditargetkan ke perangkat dengan sumber daya terbatas, termasuk GeForce RTX, Jetson, dan perangkat pintar yang membutuhkan percakapan dan kemampuan agentik multi-giliran secara lokal. Ketiga model ini bersama-sama menutup celah dari pusat data hingga PC dan perangkat tertanam: satu keluarga model AI lokal yang memaksa arsitek sistem berpikir ulang tentang di mana agen AI seharusnya tinggal—di cloud, atau sedekat mungkin dengan pengguna.
Dampak Nyata: Privasi, Latensi, dan Kedaulatan Data Pengguna
Konsekuensi paling penting dari model AI lokal seperti Nemotron Bolt 74B adalah kedaulatan data. Dengan bobot terbuka, pengembang dapat mengunduh model, menjalankannya di infrastruktur sendiri, dan menyesuaikan perilaku untuk kebutuhan spesifik tanpa mengirim percakapan, dokumen, atau log operasional ke cloud pihak ketiga. Untuk agen AI edge computing yang selalu aktif—misalnya asisten suara di perangkat rumah, agen pemantau sistem di laptop kerja, atau chatbot internal perusahaan—deployment AI offline mengurangi latensi sekaligus menurunkan risiko kebocoran data. Bolt 74B dirancang sebagai otak agen pribadi yang selalu menyala, cocok untuk pemrograman, riset, dan pemantauan lokal. Ini memindahkan nilai tambah AI dari layanan berlangganan ke kemampuan bawaan perangkat: GPU RTX AI di laptop bukan lagi akselerator grafis, melainkan mesin inferensi yang memungkinkan organisasi menyimpan kecerdasan di sisi mereka sendiri.
Mengapa Langkah Ini Penting dan Apa yang Akan Terjadi Selanjutnya
Rilis tiga model Nemotron baru terjadi di tengah perlombaan untuk menghadirkan model besar yang bisa disimpan dan dijalankan di komputer sendiri. Ini bukan kebetulan, melainkan respons terhadap tekanan industri: perusahaan ingin agen AI yang kuat, tetapi enggan menyerahkan semua data dan kontrol ke cloud tertutup. Dengan Super VL untuk server dan agen multimodal, Bolt 74B untuk PC, dan Bolt E4B untuk perangkat kecil, NVIDIA menyatakan bahwa mereka kini mencakup seluruh spektrum penerapan agen, dari pusat data hingga perangkat edge dan lokal. Bolt E4B dijadwalkan hadir pada 23 Oktober, sementara evaluasi pihak ketiga atas kinerja Bolt 74B masih dinanti dan akan memperjelas seberapa jauh kompromi antara kompresi dan kecerdasan. Namun arah besarnya sudah jelas: generasi berikutnya agen AI tidak akan bergantung pada koneksi internet yang stabil, melainkan pada kemampuan GPU di perangkat yang sudah ada di meja kerja kita.