
Nilai AI kini ditentukan oleh biaya setiap keluaran
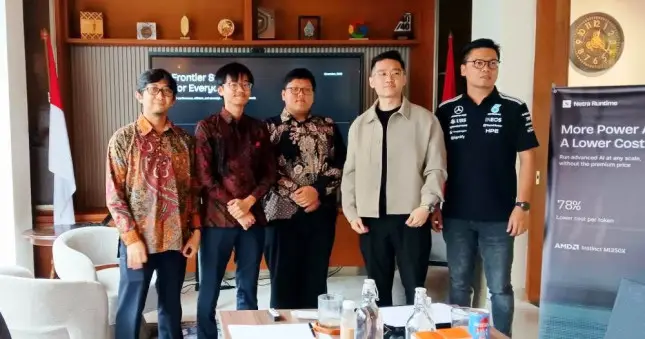
Inferensi AI adalah tahap ketika model yang telah dilatih memproses permintaan dan menghasilkan keluaran, seperti jawaban teks, bagi pengguna atau sistem. Kualitas model penting, tetapi kecepatan dan biaya menjalankannya ikut menentukan apakah AI layak dipakai dalam operasi sehari-hari. Pada 30 Oktober 2026, Init-6 memperkenalkan Netra Runtime sebagai portofolio investasi terbarunya, mendukung startup asal Indonesia yang membangun infrastruktur untuk mengoptimalkan pemrosesan model pada GPU pelanggan maupun cloud. Langkah ini tepat sasaran: ketika pemakaian AI meningkat, perusahaan perlu mengendalikan biaya tiap keluaran, bukan sekadar mengejar model paling canggih. “Pertanyaan bagi perusahaan bukan lagi sekadar model mana yang paling pintar dan paling cepat, tetapi berapa biaya untuk menghasilkan suatu pekerjaan,” kata Nugroho Herucahyono, Founding Partner Init-6. Investasi startup AI ini menyoroti lapisan yang sering luput dari perhatian, yaitu perangkat lunak yang membuat kapasitas komputasi bekerja lebih efektif.
Dua jalur: GPU privat dan cloud
Netra Runtime menawarkan dua cara mengakses inferensi AI. Perusahaan yang sudah memiliki GPU dapat melisensikan perangkat lunak Netra untuk dijalankan pada infrastruktur sendiri. Opsi GPU privat ini memberi pelanggan kendali lebih besar atas lokasi pemrosesan, model, dan data—pertimbangan penting bagi organisasi dengan informasi sensitif. Bagi perusahaan yang belum ingin membeli, mengoperasikan, atau merawat perangkat keras, Netra Cloud menyediakan inferensi terkelola melalui API yang kompatibel dengan OpenAI. Biayanya dihitung berdasarkan jumlah token yang digunakan, sehingga pelanggan dapat mengakses layanan tanpa membangun sistem GPU sendiri. Kedua pilihan memakai teknologi inti yang sama, tetapi menjawab kebutuhan berbeda: mengoptimalkan aset komputasi yang telah dimiliki atau menghindari pengelolaan perangkat keras. Fleksibilitas ini menjadi kekuatan komersial Netra, meski perusahaan tetap harus membuktikan bahwa kinerja dan efisiensi biayanya sesuai dengan beban kerja nyata pelanggan.
Angka awal menjanjikan, tetapi perlu diuji
Netra melaporkan telah memproses lebih dari 288 miliar token hingga 28 Oktober 2026. Pada 21–27 Oktober, rata-rata pemrosesan mencapai 6,14 miliar token per hari dan rekor harian tercatat 12,47 miliar token; platform juga memiliki 1.415 pengguna terdaftar dan 19 mitra. Dalam benchmark perusahaan, throughput prefill mencapai 73.527 token input per detik pada konkurensi 32 tanpa cache. Konfigurasi empat GPU AMD Instinct MI350X mencatat throughput decode agregat 5.062 token output per detik pada konkurensi 32, sementara kecepatan decode per pengguna mencapai 1.152 token per detik pada konkurensi satu. Angka ini memberi gambaran tentang ambisi teknis Netra, bukan jaminan hasil serupa di setiap penerapan. Kinerja bergantung pada model, perangkat keras, pola trafik, dan konfigurasi. Karena itu, keputusan pembelian sebaiknya mengikuti pengujian dengan kebutuhan operasional pelanggan sendiri.
Peluang bisnis ada pada lapisan yang kurang terlihat
Netra membidik pasar yang tumbuh seiring perusahaan beralih dari eksperimen AI ke pemakaian produksi. Memiliki GPU berperforma tinggi saja tidak menjamin inferensi berlangsung cepat atau efisien; perangkat lunak, penjadwalan, dan jalur runtime turut menentukan berapa banyak permintaan yang dapat dilayani. Di sinilah Netra ingin bersaing, dengan mengoptimalkan pemrosesan untuk pelanggan yang mengutamakan kendali maupun yang membutuhkan akses cloud yang lebih praktis. Netra telah mengundang calon pengguna untuk menguji teknologinya dengan model, perangkat keras, dan pola trafik mereka sendiri. Fokus jangka pendeknya adalah membuktikan performa bagi pelanggan korporasi sebelum memperluas penggunaan ke pasar global. Strategi itu masuk akal: klaim benchmark membuka pintu, tetapi hasil konsisten dalam kondisi nyata yang akan membangun kepercayaan. Investasi Init-6 memberi Netra dorongan penting, namun peluang bisnisnya akan ditentukan oleh kemampuannya menurunkan beban biaya tanpa mengorbankan kecepatan, kendali, dan keandalan.