
Dari rekaman ke jawaban yang bisa ditindaklanjuti
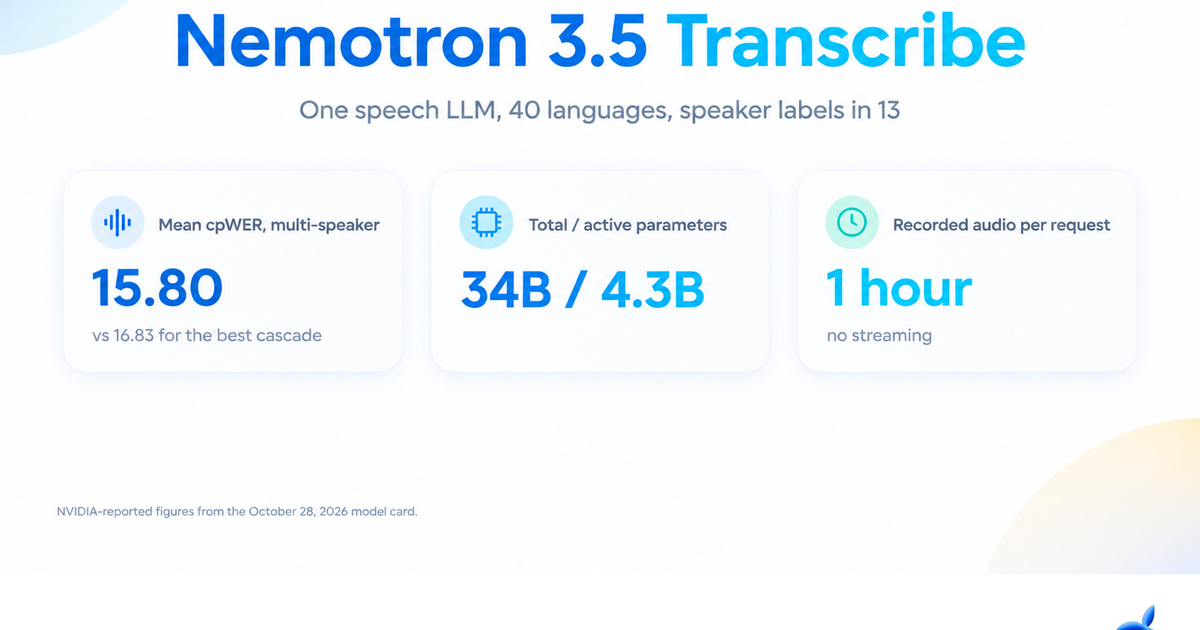
Nemotron 3.5 Transcribe adalah model AI berbobot terbuka yang mengubah rekaman suara menjadi teks, mengenali penutur, menerjemahkan ujaran, dan menjawab pertanyaan tentang isi audio dalam satu sistem. NVIDIA merilis model ini pada 28 Oktober 2026, menawarkan pendekatan yang lebih berguna daripada transkripsi mentah bagi orang yang harus menindaklanjuti rapat.
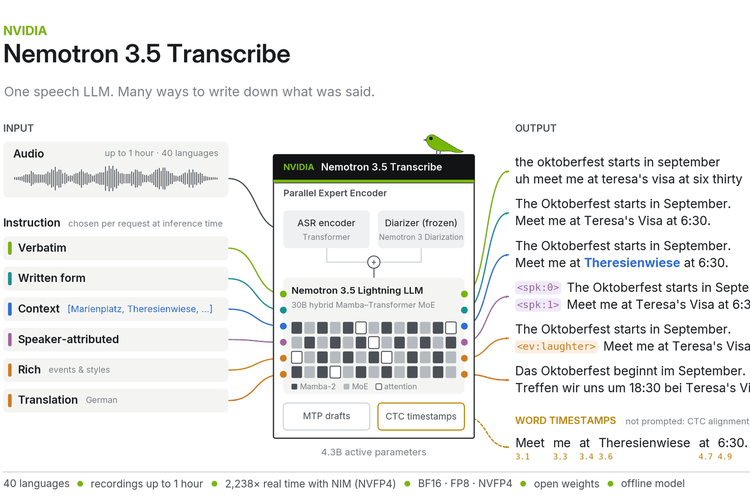
Nilai praktisnya terletak pada perintah yang dapat ditulis dengan bahasa sehari-hari. Pengguna bisa meminta transkrip dengan label pembicara, terjemahan ke bahasa Inggris, atau daftar keputusan yang dibuat dalam rapat. Dengan begitu, ringkasan rekaman rapat tidak harus disusun dengan membaca ulang seluruh percakapan. Model ini menggabungkan transkripsi multibahasa, atribusi penutur, penerjemahan, dan tanya jawab audio dalam satu checkpoint—sebuah penyederhanaan alur kerja yang layak diuji, bukan alasan untuk menganggap hasilnya selalu sempurna.
Dukungan bahasa Indonesia, dengan catatan mutu
Nemotron 3.5 Transcribe mendukung transkripsi dalam 40 bahasa, termasuk bahasa Indonesia. Untuk pengguna, ini berarti rekaman rapat atau wawancara berbahasa Indonesia dapat diubah menjadi teks tanpa harus lebih dulu diterjemahkan ke bahasa lain. Model ini juga dapat menangani percakapan yang mencampur bahasa Indonesia dan bahasa lain, seperti sisipan istilah bahasa Inggris yang lazim di lingkungan kerja.
Namun, label dukungan bahasa Indonesia tercatat sebagai tingkat “Supported”, bukan kategori tertinggi yang menandakan dukungan terdepan atau siap produksi. Itu alasan untuk memeriksa hasil, terutama pada nama orang, istilah teknis, dan percakapan yang saling tumpang tindih. Meski demikian, kemampuan AI audio bahasa Indonesia ini memberi pengembang titik awal yang menjanjikan untuk membuat alur transkripsi audio AI yang lebih sesuai dengan percakapan lokal.
Satu sistem, tetapi bukan untuk semua kebutuhan
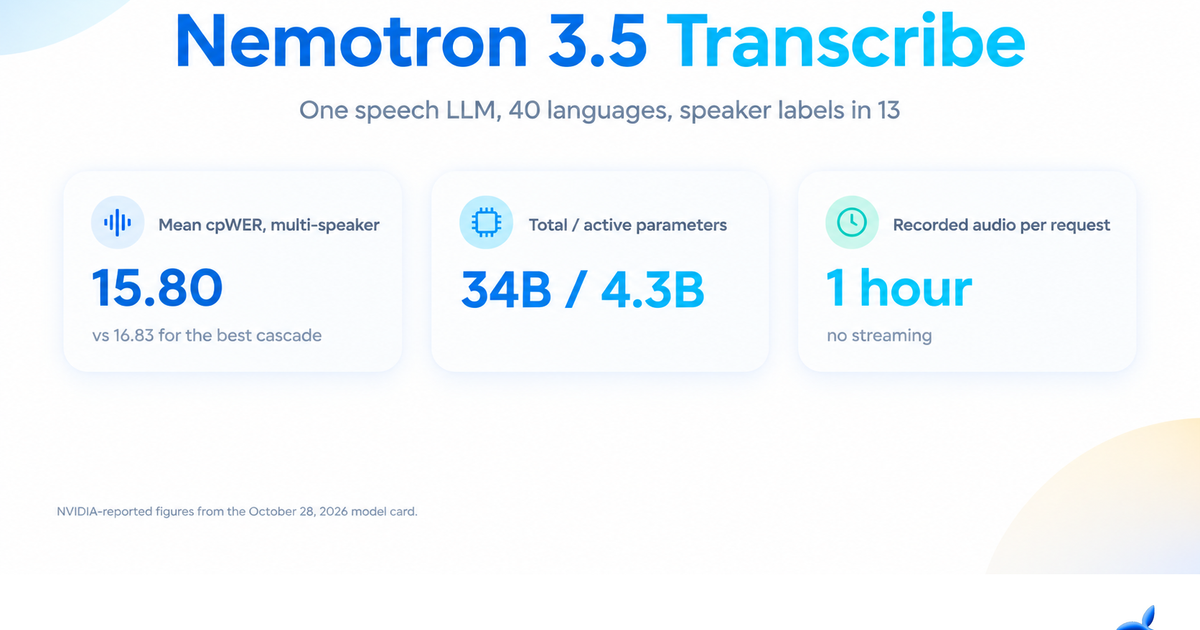
Keunggulan yang ditawarkan bukan hanya jumlah bahasa, melainkan penggabungan beberapa tugas audio sekaligus. Pengguna dapat meminta transkrip verbatim atau versi yang dirapikan, memberikan kosakata kontekstual, meminta stempel waktu pada tingkat kata, lalu mengajukan pertanyaan tentang rekaman. Model ini dirancang untuk berkas audio berdurasi hingga satu jam dan dapat memberi label sampai delapan penutur.
Batasannya penting: diarisasi—pengenalan siapa yang berbicara—hanya tersedia untuk 13 bahasa, bukan seluruh 40 bahasa yang didukung untuk transkripsi. Selain itu, model ini tidak memiliki pemrosesan streaming; cara kerjanya adalah audio masuk, lalu transkrip keluar. Artinya, ia lebih cocok untuk mengolah rekaman setelah rapat daripada menampilkan transkrip langsung saat percakapan berlangsung. Klaim bahwa satu model dapat menggantikan rangkaian alat transkripsi dan pelabelan penutur menarik, tetapi manfaatnya tetap bergantung pada bahasa, mutu audio, dan kebutuhan kecepatan pengguna.
Potensi terbuka, verifikasi tetap perlu
Peluncuran ini datang bersama Granary v2, inisiatif data terbuka yang menjadi dasar pelatihan model. Manifes publiknya mencakup 463.062 jam audio dalam 48 bahasa dan 16 korpus sumber, meningkat dari 25 bahasa pada Granary v1. Skala data itu membantu menjelaskan ambisi produk, tetapi tidak otomatis menjamin transkrip setiap rapat akan akurat; pengujian pada rekaman dan istilah yang benar-benar digunakan tetap diperlukan.
Bagi tim yang sering mengubah percakapan menjadi notulen, Nemotron 3.5 Transcribe menjanjikan lompatan dari sekadar teks menuju catatan yang lebih siap dipakai: siapa mengatakan apa, apa yang diputuskan, dan pertanyaan apa yang masih perlu dijawab. Kesimpulannya, model ini patut dicoba untuk pemrosesan rekaman berbahasa Indonesia, tetapi belum menggantikan pemeriksaan manusia atau kebutuhan transkripsi langsung. Nilainya paling besar ketika pengguna menganggap AI sebagai penyusun draf dan verifikasi sebagai bagian dari pekerjaan.