
Satu model untuk lebih dari sekadar transkrip
Nemotron 3.5 Transcribe adalah model ucapan berbobot terbuka NVIDIA yang memproses audio untuk menghasilkan transkrip, mengenali penutur, menerjemahkan ujaran, dan menjawab pertanyaan tentang isi rekaman dalam satu sistem. Pada 28 Oktober 2026, NVIDIA merilis model ini dengan keempat kemampuan tersebut dalam satu checkpoint. Ini membuatnya menarik bukan karena sekadar menambah bahasa dalam daftar dukungan, melainkan karena berpotensi menggantikan rangkaian pengenal ucapan dan diarisasi audio yang biasanya terdiri dari beberapa komponen. Pengguna dapat meminta transkrip verbatim atau teks yang dirapikan, memberi konteks istilah, serta menyertakan label penutur dan penanda waktu. Untuk tim yang mengolah rekaman rapat atau wawancara, penggabungan ini bisa menyederhanakan alur kerja dan mengurangi kebutuhan menyambungkan model berbeda. Namun, janji satu checkpoint tidak berarti satu solusi untuk setiap produk: kemampuan yang tersedia bergantung pada bahasa dan kebutuhan pemrosesan.
Cakupan bahasa tidak sama untuk setiap tugas
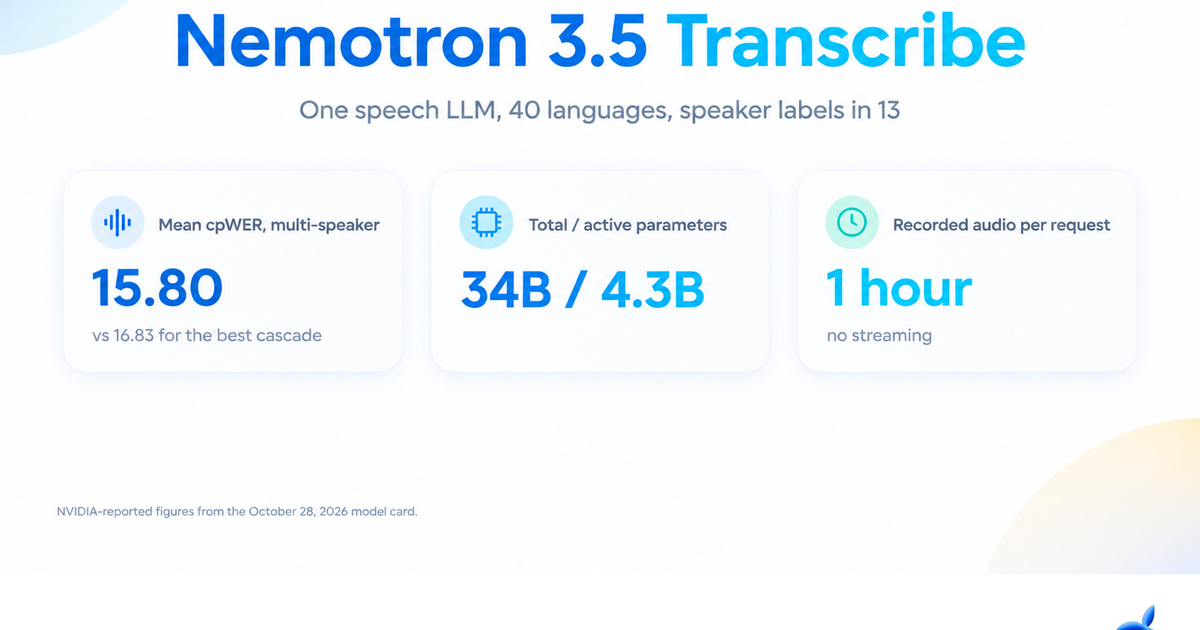
Angka 40 terdengar luas, tetapi jangan menganggap semua fitur bekerja dalam 40 bahasa. Model mendukung transkripsi multibahasa dalam 40 bahasa dan penerjemahan ke atau dari bahasa Inggris dalam 32 bahasa, sedangkan diarisasi—pengenalan siapa yang berbicara—hanya tersedia dalam 13 bahasa. Perbedaan ini menentukan nilai praktisnya: rekaman berbahasa Polandia, Turki, atau Vietnam, misalnya, dapat ditranskripsikan tanpa atribusi penutur, sehingga kebutuhan untuk membedakan pembicara masih memerlukan komponen lain. Model dapat memproses rekaman hingga satu jam dan memberi label hingga delapan penutur. Itu berguna untuk berkas panjang, tetapi formatnya tetap berkas-masuk dan transkrip-keluar; model tidak mendukung streaming. Jadi, ia lebih sesuai untuk pemrosesan rekaman setelah acara daripada aplikasi yang harus menampilkan teks secara langsung.
| Kemampuan | Cakupan atau batas |
|---|---|
| Transkripsi | 40 bahasa |
| Penerjemahan | 32 bahasa, ke atau dari bahasa Inggris |
| Diarisasi | 13 bahasa; hingga delapan penutur |
| Panjang rekaman | Hingga satu jam; tanpa streaming |
Benchmark menjanjikan, tetapi bukan bukti universal
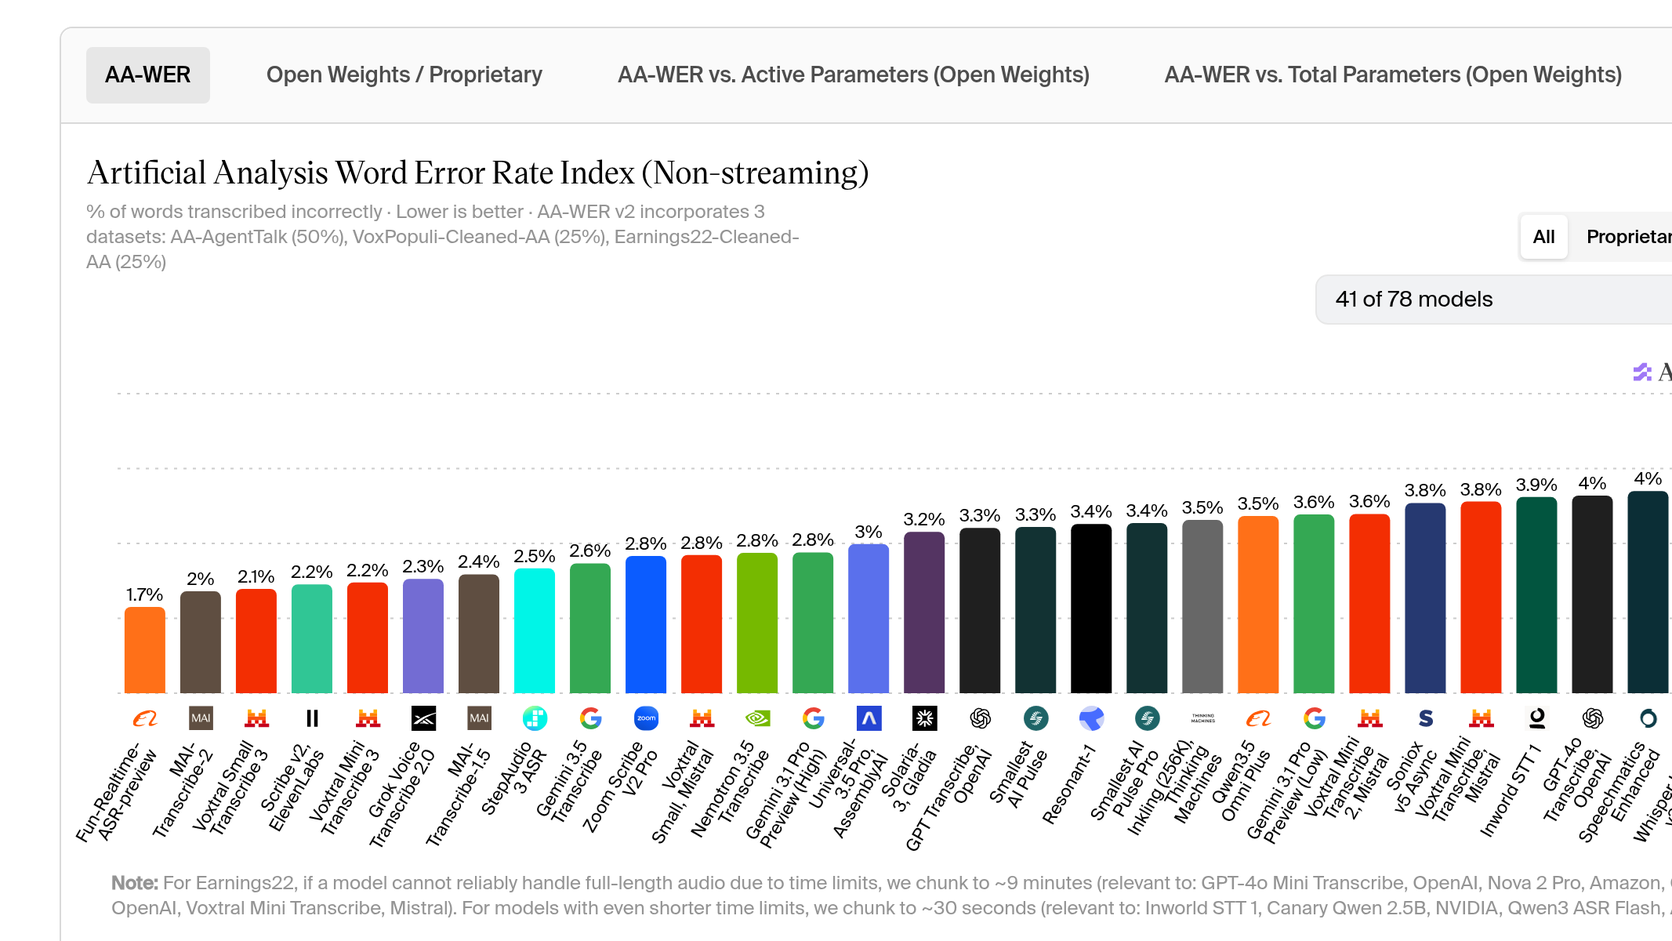
Hasil yang paling menarik bagi tim teknis adalah rata-rata 15,80 cpWER pada set tolok ukur multi-penutur NVIDIA, dibandingkan 16,83 untuk DiCoW v3.3 yang dipasangkan dengan DiariZen. Angka lebih rendah menunjukkan hasil yang lebih baik pada ukuran tersebut, dan perbandingan ini mendukung klaim bahwa satu model dapat menandingi bahkan mengungguli susunan transkripsi serta diarisasi terpisah. Tetapi hasil itu bukan jaminan bahwa Nemotron akan unggul pada semua bahasa, jenis rekaman, atau beban kerja. Cakupan diarisasi yang hanya 13 bahasa dan ketiadaan streaming membatasi situasi yang dapat dibandingkan secara langsung. Ukuran model juga perlu diperhitungkan: sistem berjumlah 34 miliar parameter, dengan sekitar 4,3 miliar aktif untuk setiap token; encoder ucapan menambah sekitar 800 juta parameter di atas model bahasa 30 miliar. Bagi tim, tolok ukur terbaik tetap uji pada audio dan bahasa yang benar-benar akan mereka proses.
Granary v2 memperkuat fondasi, bukan menghapus pekerjaan
Bersamaan dengan model, NVIDIA merilis Granary v2, dataset ucapan terbuka dengan manifes publik yang mencakup 463.062 jam audio dalam 48 bahasa dari 16 korpus sumber. Skala ini memberi konteks pada upaya membangun sistem ucapan multibahasa, sementara manifes dan alur kurasinya dapat membantu pihak yang ingin menyesuaikan model. Namun, istilah “terbuka” perlu dibaca dengan cermat: audio sumber tetap harus diperoleh menurut lisensi masing-masing korpus dan tidak otomatis tersedia untuk dibagikan ulang. Sebelum memilih model transkripsi terbuka ini, tim sebaiknya memeriksa apakah bahasa mereka termasuk dalam dukungan diarisasi, apakah hasil waktu nyata diperlukan, serta apakah infrastruktur dapat melayani model sebesar ini. Model bisa menjadi pilihan kuat untuk transkripsi berkas dan rekaman multi-penutur dalam bahasa yang didukung. Untuk streaming atau bahasa di luar cakupan diarisasi, arsitektur gabungan dengan komponen tambahan mungkin masih lebih masuk akal.
Kesimpulan: pilih berdasarkan alur kerja, bukan angka bahasa
Nemotron 3.5 Transcribe layak diperhatikan karena menyatukan transkripsi, atribusi penutur, penerjemahan, dan tanya jawab audio, lalu mencatat hasil 15,80 cpWER pada benchmark multi-penutur yang dilaporkan. Namun, keunggulan itu paling relevan bagi tim yang memproses rekaman, bukan audio langsung, dan bekerja dalam salah satu dari 13 bahasa yang mendukung diarisasi. Dukungan transkripsi untuk 40 bahasa memang luas, tetapi tidak menghilangkan kesenjangan fitur maupun kebutuhan menguji kualitas pada data sendiri. Granary v2 menambah nilai sebagai fondasi terbuka, meski akses ke audio sumber tetap mengikuti lisensi korpusnya. Kesimpulannya, model ini menjanjikan sebagai cara merampingkan tumpukan transkripsi untuk kasus yang cocok—bukan alasan untuk mengabaikan batas bahasa, kebutuhan streaming, dan biaya operasional penerapan.