
Benchmark menilai lebih dari satu angka
Benchmark model AI adalah pengujian terstruktur yang mengukur kinerja model pada tugas tertentu; hasilnya hanya berguna jika metrik, unit biaya, dan kondisi pengujian sebanding. Karena itu, angka skor tidak otomatis menunjukkan model mana yang paling tepat untuk dibeli atau diterapkan. Tiga perbandingan ini memperlihatkan trade-off berbeda: usia dan kemampuan Mistral Large 4 serta Llama 4 Maverick, validitas skor coding SWE-2 Flash dan Flint v1.0, serta cara tagihan pplx-decider-flash berubah menurut jumlah pertanyaan.
Kesimpulan praktisnya: pilih model yang lebih baru dan berkemampuan tinggi untuk tugas sulit, model terbuka bila kendali deployment lebih penting, dan model kecil bila pola permintaan cocok dengan aturan penagihannya. Harga model AI bukan ukuran nilai yang berdiri sendiri. Skor dari versi benchmark, set tugas, atau format permintaan berbeda dapat terlihat berdekatan, tetapi tidak layak dianggap setara.
Usia dan skala mengubah arti perbandingan
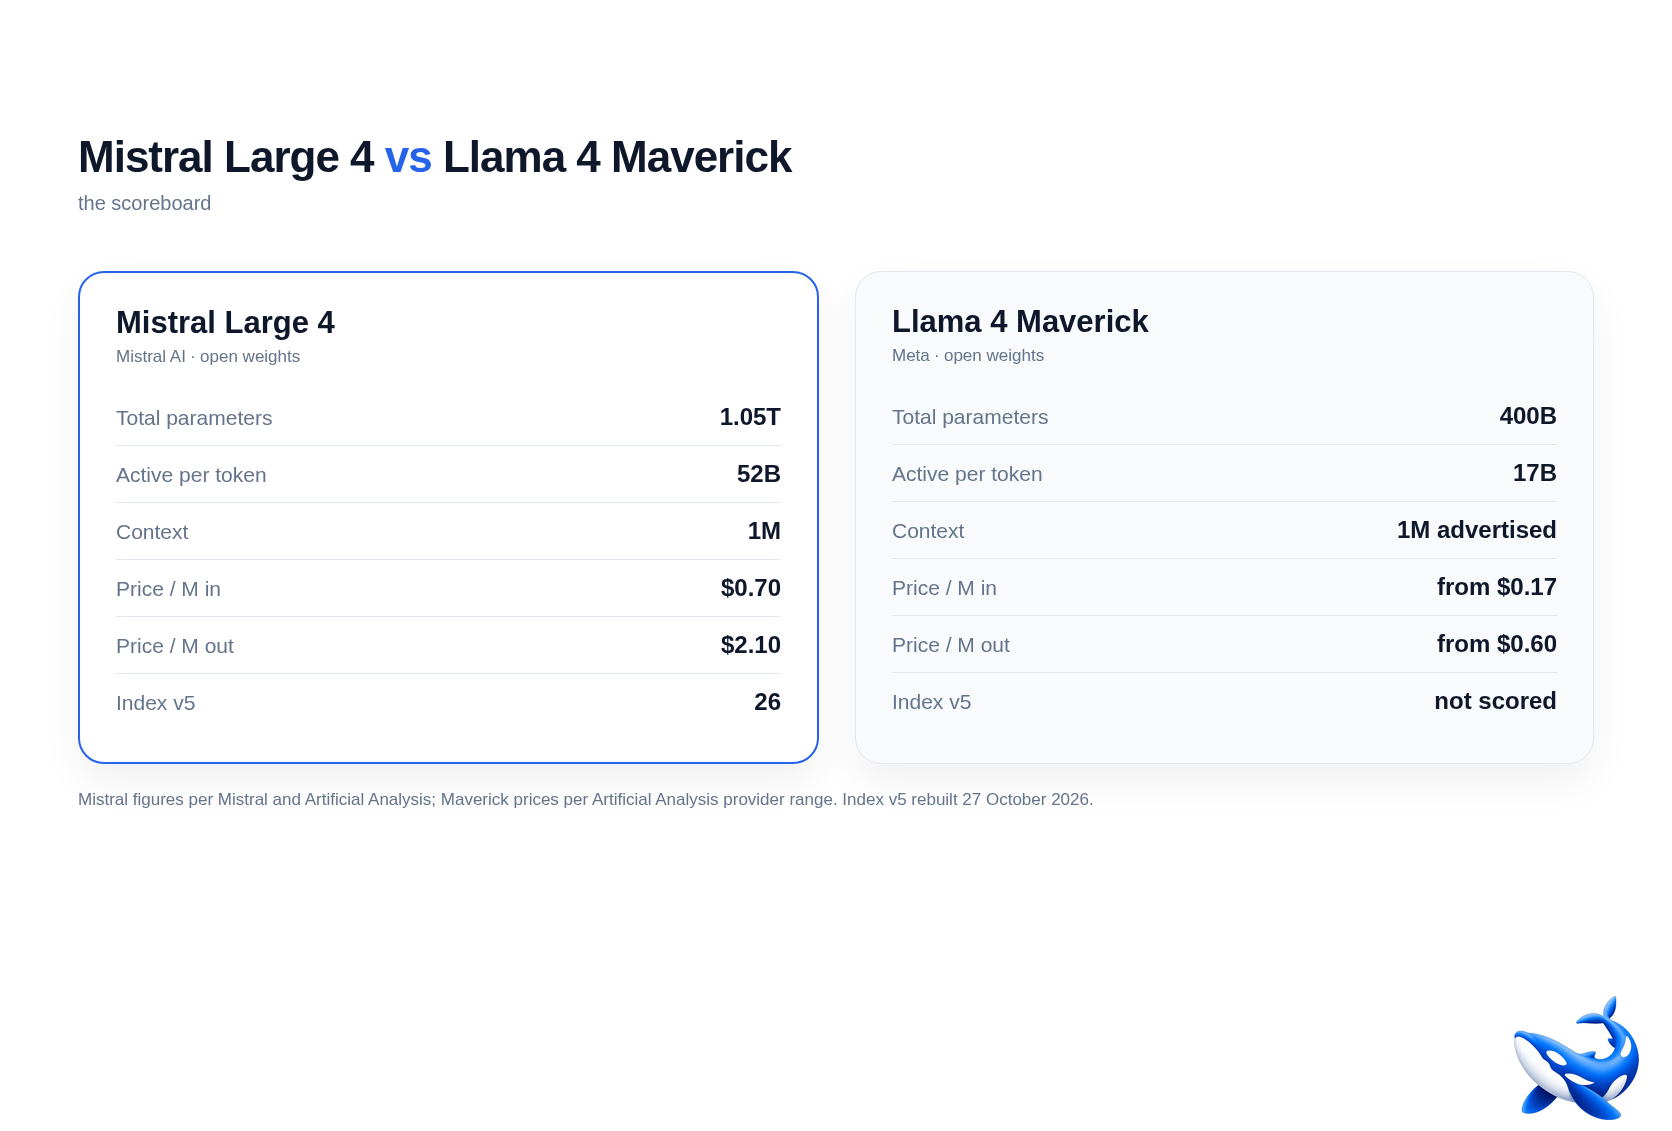
Mistral Large 4 dan Llama 4 Maverick sama-sama model sparse dengan input teks dan gambar serta jendela konteks yang diiklankan hingga satu juta token. Namun, keduanya terpaut 19 bulan: Maverick dirilis pada April 2025, sedangkan Mistral Large 4 hadir pada Oktober 2026. Mistral memiliki 1,05 triliun parameter total dan 52 miliar aktif per token; Maverick memiliki sekitar 400 miliar total dan 17 miliar aktif. Selisih usia dan kapasitas ini membuat perbandingan biaya saja menyesatkan: Mistral ditujukan untuk penalaran, dokumen panjang, dan coding agentik, sementara Maverick tetap masuk akal untuk ekstraksi sederhana atau kebutuhan bobot terbuka.
| Aspek | Mistral Large 4 | Llama 4 Maverick |
|---|---|---|
| Rilis | Oktober 2026 | April 2025 |
| Parameter total | 1,05 triliun | Sekitar 400 miliar |
| Parameter aktif | 52 miliar | 17 miliar |
| Konteks yang diiklankan | 1 juta token | 1 juta token |
| Modalitas masukan | Teks dan gambar | Teks dan gambar |
| Bobot terbuka | Ya | Ya |
| Penalaran | Mode upaya rendah, sedang, dan tinggi | Tidak mencantumkan mode penalaran |
Mistral meraih skor 26 pada Artificial Analysis Intelligence Index v5 dengan pengaturan penalaran tinggi dan melaporkan 41% pada Terminal-Bench 4.0. Namun, tidak ada harness bersama yang menjalankan kedua model dalam kondisi identik, dan Maverick tidak memiliki skor indeks v5 yang sebanding. Jadi, angka tersebut mendukung penilaian arah—model yang lebih baru dan lebih besar tampak lebih cocok untuk tugas sulit—bukan klaim selisih kemampuan yang terukur bersih. Pilih Maverick bila fine-tuning, operasi terisolasi, atau tugas ringan menjadi prioritas; pilih Mistral untuk kemampuan lebih tinggi pada pekerjaan kompleks.
Skor coding yang mirip belum tentu sebanding
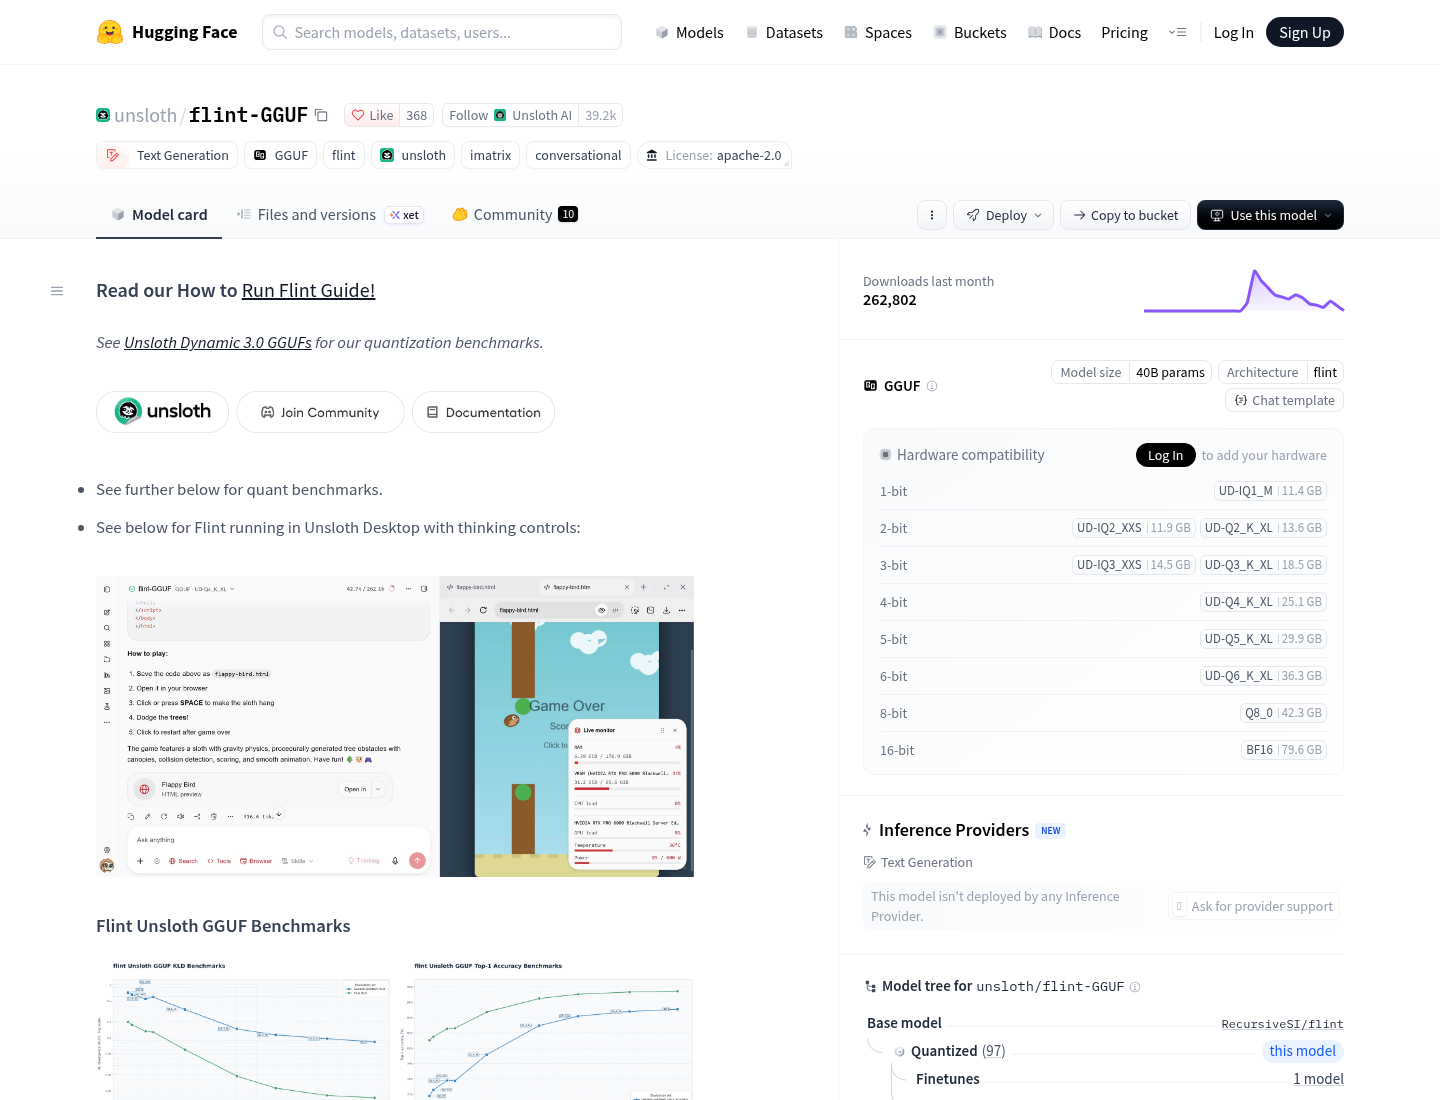
SWE-2 Flash dan Flint v1.0 dirilis berselang sekitar dua minggu, tetapi skala serta aksesnya berbeda tajam. SWE-2 Flash memiliki 276 miliar parameter total dan 12 miliar aktif; Flint memiliki 39,8 miliar total dan sekitar 2,5 miliar aktif. Perbedaan penggunaan juga penting: Flint menyediakan bobot berlisensi Apache 2.0 yang dapat dijalankan di perangkat sendiri, sedangkan SWE-2 Flash hanya tersedia melalui Devin Desktop dan Devin CLI. Jika residensi data, fine-tuning, atau operasi offline menjadi syarat, Flint menawarkan kebebasan yang tidak diberikan oleh skor benchmark.
Keduanya melaporkan hasil pada SWE-bench Pro yang sekilas hampir sama: 89,7 untuk Flint pada v2 dan 89,9 untuk SWE-2 Flash pada v2 Hard. Namun, versi dan subset tugasnya berbeda, sehingga menyebut hasil itu seri adalah kesimpulan yang tidak sah. Pada satu baris yang benar-benar sama, Terminal-Bench 2.1, SWE-2 Flash mencatat 89,2 dan Flint 54,9. Selisih tersebut patut diperhatikan, tetapi kondisi pelaporan tidak sepenuhnya transparan: satu pihak menjelaskan cara mendapat skor, sedangkan pihak lain tidak, dan belum ada reproduksi pihak ketiga. Pilih SWE-2 Flash bila sudah bekerja di Devin dan mengutamakan hasil pada tugas tersebut; pilih Flint bila keterbukaan dan kendali lebih bernilai.
Biaya per token bukan biaya per permintaan
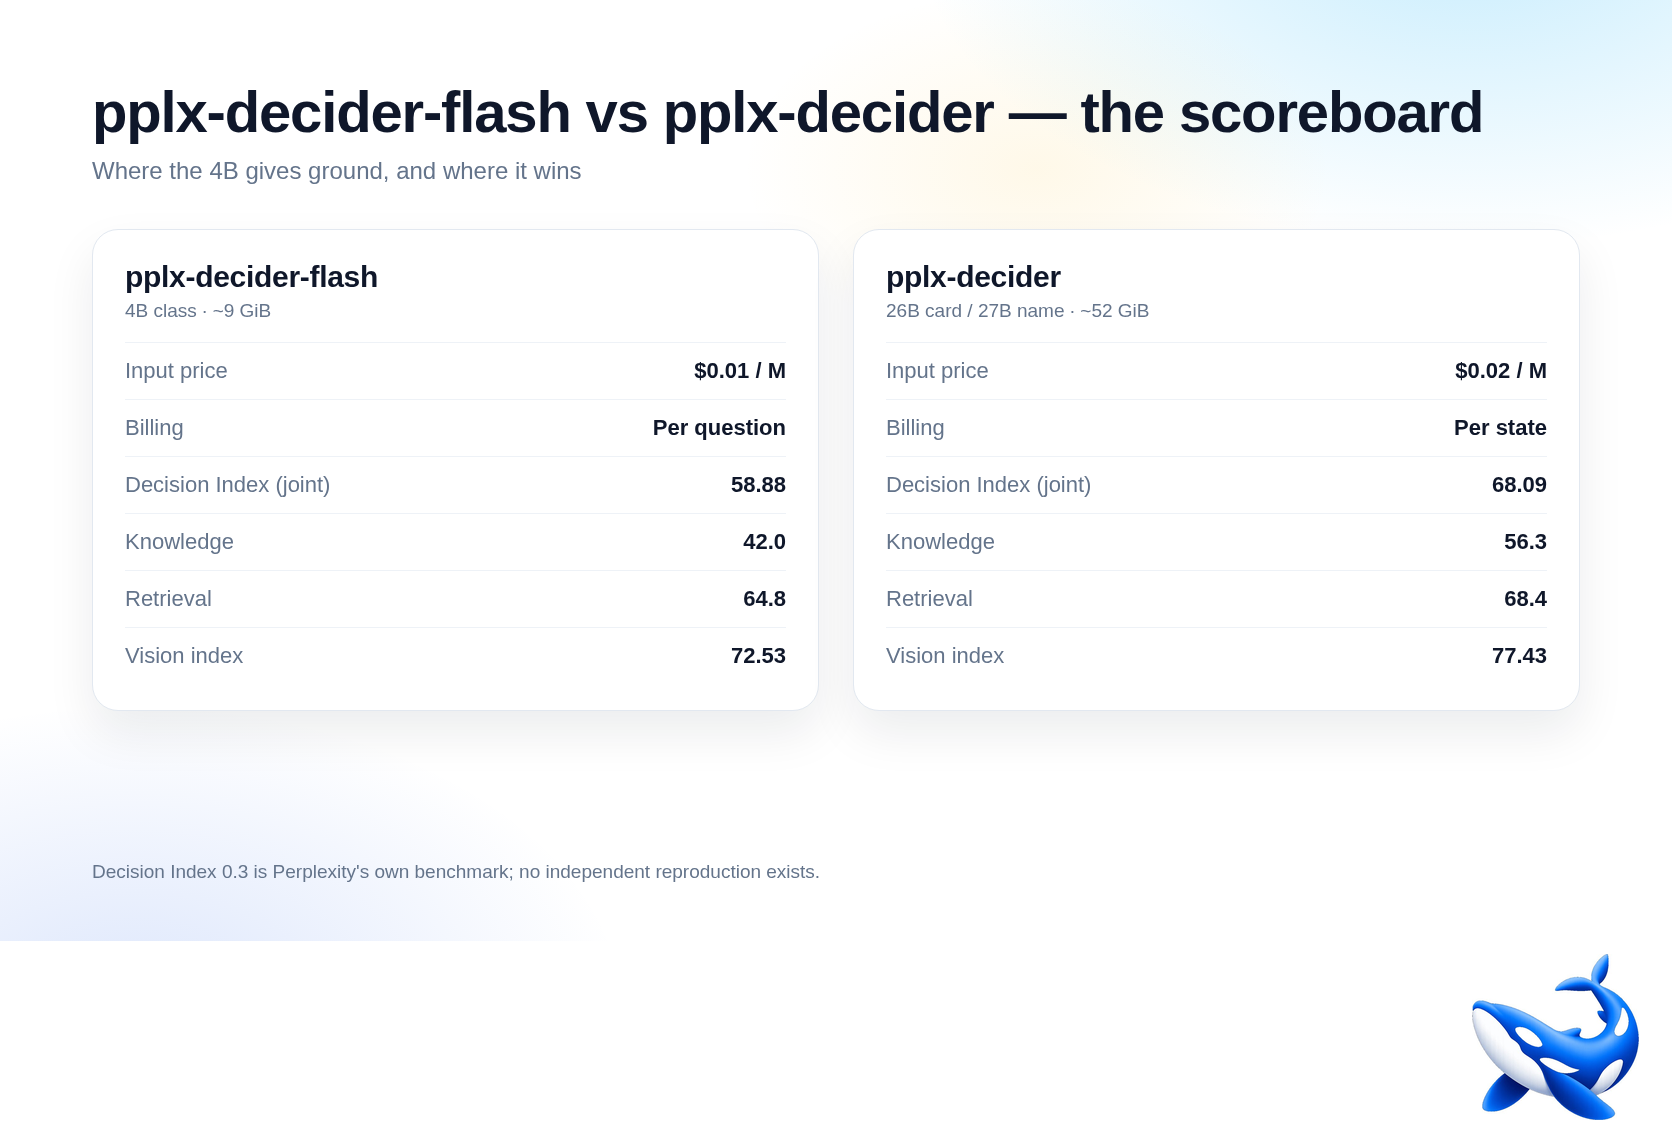
pplx-decider-flash-v1.2 berukuran sekitar 9 GiB dan bertumpu pada model 4B, sedangkan pplx-decider-v1.2 berukuran sekitar 52 GiB dan bertumpu pada model 27B. Flash lebih kecil serta lebih ringan untuk memori dan latensi, sehingga cocok bagi deployment mandiri yang terbatas. Model 27B lebih akurat pada indeks keputusan gabungan: 68,09 dibandingkan 58,88 untuk Flash. Pada evaluasi Flash dengan satu pertanyaan per permintaan, hasilnya 60,05. Angka itu pun berasal dari evaluasi milik vendor yang belum direproduksi pihak ketiga, jadi gunakan sebagai petunjuk, bukan jaminan kinerja.
Flash lebih murah per token masukan, tetapi aturan penagihan membuat jumlah pertanyaan menentukan biaya relatif. Untuk satu pertanyaan pada satu state, Flash memiliki keunggulan. Pada dua pertanyaan, biaya kedua model sama; mulai tiga pertanyaan pada state yang sama, Flash dapat menjadi lebih mahal karena state ditagihkan kembali untuk setiap pertanyaan, sedangkan model 27B menagihnya sekali. Pertanyaan Flash juga dijawab secara independen, bukan sebagai satu rangkaian yang saling terkait. Maka Flash paling sesuai untuk permintaan satu pertanyaan berulang; pilih model 27B untuk beberapa pertanyaan per state dan akurasi gabungan yang lebih tinggi.
Sebelum memutuskan, periksa tiga hal: metrik yang dinilai, unit biaya yang ditagihkan, dan kondisi pengujian—termasuk versi benchmark, subset tugas, serta format permintaan. Jangan bandingkan SWE-bench Pro v2 dengan v2 Hard seolah-olah pengujiannya identik, atau menganggap biaya per token selalu mencerminkan biaya tiap permintaan. Skor benchmark membantu mempersempit pilihan, tetapi kecocokan dengan beban kerja dan tingkat kendali yang dibutuhkan seharusnya menentukan keputusan akhir.
Buy if / Skip if
- Buy the Mistral Large 4 if Anda memerlukan penalaran, pemrosesan dokumen panjang, atau coding agentik.
- Skip the Mistral Large 4 if tugas Anda hanya ekstraksi sederhana dan kemampuan tambahannya tidak diperlukan.
- Buy the Llama 4 Maverick if Anda memerlukan bobot terbuka untuk fine-tuning, deployment terisolasi, atau pemrosesan tugas ringan.
- Skip the Llama 4 Maverick if Anda membutuhkan bukti benchmark langsung yang sebanding dengan model lebih baru untuk pekerjaan sulit.
- Buy the Flint v1.0 if Anda mengutamakan bobot terbuka, penggunaan offline, atau kendali atas deployment.
- Skip the Flint v1.0 if keunggulan pada Terminal-Bench 2.1 lebih penting daripada akses ke bobot dan lingkungan yang dapat Anda kelola.
- Buy the SWE-2 Flash if Anda sudah menggunakan Devin dan hasil pada tugas coding menjadi prioritas.
- Skip the SWE-2 Flash if Anda memerlukan bobot yang dapat dijalankan di perangkat sendiri atau tidak ingin bergantung pada platform Devin.
- Buy the pplx-decider-flash if beban kerja Anda biasanya satu pertanyaan per state dan Anda menginginkan model yang lebih kecil.
- Skip the pplx-decider-flash if Anda sering mengajukan beberapa pertanyaan pada state yang sama; pilih pplx-decider untuk biaya gabungan dan akurasi yang lebih sesuai.