
Model suara yang melewati teks
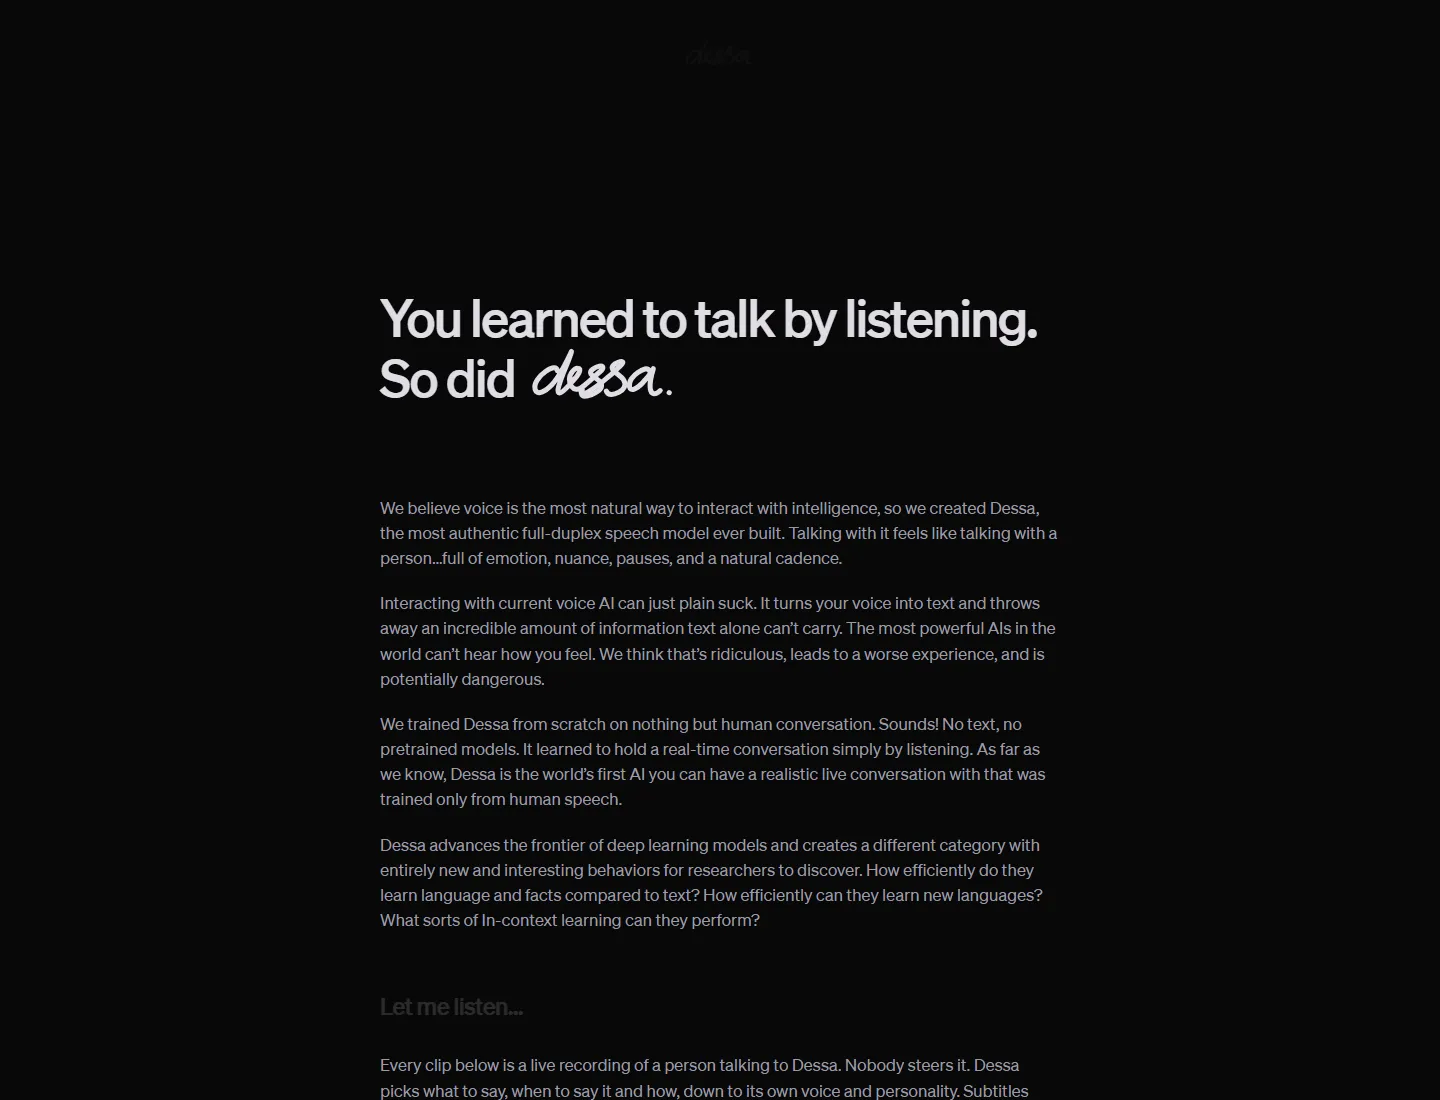
Dessa adalah model suara AI ucapan-ke-ucapan yang menerima percakapan sebagai audio dan membalas dalam audio, tanpa mengubah alur tersebut menjadi transkripsi teks atau memisahkannya ke tahap sintesis suara. Laboratorium riset AI internal Block mengumumkan pratinjau riset ini pada 23 Oktober 2026 sebagai AI dupleks penuh yang dilatih dari awal menggunakan percakapan manusia. Gagasan utamanya lebih penting daripada nama produknya: jika sistem tidak perlu menunggu transkrip selesai sebelum berpikir dan berbicara, interaksi dapat terasa lebih alami. Namun, klaim itu belum setara dengan bukti bahwa Dessa siap menggantikan asisten suara yang sudah digunakan orang. Block memublikasikan demo dan membuka daftar tunggu, bukan produk yang dapat diuji bebas. Jadi, Dessa Block layak diperhatikan sebagai arah baru dalam percakapan suara AI, tetapi untuk saat ini tetap merupakan janji riset.
Duplex berarti percakapan, bukan sekadar giliran
Sistem suara konvensional biasanya menunggu pengguna berhenti, mengenali ucapan, meminta model bahasa menyusun jawaban, lalu mengubah jawaban menjadi audio. Rangkaian itu memecah percakapan menjadi giliran yang kaku. Sebaliknya, Block mengatakan Dessa dapat mendengar dan berbicara pada saat yang sama, belajar dari percakapan kapan harus menyela dan kapan memberi tanda singkat bahwa ia menyimak. Dalam klip pilihan perusahaan, model tertawa di tengah kalimat, mengubah volume ketika diminta, membantu mengingat judul film, dan bereaksi terhadap pengungkapan soal hari jadi. Contoh-contoh itu menunjukkan sasaran desainnya: waktu tanggapan, tumpang tindih suara, dan isyarat emosional ikut menjadi bagian dari interaksi, bukan tambahan sesudah teks diproses. Akan tetapi, demo terpilih tidak membuktikan bahwa perilaku tersebut konsisten. Kelancaran giliran bicara juga bukan ukuran kecerdasan atau ketepatan jawaban.
Pelatihan hanya dengan suara, dengan klaim efisiensi besar
Block menyatakan Dessa dilatih dari nol menggunakan percakapan manusia, tanpa korpus teks dan tanpa model pralatih. Perusahaan juga mengatakan model mempelajari bahasa dengan jumlah kata ratusan kali lebih sedikit daripada model bahasa besar dan pelatihannya menggunakan satu sistem NVIDIA GB200 NVL72. Klaim ini menonjol karena audio jauh lebih beragam daripada teks tertulis: intonasi, jeda, tawa, dan tekanan kata dapat mengubah makna. Block menyebut rasa ingin tahu, pemahaman yang lebih baik antara manusia dan AI, serta keselamatan sebagai alasan pengembangan; perusahaan menilai AI yang kian mandiri masih kesulitan mengenali emosi dalam suara. Alasan itu masuk akal, tetapi ukuran efisiensi dan manfaat keselamatannya belum dapat dinilai dari pengumuman saja. Tidak ada rincian ukuran data, tolok ukur, atau pengujian independen yang dapat menunjukkan seberapa baik model memahami ucapan di luar klip demo.
Yang diketahui, yang masih belum dibuka
Block mengatakan inferensi berlangsung lebih cepat daripada waktu nyata pada MacBook Pro M4 Max atau perangkat yang lebih tinggi. Namun, perusahaan belum menyertakan angka latensi, kebutuhan memori terukur, atau hasil uji yang memungkinkan klaim tersebut dibandingkan secara langsung. Informasi penting lain juga belum tersedia: tidak ada API, harga, bobot model, tolok ukur, jumlah parameter, dokumentasi teknis, maupun rincian durasi pelatihan dan ukuran dataset. Akses awal diberikan kepada sekelompok kecil peneliti keselamatan AI, sementara daftar tunggu publik telah dibuka dan Block mengatakan tautan peluncuran akan segera hadir. Karena itu, pengguna biasa belum dapat mengandalkan Dessa untuk kebutuhan sehari-hari. Sampai akses dan spesifikasi diterbitkan, tim yang perlu membangun layanan suara dalam waktu dekat masih harus mengandalkan rangkaian pengenalan ucapan, model bahasa, dan sintesis suara yang sudah tersedia.
Kesimpulannya, Dessa menawarkan pendekatan yang patut diuji: percakapan langsung tanpa perantara transkripsi dapat membuat AI lebih tanggap terhadap jeda, interupsi, dan emosi. Namun, demo belum menjawab pertanyaan tentang konsistensi, ketepatan, keselamatan, atau kemudahan penerapan. Langkah berikutnya yang paling berarti bukan klaim yang lebih besar, melainkan akses yang dapat diuji, dokumentasi, dan tolok ukur yang terbuka. Sampai itu tersedia, Dessa adalah sinyal menarik tentang masa depan suara AI—belum bukti bahwa masa depan itu sudah siap dipakai.