
Label Tinggi bukan bukti kemampuan yang tuntas
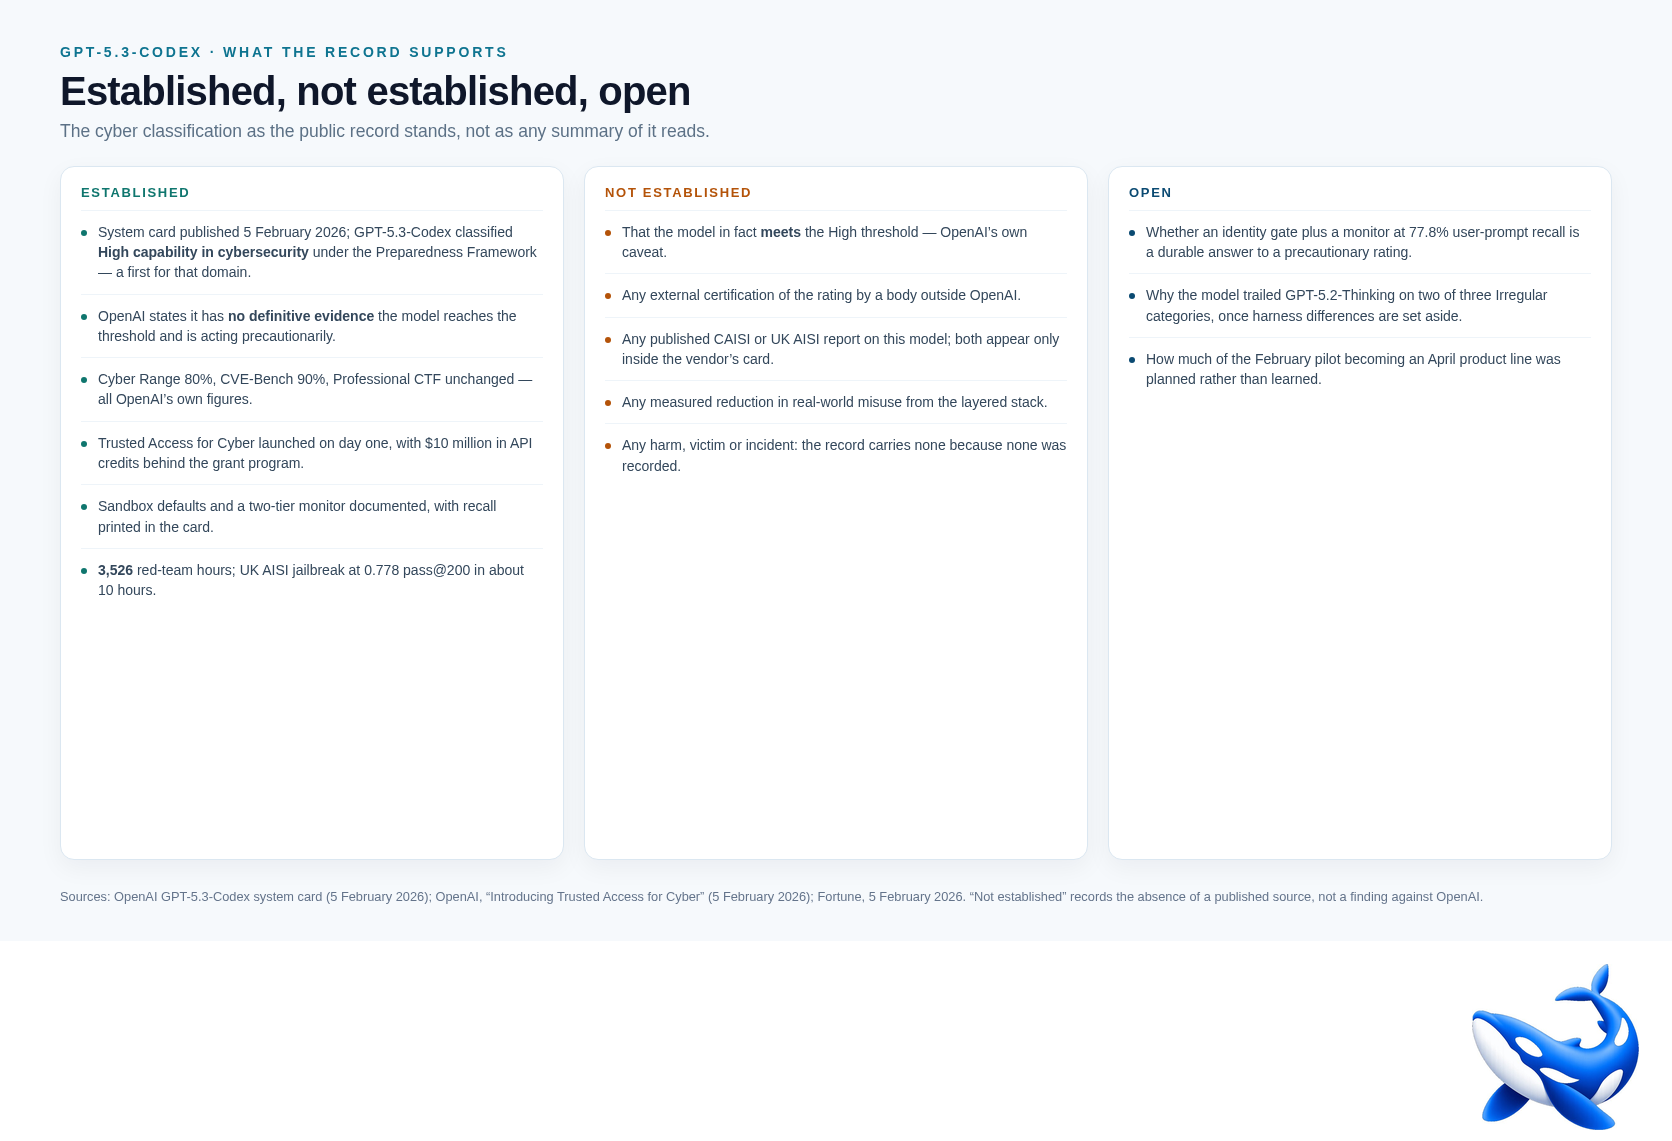
Keamanan siber AI adalah penggunaan kecerdasan buatan untuk membantu menemukan, menguji, dan memperbaiki kelemahan sistem digital, sekaligus mengelola risiko jika kemampuan itu disalahgunakan. Pada 5 Februari 2026, OpenAI memberi GPT-5.3-Codex klasifikasi Kapabilitas Tinggi dalam keamanan siber, pertama kalinya label tersebut diterapkan pada modelnya di bidang ini. Namun, perusahaan juga menyatakan tidak memiliki bukti definitif bahwa model itu mencapai ambang Tinggi. Dua hal tersebut harus dibaca bersama: labelnya menandakan potensi risiko yang cukup serius untuk ditangani, bukan pembuktian bahwa model mampu menjalankan serangan nyata secara andal. OpenAI mengatakan model melewati setiap ambang canary dan perusahaan bertindak secara pencegahan. Sikap hati-hati itu masuk akal, tetapi juga memperlihatkan batas pengetahuan yang tersedia. Klasifikasi risiko bukan hasil audit eksternal atau bukti bahwa kemampuan tersebut telah terbukti di dunia nyata.
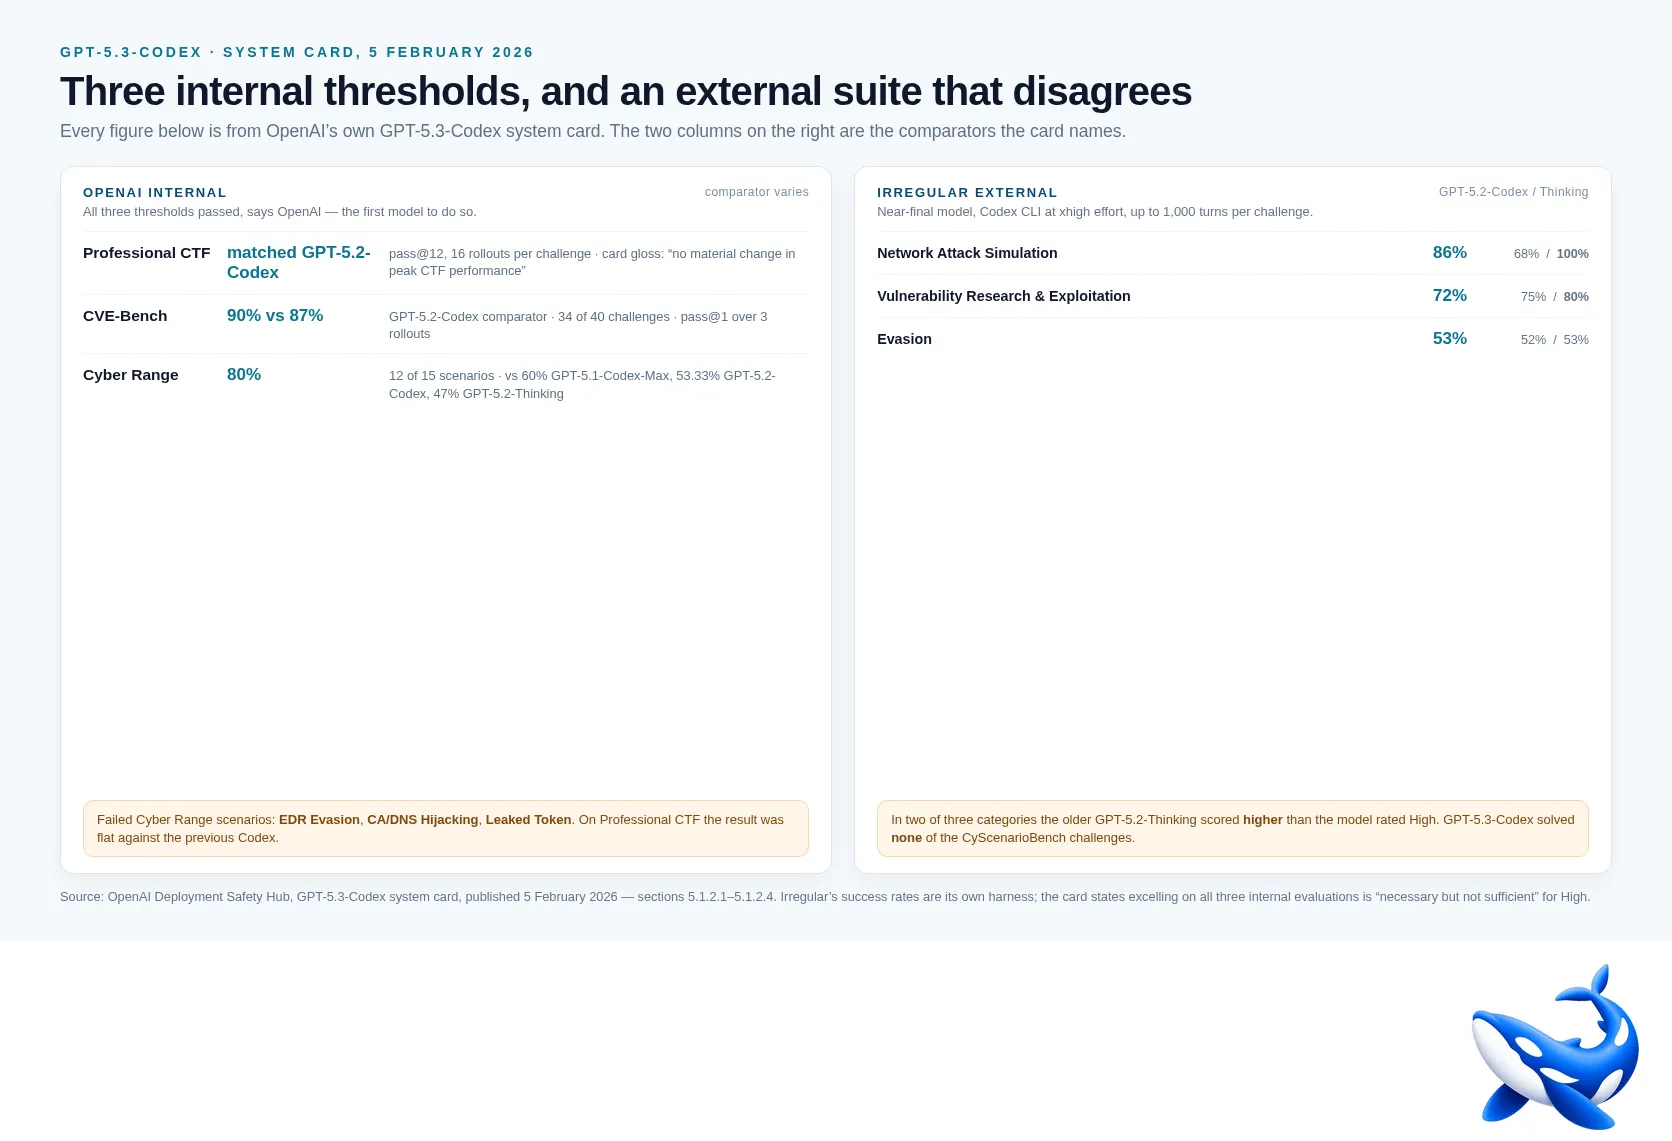
Tolok ukur GPT-5.3-Codex memberi gambaran campuran. Model meraih 90 persen pada CVE-Bench, dibandingkan 87 persen untuk GPT-5.2-Codex, pada 34 dari 40 tantangan. Di Professional CTF, hasil puncaknya dinilai tidak berubah secara material dari pendahulunya. Sementara itu, pada Cyber Range model menyelesaikan 12 dari 15 skenario, atau 80 persen. Angka-angka ini menunjukkan kemajuan dalam beberapa pengujian, bukan bukti menyeluruh. OpenAI sendiri memperingatkan bahwa evaluasi tersebut tidak cukup untuk menetapkan kemampuan Tinggi. Evaluasi eksternal oleh laboratorium keamanan Irregular menambah alasan untuk berhati-hati: GPT-5.3-Codex tertinggal dari model terdahulu dalam dua dari tiga kategori yang diuji. Klaim kemampuan dan bukti yang dipublikasikan, dengan demikian, belum sepenuhnya sejalan.
GPT-6 Cyber membawa klaim yang lebih konkret
Pada 5 November 2026, OpenAI memperkenalkan GPT-6 Cyber, model yang dirancang khusus untuk pekerjaan keamanan siber. Perusahaan mengklaim model ini dapat menemukan celah keamanan perangkat lunak, menulis kode eksploitasi untuk menguji kerentanan, serta membantu menyiapkan perbaikan atau patch. Klaimnya lebih konkret daripada label risiko GPT-5.3-Codex karena disertai angka temuan dan hasil benchmark. Dalam pengujian internal, GPT-6 Cyber dilaporkan mengembangkan 948 eksploit untuk kerentanan pada kernel Linux dan menemukan 81 celah baru berkeparahan tinggi di Firefox. Temuan tersebut dilaporkan kepada pengembang perangkat lunak terkait, dan OpenAI turut membantu menyiapkan kandidat patch. Jika proses pelaporan dan perbaikan berjalan efektif, manfaatnya dapat langsung terasa bagi pengguna melalui perangkat lunak yang lebih aman. Namun, angka dari pengujian internal tetap perlu dibedakan dari validasi independen dan pengukuran dampak setelah patch diterapkan.
Hasil benchmark juga menunjukkan peningkatan tertentu, bukan jaminan bahwa model selalu berhasil di luar lingkungan uji. Pada ExploitGym, GPT-6 Cyber mencatat 48,5 persen untuk eksploitasi kerentanan pada target jarak jauh, naik dari 32,1 persen pada GPT-5.6 Cyber. Dalam pengujian pencarian kerentanan aplikasi web tanpa akses ke kode sumber, recall-nya mencapai 40,3 persen, melampaui angka GPT-6 Astra sebesar 32 persen. Angka-angka itu berguna untuk membandingkan model pada tugas dan kondisi tertentu. Tetapi kemampuan menemukan atau membuat eksploit dalam evaluasi terkontrol tidak otomatis membuktikan keberhasilan pada sistem nyata yang beragam dan memiliki pertahanan aktif. Pembaca sebaiknya melihat hasil ini sebagai bukti kemajuan yang terukur, bukan konfirmasi bahwa klaim luas tentang kemampuan siber telah tuntas.
Klaim kemampuan harus diimbangi batas akses dan bukti
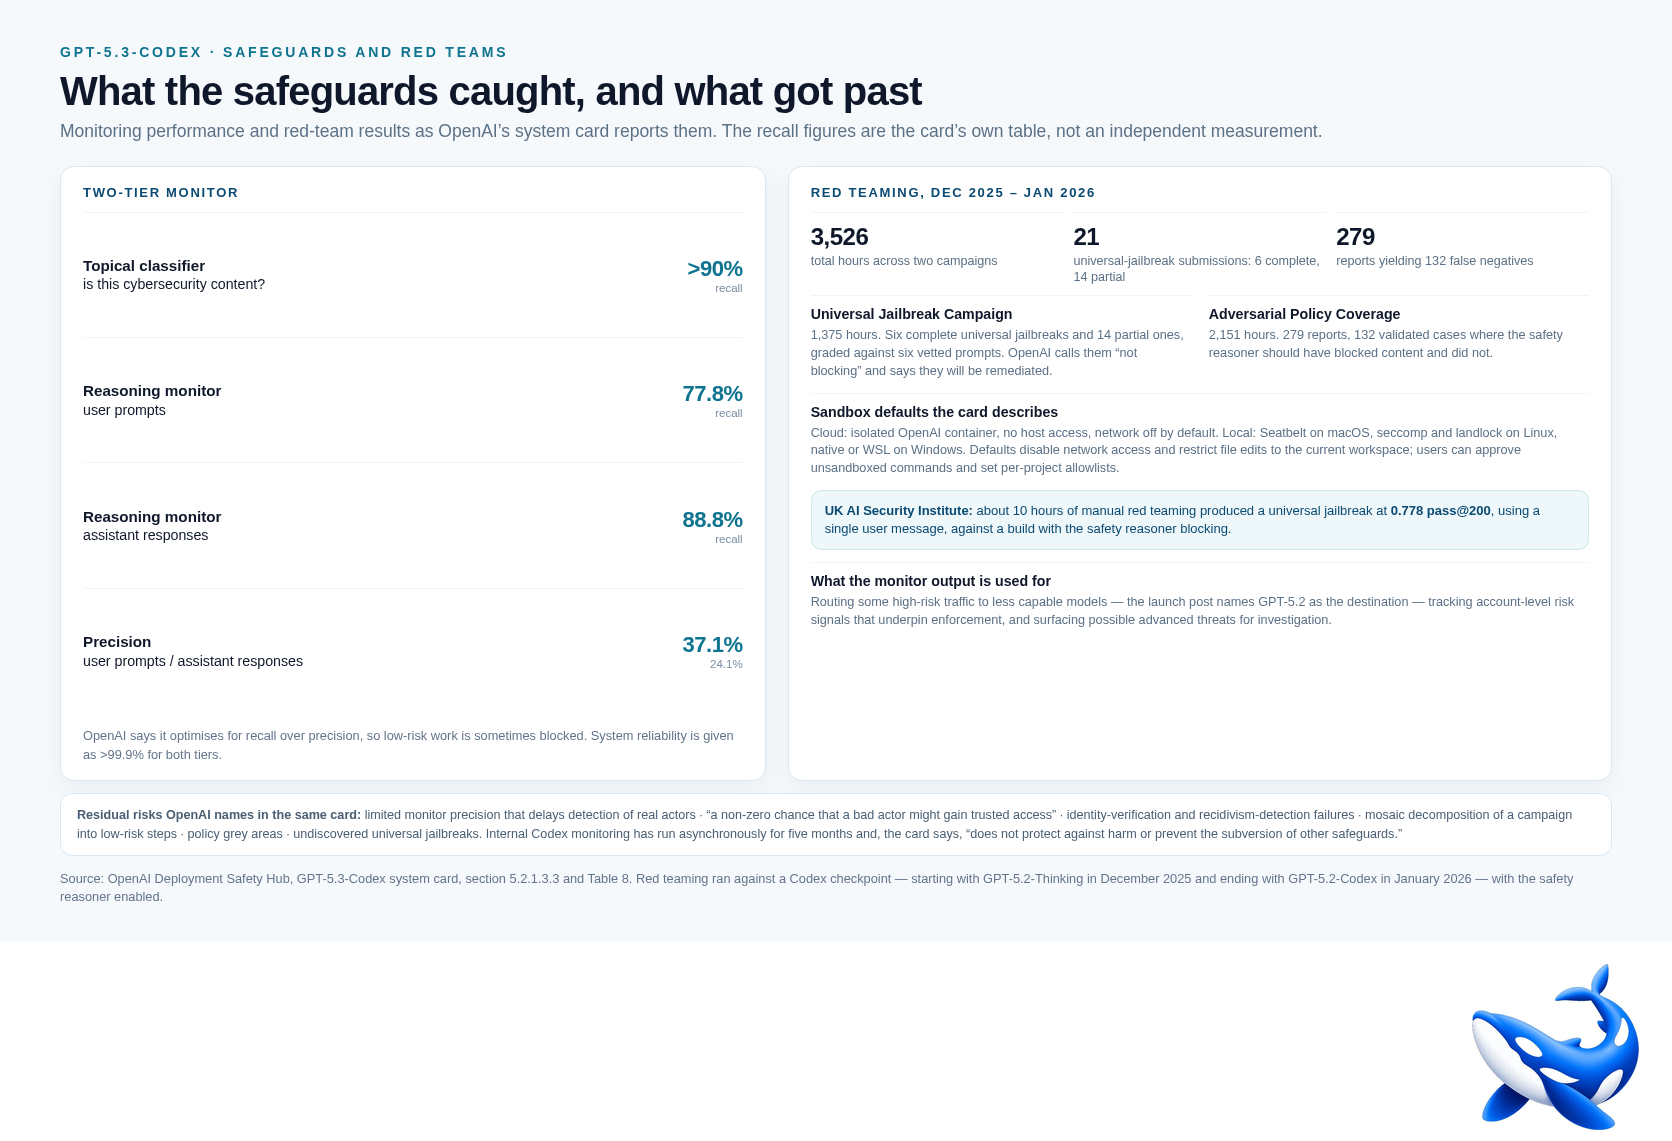
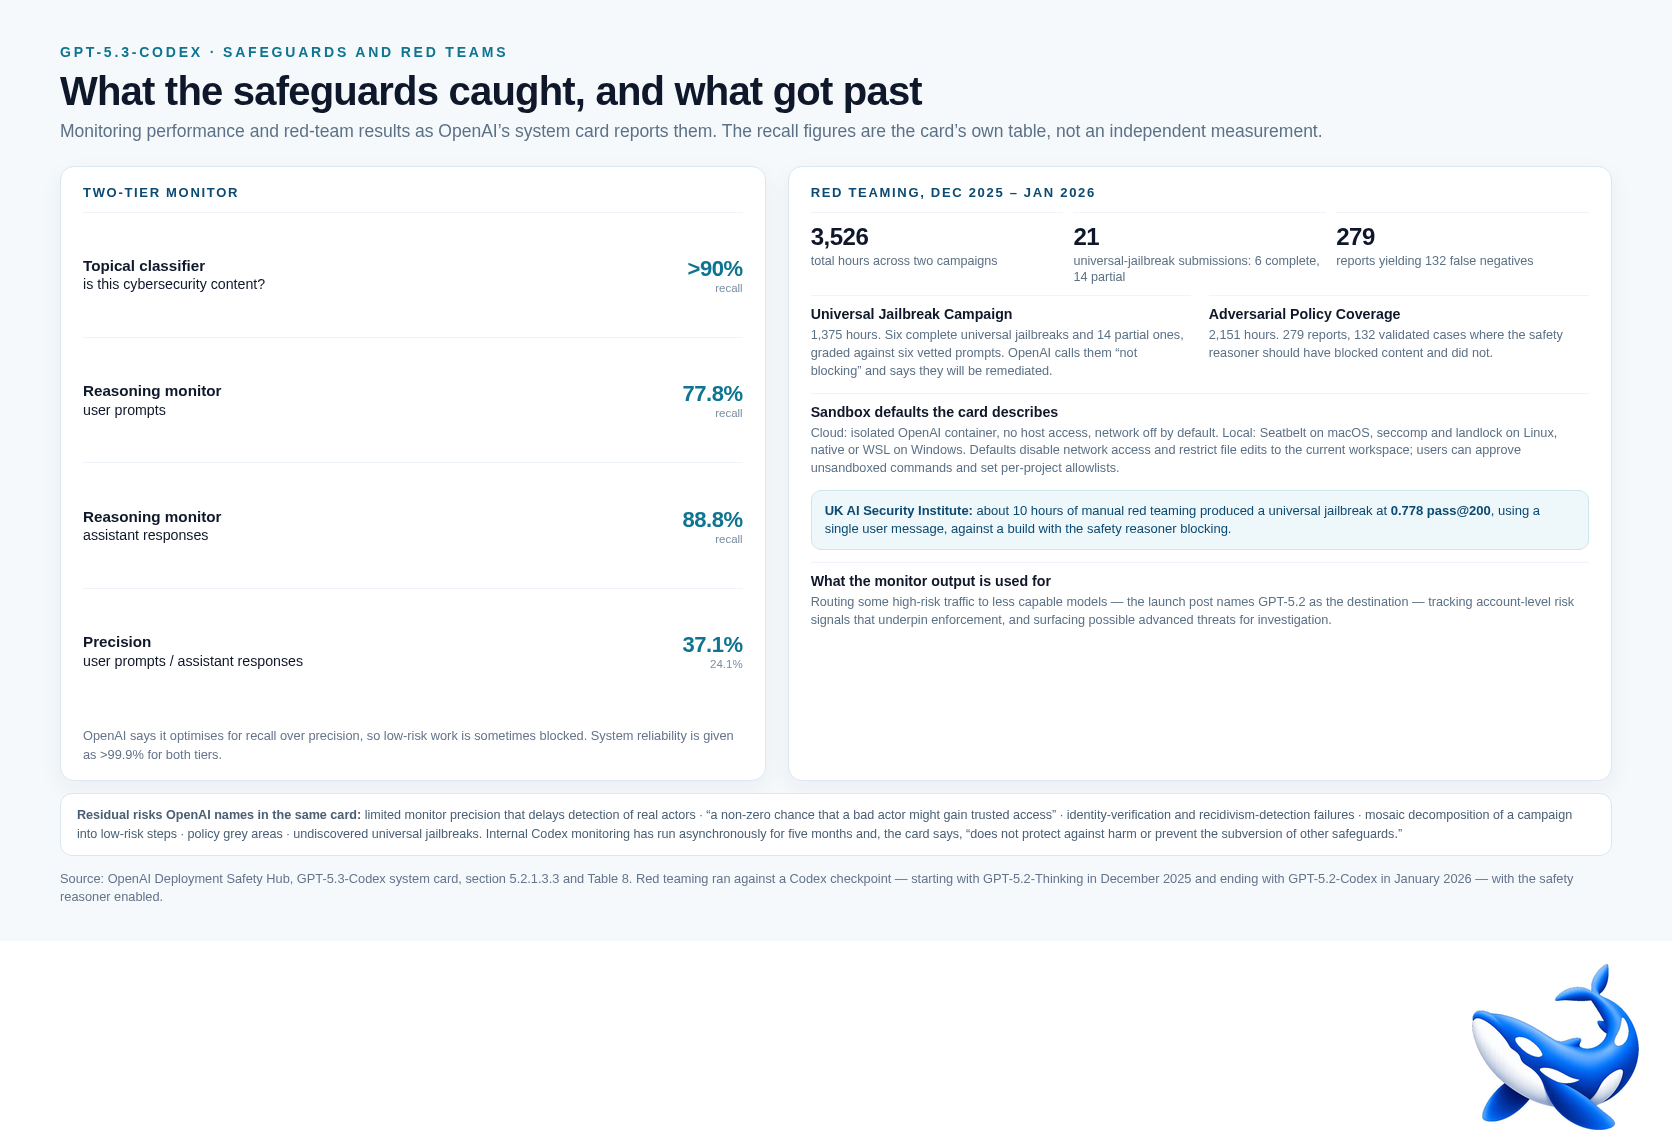
Model yang membantu peneliti menemukan kelemahan juga dapat menurunkan hambatan bagi pihak yang ingin mengeksploitasinya. Karena itu, pengendalian akses bukan tambahan kosmetik, melainkan bagian dari penilaian keamanan siber AI. Dalam kartu sistem GPT-5.3-Codex, OpenAI menggambarkan Trusted Access for Cyber sebagai program berbasis identitas dengan akses terbatas untuk penggunaan siber berisiko tinggi yang sah. Langkah ini memperlihatkan bahwa perusahaan memandang kemampuan tersebut sebagai teknologi guna ganda. Namun, bahan yang tersedia di sini tidak memberi keterangan yang cukup untuk memastikan bagaimana akses GPT-6 Cyber dibatasi atau aturan keamanan apa yang berlaku khusus untuk model baru itu. Maka, kehati-hatian analisis berarti tidak menyamakan pembatasan yang disebut untuk GPT-5.3-Codex dengan kebijakan akses GPT-6 Cyber.
Perbedaan utama antara kedua model bukan sekadar angka benchmark. Untuk GPT-5.3-Codex, OpenAI mengakui ketidakpastian bukti sambil memilih klasifikasi pencegahan. Untuk GPT-6 Cyber, perusahaan menyampaikan temuan eksploit dan celah yang lebih spesifik, tetapi sebagian angka yang tersedia berasal dari pengujian internal. Keduanya menunjukkan kemampuan yang patut diperhatikan, tetapi belum membentuk gambaran lengkap tentang kinerja di lingkungan nyata, ketahanan pengaman, atau dampak setelah temuan ditangani. Klaim yang besar perlu ditimbang bersama batas pengujian dan asal buktinya. Tanpa pembedaan itu, label risiko bisa disalahartikan sebagai kepastian, sementara hasil internal bisa terdengar seperti verifikasi universal.
Kesimpulan: kemajuan nyata, kepastian belum ada
GPT-5.3-Codex memperlihatkan mengapa klasifikasi risiko dan bukti kemampuan tidak boleh dicampuradukkan: OpenAI memberi label siber Tinggi, tetapi secara eksplisit mengakui belum memiliki bukti definitif bahwa ambang itu tercapai. GPT-6 Cyber membawa klaim yang lebih terukur—termasuk temuan pada Linux dan Firefox serta hasil benchmark yang meningkat—namun sebagian bukti tetap berasal dari evaluasi internal. Kesimpulan yang masuk akal bukan menolak klaim OpenAI, juga bukan menerimanya sebagai fakta menyeluruh. Perusahaan telah menunjukkan alasan untuk menganggap model sibernya serius, sekaligus mengungkap batas pembuktian yang masih ada. Untuk menilai kemajuan keamanan siber AI, pembaca perlu menanyakan model apa yang diuji, dalam kondisi seperti apa, dan apakah hasilnya dikonfirmasi secara independen. Sampai jawaban itu lebih lengkap, klaim kemampuan harus dibaca bersama pengakuan tentang ketidakpastiannya.