
Benchmark mengukur model sekaligus cara pengujiannya
Benchmark model AI adalah serangkaian tugas terukur untuk membandingkan kemampuan sistem, tetapi hasilnya hanya bermakna jika model, konfigurasi, dan metode penilaian diuji dengan aturan yang sebanding. Karena itu, skor tinggi bukan vonis final tentang model terbaik; ia adalah bukti yang perlu dibaca bersama cara skor tersebut dihasilkan. Tiga klaim yang beredar pada Oktober memperlihatkan masalah itu dengan jelas. ZwZ2-27B disebut mengungguli Qwen3.6-27B sebesar 4,99 poin berdasarkan 25 benchmark. Nanbeige4.3-33B dilaporkan mengalahkan Qwen3.8-27B pada 18 dari 20 baris. Sementara itu, tabel Liquid AI menyatakan LFM3-1.7B menang 23 kali atas MiniCPM5-2B, yang menang empat kali. Angka-angka ini patut diperhatikan, tetapi belum setara dengan perbandingan independen. Bagi pengguna, pertanyaan penting bukan hanya siapa menang, melainkan apakah kedua model menjalani ujian yang sama.
ZwZ2-27B: kenaikan skor yang masih menunggu pembuktian
Bobot ZwZ2-27B tersedia sejak 16 Oktober 2026, sedangkan kartu modelnya baru muncul pada 26 Oktober; saat itulah tujuan dan evaluasi yang diklaim akhirnya dijelaskan. Kartu tersebut menggambarkan model visi-bahasa berbasis Qwen3.6-27B yang menjalani pelatihan penguatan. Pada 25 benchmark dalam enam domain, rata-rata keseluruhan diklaim naik dari 55,52 menjadi 60,51—selisih 4,99 poin—dan model disebut meningkat pada setiap tolok ukur. Namun, klaim itu berasal dari evaluasi vendor dan belum direproduksi di luar organisasi. Kesamaan bobot dasar juga tidak membuat hasil otomatis independen: ZwZ2-27B digambarkan sebagai bodi yang sama dengan rezim pascapelatihan berbeda dan satu kepala dekode spekulatif yang dilepas. Jadi, kenaikan skor bisa menjadi petunjuk berguna tentang apa yang dioptimalkan tim, bukan bukti bahwa model akan unggul pada semua penggunaan. Pengguna juga perlu mempertimbangkan kebutuhan praktis: menjalankannya berarti mengunduh bobot berukuran 54 GB, menyiapkan versi Transformers tertentu, dan mengelola penyajian model sendiri.
Nanbeige memimpin tabelnya, tetapi catatan kaki tetap penting
Repositori Nanbeige4.3-33B dibuka pada 24 Oktober 2026, empat menit setelah checkpoint dasarnya, tanpa pengumuman peluncuran terpisah. Kartu model menyebutnya model guru unggulan untuk seri Nanbeige4.3, yang disiapkan agar perilaku agentik dapat didistilasi ke model lebih kecil, termasuk Nanbeige4.3-3B. Dalam tabel vendor, model 33B itu memimpin 17 dari 20 baris dan mengalahkan Qwen3.8-27B pada 18 baris. Dua hitungan tersebut tidak bertentangan: Qwen menang pada SWE-Bench Pro dan GDPval, sementara Gemma4-31B mendapat skor tertinggi pada GPQA Diamond. Lebih penting lagi, kartu itu menyertakan 12 catatan kaki di bawah 20 baris, dan catatan tersebut memengaruhi keterbandingan hasil. Tabelnya lebih terdokumentasi daripada banyak tabel vendor, tetapi repositori tidak menyediakan skrip, konfigurasi tugas, atau log evaluasi; skor independen juga belum tersedia pada 26 Oktober. Pengaturan yang disarankan—hingga 65.536 token baru untuk pekerjaan agentik dan 262.144 untuk penalaran serta obrolan, dengan pemikiran aktif secara bawaan—juga bukan detail remeh bagi siapa pun yang mencoba mengulang tes.
LFM3 melawan MiniCPM5: 23–4 bukan hasil netral
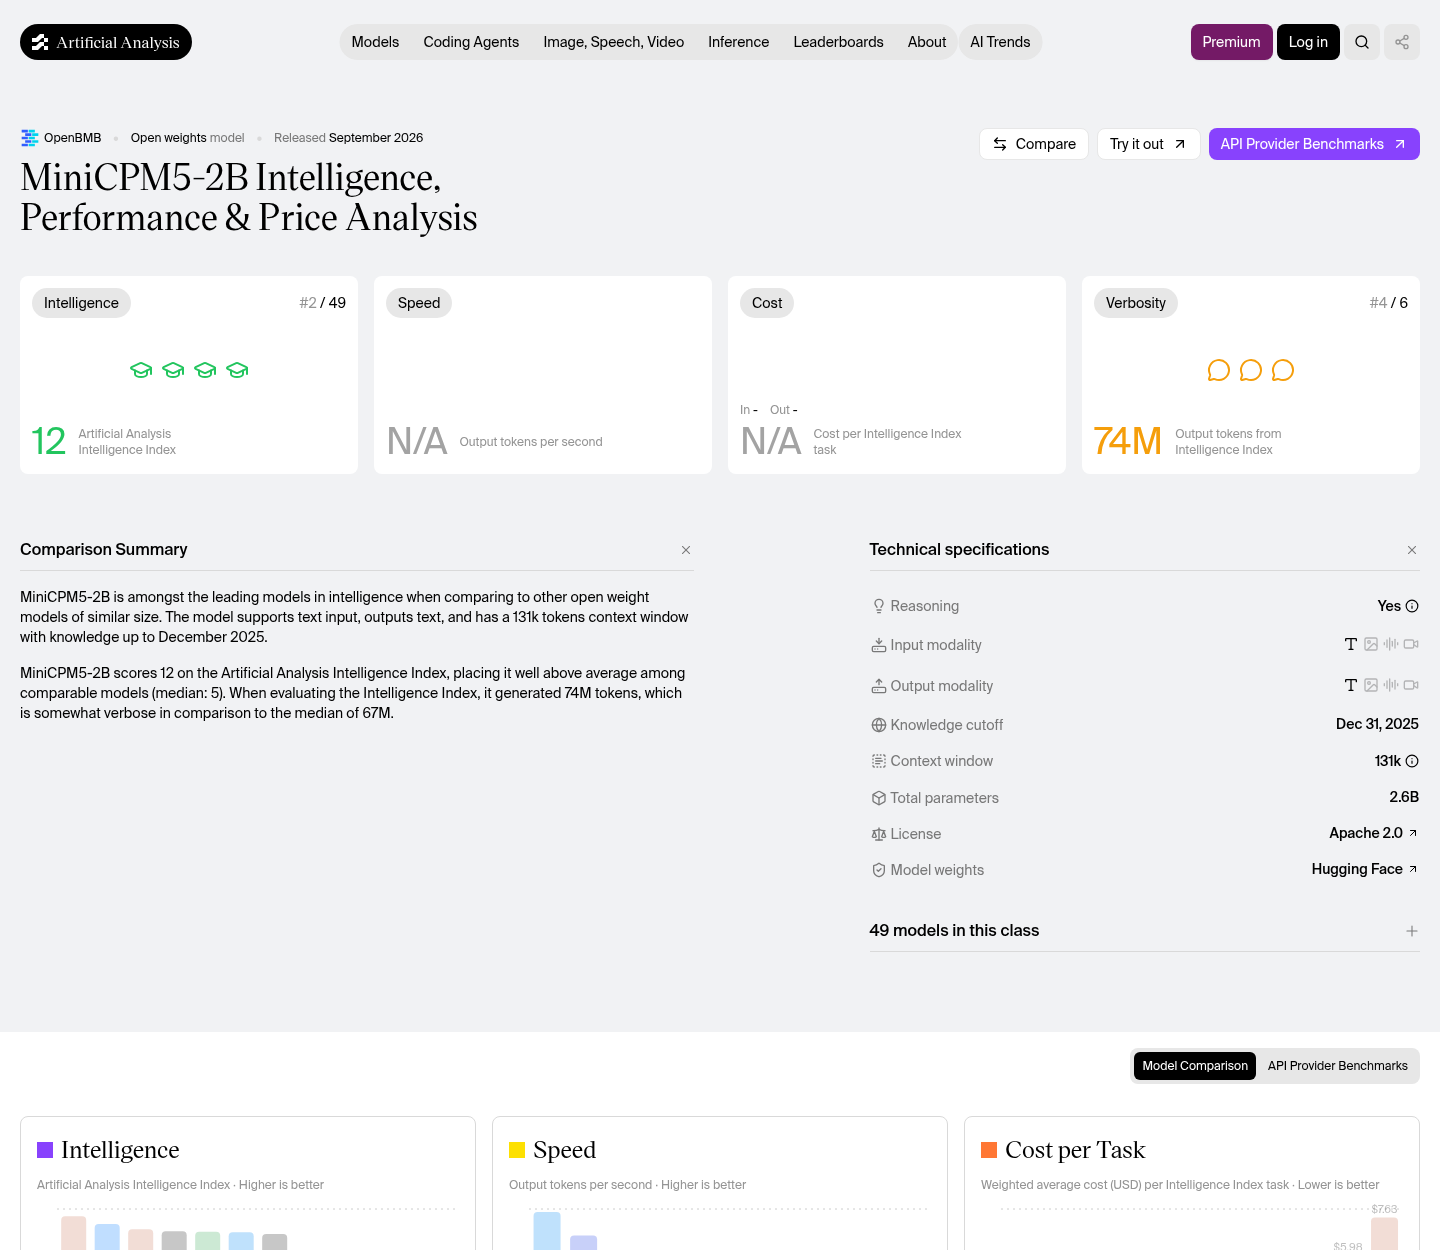
Pada 27 Oktober 2026, Liquid AI menerbitkan tabel 27 baris yang membandingkan LFM3-1.7B dengan MiniCPM5-2B: LFM3 menang 23 baris dan MiniCPM5 menang empat. Keduanya berada pada kelas ukuran yang berdekatan, tetapi dirancang untuk pekerjaan berbeda: MiniCPM5-2B adalah model penalaran padat berparameter 2,52 miliar, sedangkan LFM3-1.7B adalah model teks dan agen berparameter 1,73 miliar. Liquid menguji ulang pesaingnya dengan alat evaluasi sendiri. Itu lebih informatif daripada sekadar mengambil angka papan peringkat, tetapi tidak menjadikan perbandingan netral. Pada benchmark yang juga tercantum di kartu OpenBMB, skor MiniCPM5 berbeda: BFCL V4 tercatat 62,65 dalam pengujian Liquid dan 66,6 pada kartu OpenBMB; untuk Humanity’s Last Exam angkanya 8,20 dan 8,9. Selisih kecil itu cukup untuk mengingatkan bahwa konfigurasi dan sumber skor dapat mengubah pembacaan tabel. Kedua vendor tidak menerbitkan konfigurasi harness, kebijakan percobaan ulang, atau kerangka prompt. Tanpa satu penguji dan satu konfigurasi terbuka, hitungan kemenangan lebih cocok dibaca sebagai klaim peluncuran daripada putusan.
Bagi pengguna biasa, perbandingan model AI yang adil harus melampaui jumlah baris yang dimenangkan. Model yang lebih kecil bisa lebih sesuai untuk perangkat tertentu, sementara hasil pada tugas penalaran belum tentu mewakili kemampuan agen atau penggunaan alat. Jika sebuah model akan dipakai dalam produksi minggu ini, rekam jejak ketersediaan dan pengalaman pengguna lain juga punya nilai tersendiri.
Putusan yang layak: minta pengujian bersama
Ketiga contoh ini tidak membuktikan bahwa klaim vendor keliru. Masalahnya, skor benchmark AI sering dibaca sebagai ukuran universal, padahal sumber skor, konfigurasi, catatan kaki, dan pilihan tugas membatasi kesimpulan yang bisa ditarik. Evaluasi model bahasa akan lebih meyakinkan bila skrip, versi perangkat lunak, prompt, kebijakan percobaan ulang, dan log hasil tersedia untuk diperiksa. Klaim vendor berguna untuk menemukan model yang patut diuji; ia tidak seharusnya menggantikan pengujian itu. Langkah berikutnya untuk LFM3 dan MiniCPM5 sudah jelas: jalankan keduanya melalui satu harness, lalu terbitkan hasil bersama konfigurasi yang dikomitkan. Nanbeige4.3-3B juga belum dirilis; saat hadir, model lebih kecil itulah yang kemungkinan besar akan dijalankan banyak orang, sementara versi 33B berperan menjelaskan skor dan proses distilasinya. Kesimpulannya sederhana: anggap papan skor sebagai awal penyelidikan, bukan akhir perdebatan. Sampai pengujian lintas-vendor dapat diulang secara terbuka, klaim keunggulan tetap bersyarat.