
Akses lokal atau kemampuan layanan
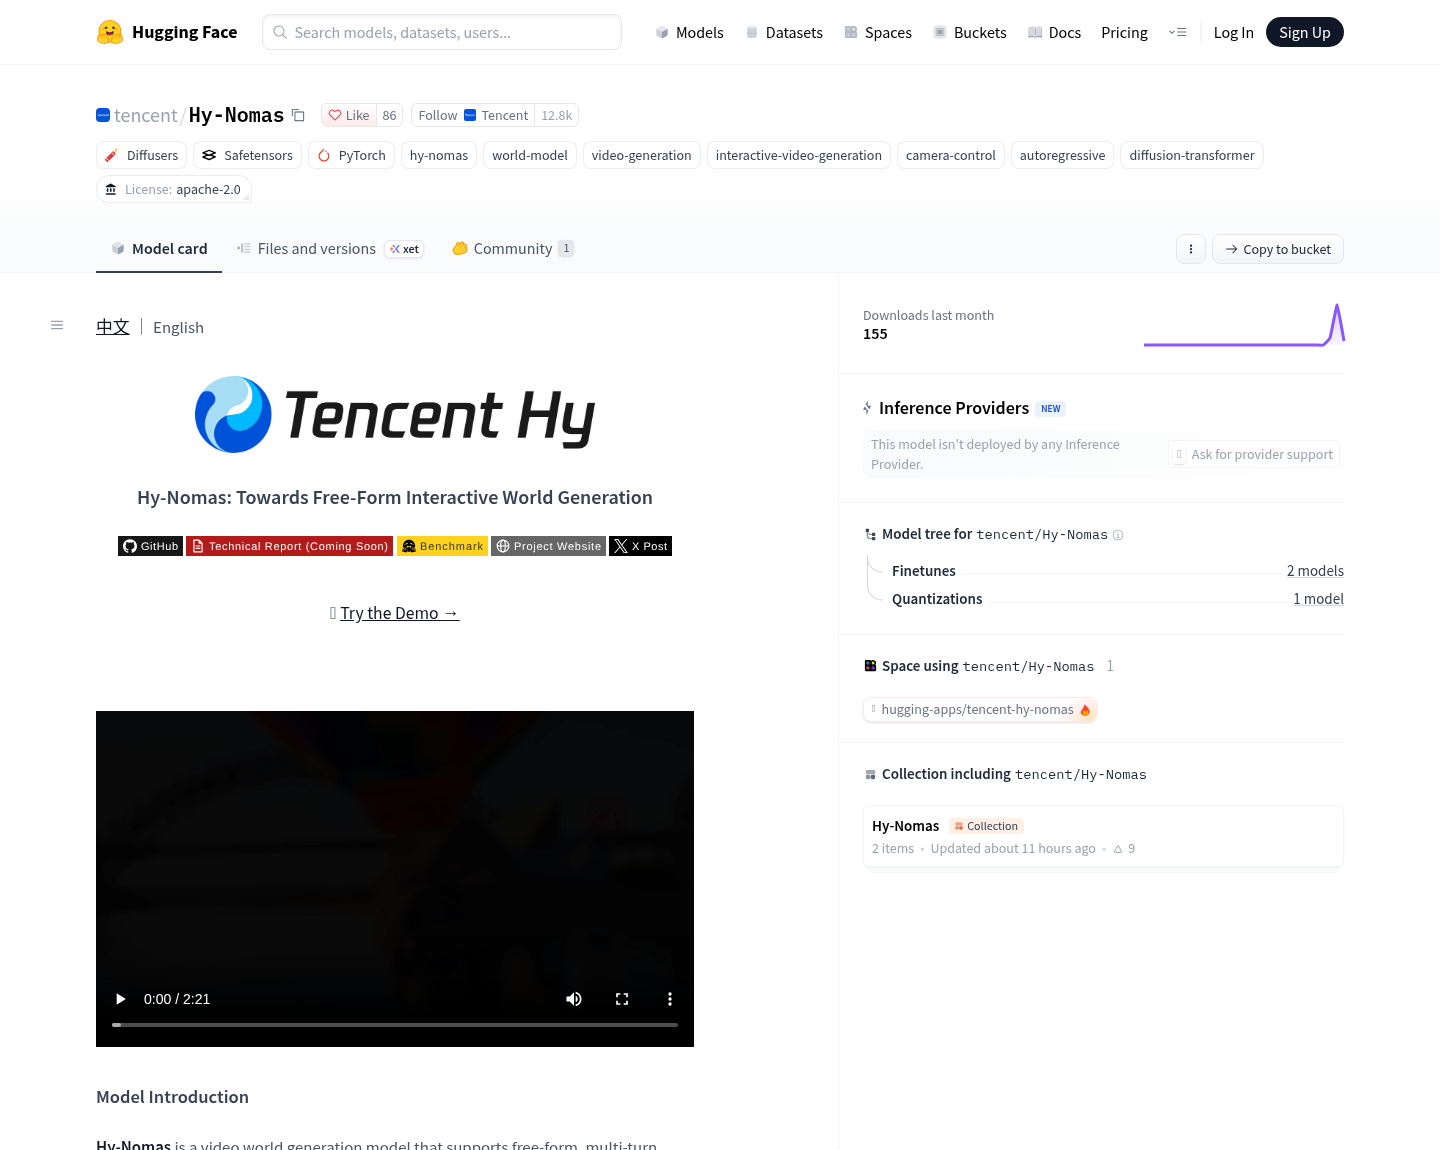
Model AI terbuka adalah model yang menyediakan bobot untuk diunduh dan dijalankan atau disesuaikan sendiri, sedangkan model AI tertutup umumnya diakses sebagai layanan dengan kemampuan dan kendali yang ditentukan penyedia. Pilihan terbaik bergantung pada apakah Anda lebih membutuhkan kendali lokal atau fitur yang sudah dikelola. HY-Nomas dan Genie 4 menggambarkan pertukaran itu dengan jelas. HY-Nomas menyediakan bobot berlisensi Apache 2.0 dan konfigurasi terdokumentasi yang dapat berjalan pada satu RTX 4090. Lisensi permisif ini mendukung penerapan komersial tanpa negosiasi, sementara bobot dan adaptor LoRA memberi ruang untuk penyesuaian pada rekaman atau domain sendiri. Genie 4 lebih menarik untuk eksplorasi visual: model dunia ini menghasilkan audio native—termasuk suara ambien, musik, dan dialog—serta mempertahankan adegan sekitar dua menit. Namun, aksesnya terbatas pada penguji tepercaya dan daftar tunggu, dengan prompt teks sebagai tuas kendali utama. Untuk tim yang mengutamakan eksperimen lokal, reproduksibilitas, dan penyesuaian, HY-Nomas pilihan yang lebih praktis. Jika kualitas dunia generatif dan audio terpadu lebih penting daripada akses langsung, Genie 4 lebih menjanjikan.
| Aspek | HY-Nomas | Genie 4 |
|---|---|---|
| Bentuk akses | Bobot dapat diunduh; bukan layanan | Akses terbatas melalui penguji tepercaya dan daftar tunggu |
| Lisensi atau ketentuan | Apache 2.0 | Ketentuan komersial belum dipublikasikan |
| Kemampuan unggulan | Fine-tuning LoRA dan adaptor untuk kamera sinematik serta rekaman robotika | Audio native dan adegan koheren sekitar dua menit |
| Kebutuhan perangkat | Konfigurasi terdokumentasi berjalan pada satu RTX 4090 | Berjalan sebagai layanan; akses lokal ke bobot tidak tersedia |
| Kompromi utama | Kontrol dan reproduksibilitas, dengan kualitas visual serta audio yang lebih terbatas | Kemampuan lebih kuat, tetapi akses dan kendali lebih terbatas |
Model audio: skor percakapan atau berkas yang bisa dimiliki
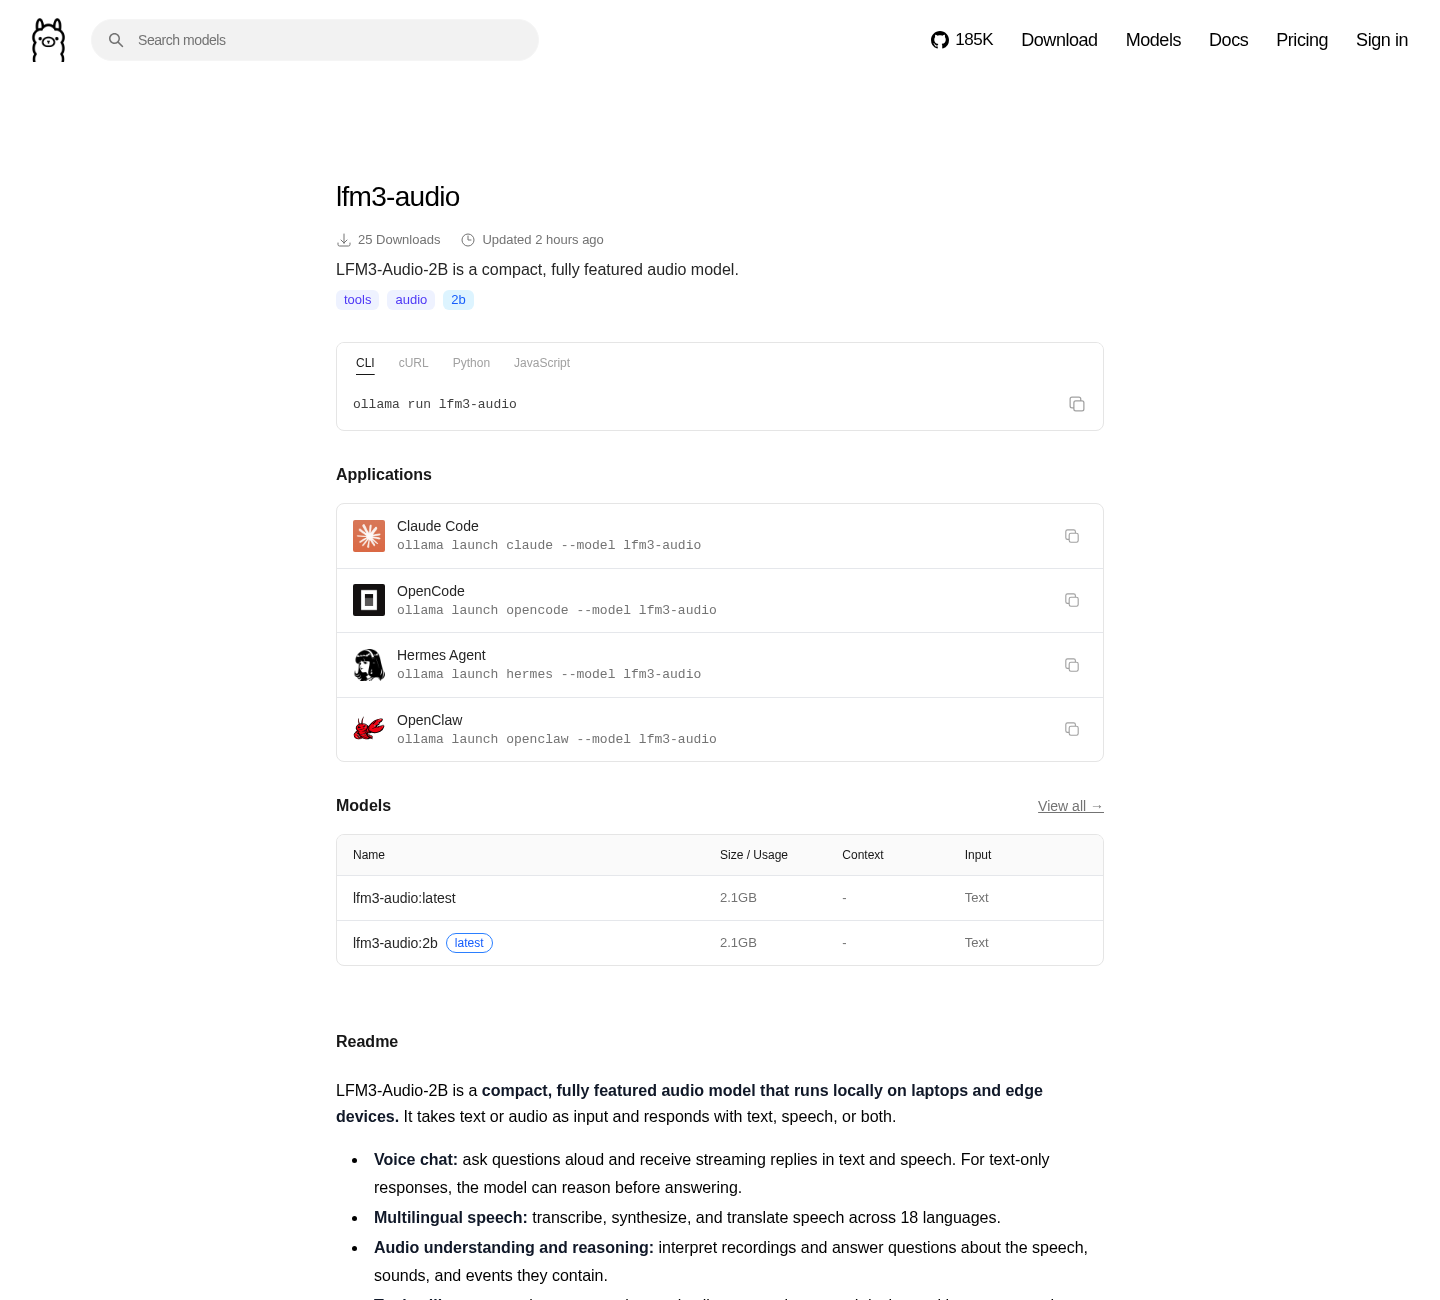
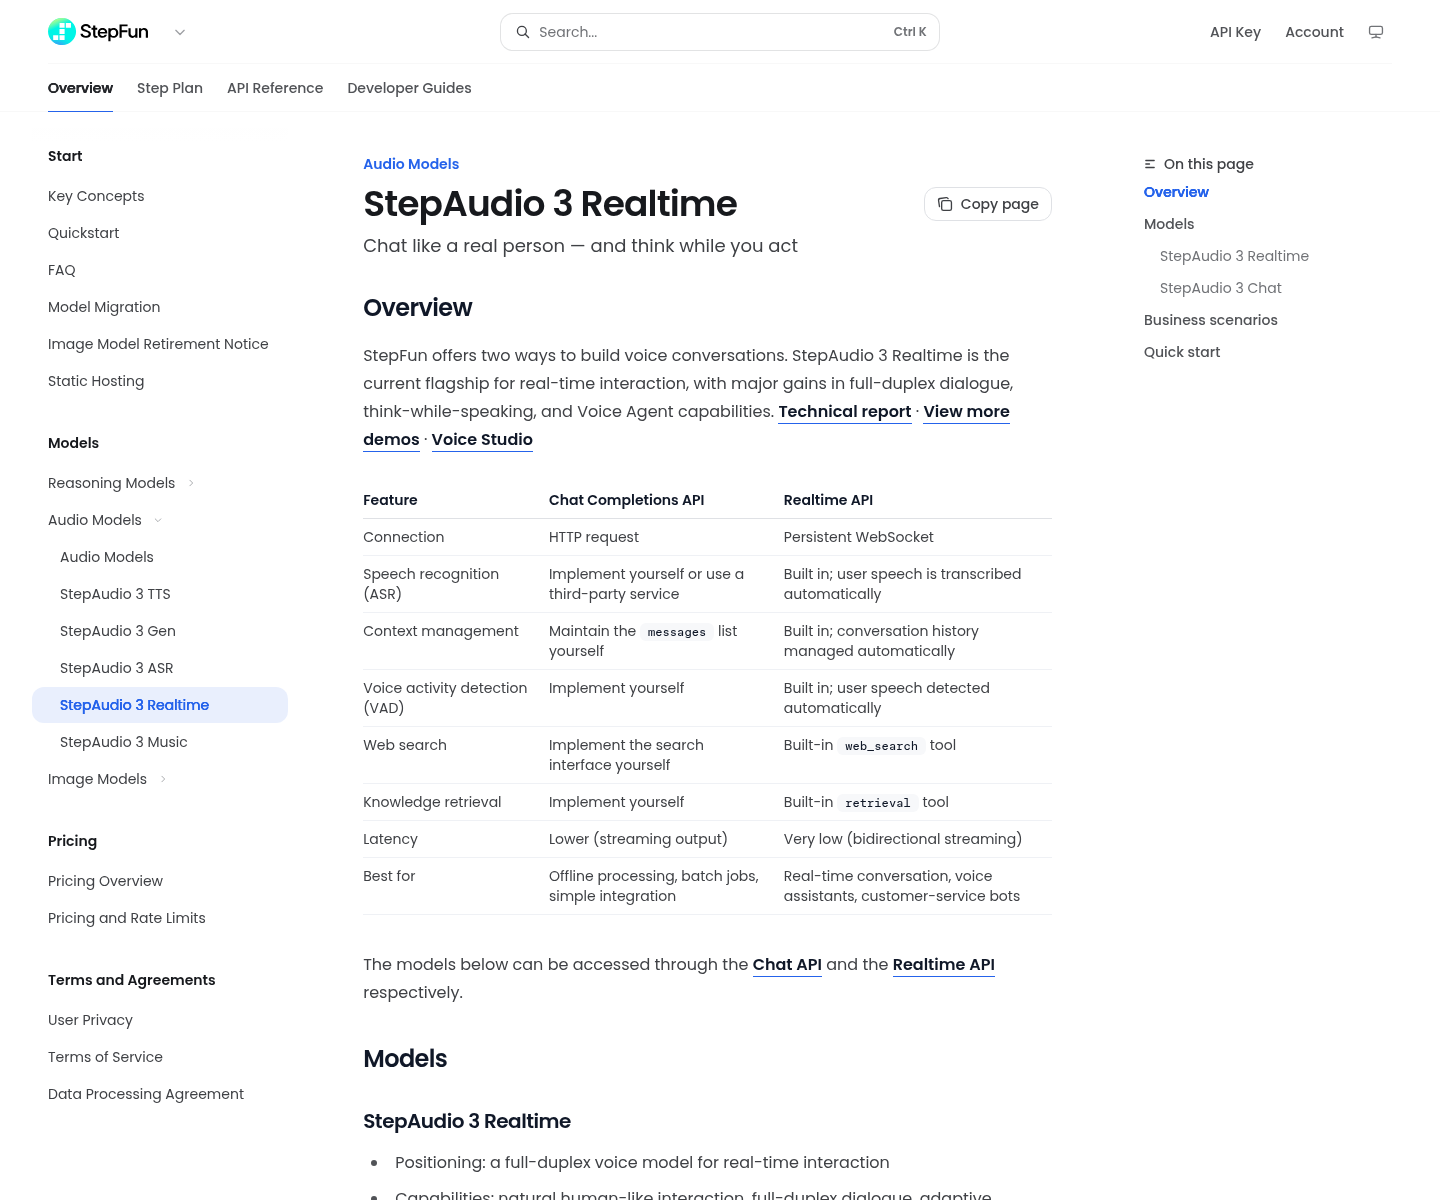
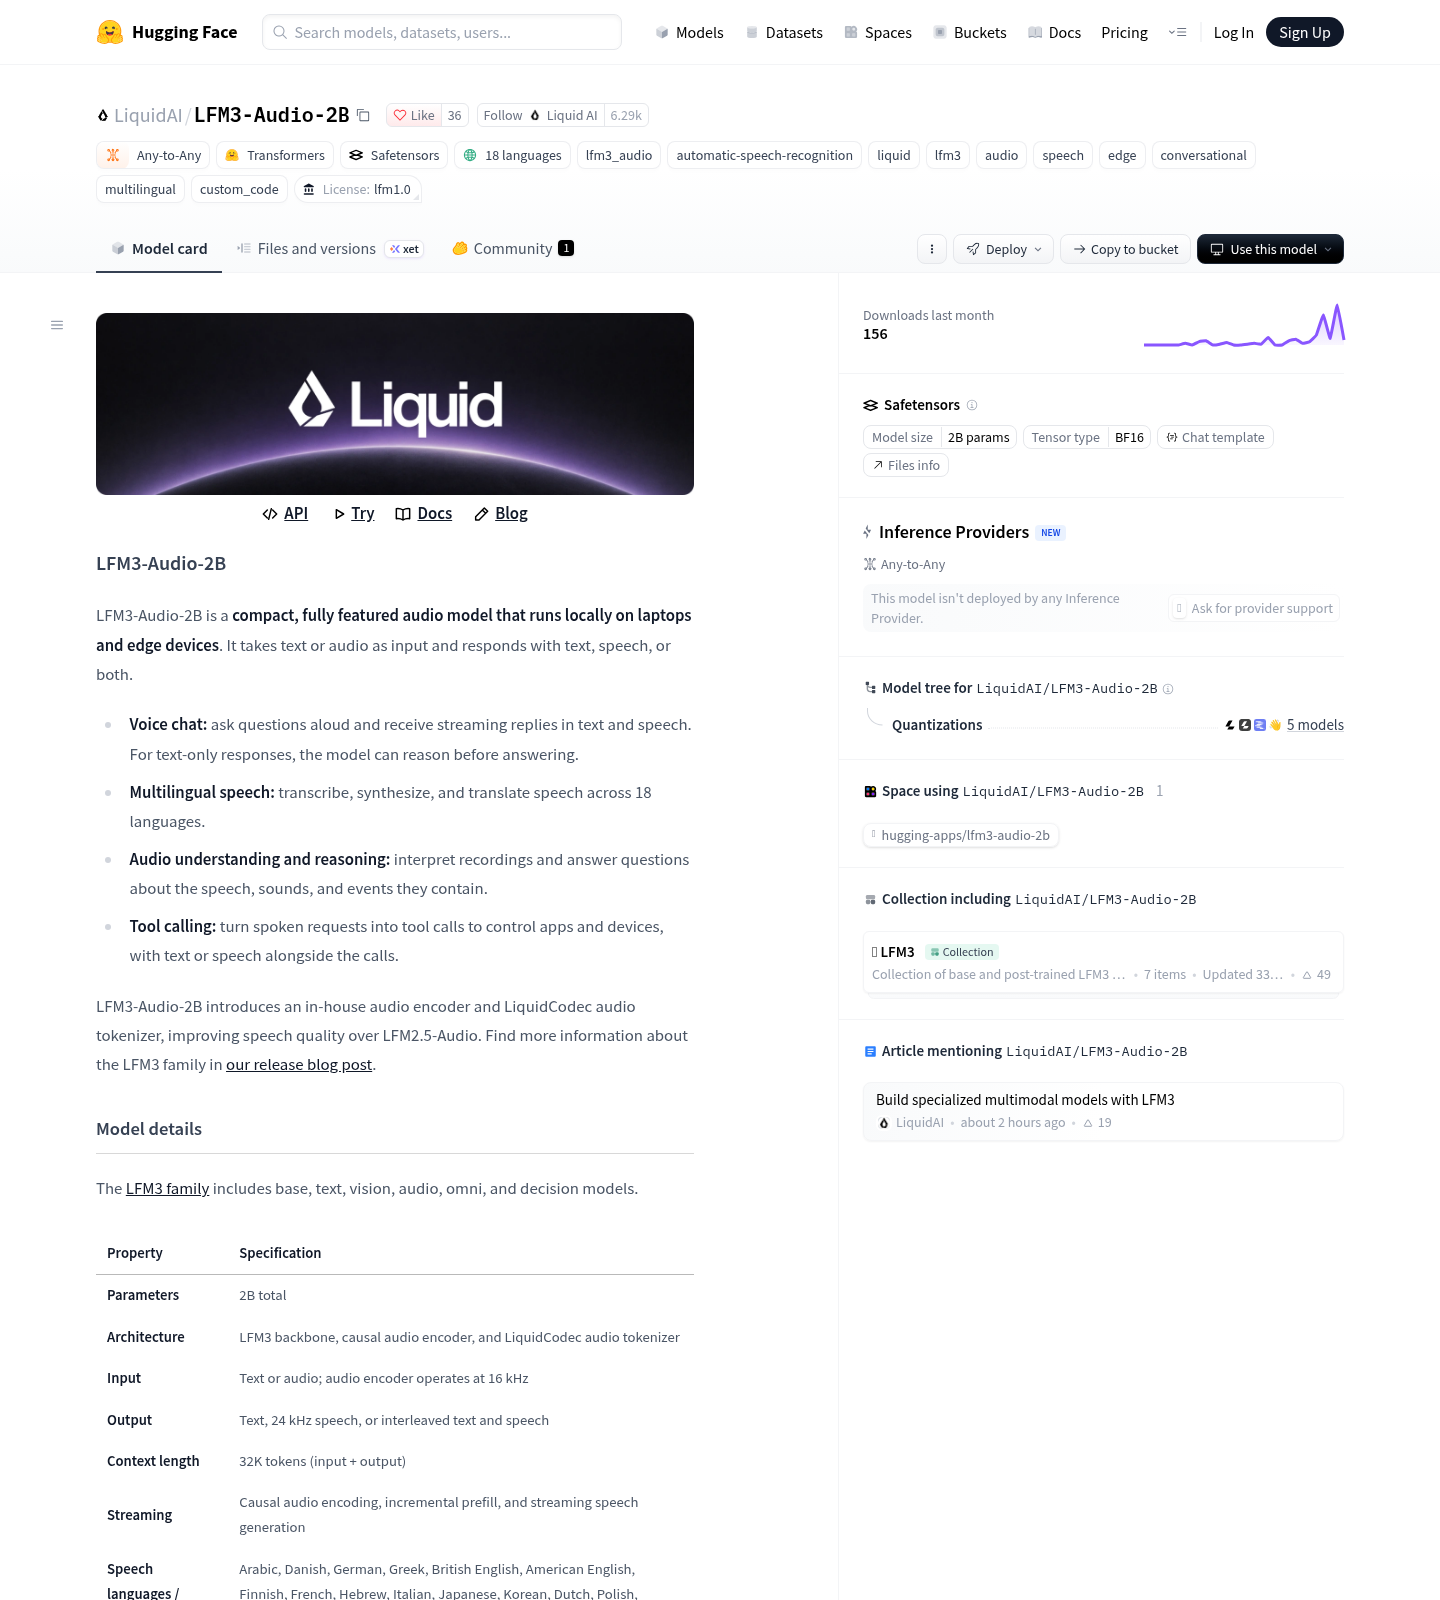
Di ranah model audio AI, LFM3-Audio-2B dan StepAudio 3 Realtime tidak benar-benar mengisi posisi yang sama. LFM3-Audio-2B merupakan checkpoint berbobot terbuka yang dapat diunduh; build Ollama berukuran 2,1 GB dan dapat berjalan di CPU. Satu model menangani pengenalan, sintesis, terjemahan, pemahaman audio, serta panggilan alat lisan. Cakupan sintesisnya mencantumkan 18 bahasa dalam 19 lokal, tetapi ASR langsung hanya tersedia dalam bahasa Inggris dan terjemahan paling kuat ketika melibatkan bahasa Inggris. StepAudio 3 Realtime adalah layanan API komersial tanpa bobot yang dapat diunduh. Keunggulannya lebih terukur: skor 98,9% pada tolok ukur Conversational Dynamics Artificial Analysis, peringkat pertama. Model ini mendukung percakapan full-duplex, memahami ucapan tanpa harus lebih dulu mentranskripsikannya, serta dapat memanggil alat saat tugas asinkron berjalan. Namun, waktu hingga audio pertama tercatat 8,83 detik pada papan yang sama; jadi kemenangan pada dinamika percakapan tidak berarti respons paling cepat. Pilih LFM3 jika privasi, akses lokal, dan kendali atas bobot model AI lebih penting daripada skor independen. Pilih StepAudio bila aplikasi membutuhkan percakapan langsung dan Anda menerima ketergantungan pada API. Skor unggul StepAudio bukan bukti bahwa ia mengalahkan LFM3 pada semua tugas; tolok ukur tersebut menilai aspek yang berbeda.
LFM3-Audio-2B dan Voxtral 3 bukan perbandingan setara
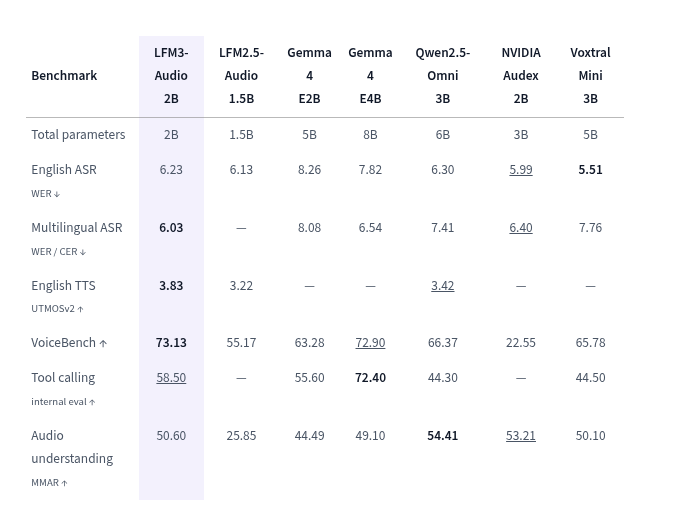
Voxtral 3 menempuh jalur layanan: bobotnya tidak tersedia untuk diunduh, sementara akses ditawarkan melalui API, playground, dan penerapan infrastruktur privat. Transcriber-nya mendukung lebih dari 50 bahasa, membuatnya lebih menarik bagi produk yang memerlukan cakupan bahasa luas tanpa tim harus menjalankan model sendiri. LFM3-Audio-2B lebih cocok bagi pengembang yang menginginkan checkpoint 2B untuk pemakaian lokal dan kendali implementasi. Akan tetapi, jangan menyimpulkan bahwa salah satunya lebih akurat dari angka benchmark yang tidak sepadan. Hasil Voxtral Mini 3B yang dicantumkan Liquid AI—WER bahasa Inggris 5,51% dibanding 6,23% untuk LFM3—mengacu pada model terbuka Mistral generasi sebelumnya, bukan Voxtral 3. Belum ada perbandingan langsung yang dipublikasikan antara LFM3-Audio-2B dan model Voxtral 3. Dengan demikian, keputusan yang bisa dibuat sekarang adalah soal cara penggunaan, bukan pemenang akurasi. LFM3 memberi akses ke berkas model dan pemrosesan lokal, tetapi cakupan ASR-nya terbatas. Voxtral 3 menawarkan transkripsi multibahasa melalui layanan, tetapi pengguna tidak mendapat bobot untuk menjalankan atau menyesuaikan sendiri. Jika kebutuhan utama Anda adalah bahasa yang didukung dan kemudahan integrasi, Voxtral 3 patut dipertimbangkan; jika kontrol dan akses lokal menjadi prioritas, LFM3 lebih sesuai.
Buy if / Skip if
Tentukan pilihan berdasarkan batasan produk Anda: akses ke bobot, kemampuan menjalankan model sendiri, cakupan bahasa, dan kebutuhan akan fitur layanan. Model terbuka tidak otomatis unggul, begitu pula skor tinggi tidak menjamin kecocokan untuk setiap aplikasi.
- Buy the HY-Nomas if Anda memerlukan bobot Apache 2.0 yang dapat dijalankan pada satu RTX 4090 dan disesuaikan untuk proyek sendiri.
- Skip the HY-Nomas if prioritas utama Anda adalah audio native dan dunia generatif koheren berdurasi sekitar dua menit.
- Buy the Genie 4 if Anda mengutamakan kemampuan dunia generatif dan audio terpadu, serta dapat bekerja dengan akses terbatas.
- Skip the Genie 4 if Anda membutuhkan bobot yang dapat diunduh, kontrol lokal, atau penyesuaian model secara langsung.
- Buy the LFM3-Audio-2B if Anda menginginkan model audio yang dapat diunduh dan dijalankan lokal, termasuk pada CPU.
- Skip the LFM3-Audio-2B if produk Anda memerlukan ASR langsung multibahasa atau bukti benchmark percakapan full-duplex.
- Buy the StepAudio 3 Realtime if percakapan full-duplex dan skor tinggi pada tolok ukur dinamika percakapan menjadi prioritas.
- Skip the StepAudio 3 Realtime if Anda perlu memiliki bobot, menjalankan model secara lokal, atau menghindari ketergantungan pada API.
- Buy the Voxtral 3 if Anda memerlukan transkripsi melalui layanan dengan dukungan lebih dari 50 bahasa.
- Skip the Voxtral 3 if Anda membutuhkan bobot model yang dapat diunduh atau perbandingan benchmark langsung dengan LFM3-Audio-2B.