
Memori AI Enterprise: Dari Bottleneck Menjadi Senjata Strategis Baru
Memori AI enterprise adalah kombinasi kapasitas dan bandwidth memori di GPU, CPU, dan modul eksternal yang dirancang khusus untuk menjalankan komputasi AI skala besar, mulai dari inferensi pusat data hingga agentic AI dengan context window panjang dan banyak agen yang aktif secara bersamaan dalam satu infrastruktur terintegrasi.
Gelombang baru perangkat AI menunjukkan satu hal: perang AI bukan lagi soal siapa punya GPU tercepat, tetapi siapa punya memori paling besar dan paling fleksibel. Persaingan infrastruktur kecerdasan buatan memasuki babak baru dengan terobosan kapasitas memori yang masif. Intel, Nvidia, dan Marvell sama‑sama mengirim pesan yang sama: tanpa ekspansi kapasitas memori yang agresif, komputasi AI skala besar akan mentok di bottleneck lama yang sama—VRAM habis, context dipotong, dan biaya inferensi membengkak.
Menurut Will Chu, “As AI scales, memory must scale more independently of compute.” Pernyataan ini merangkum pergeseran paradigma: memori tidak lagi sekadar aksesori di samping GPU, melainkan lapisan infrastruktur tersendiri yang harus bisa tumbuh, dibagi, dan diatur seperti sumber daya jaringan atau penyimpanan.
Intel D-Series 480 GB: Inferensi Pusat Data dan Agentic AI Tanpa Bongkar Rak
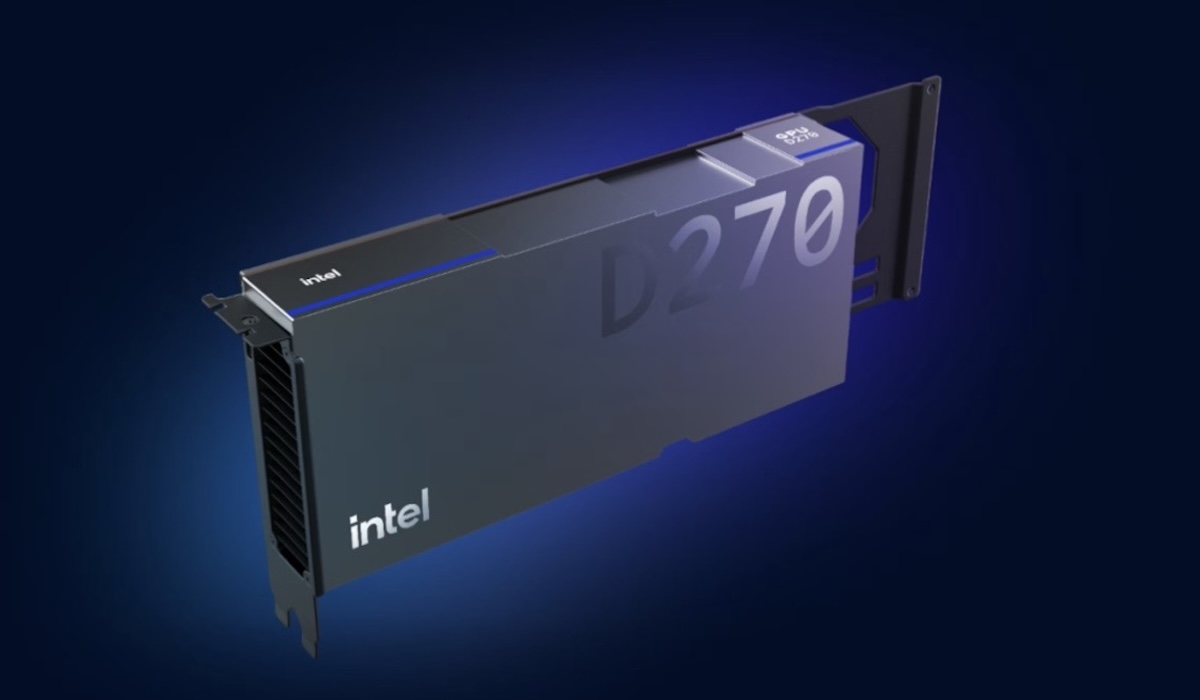
Intel memilih menyerang dari sisi inferensi pusat data. GPU D-Series (Crescent Island) dirancang khusus untuk menangani beban kerja inferensi AI di pusat data, bukan pelatihan model. Varian Intel D270 berbasis arsitektur Xe3P hadir dengan memori LPDDR5X 160 GB dan dapat ditingkatkan oleh ODM hingga 480 GB. Ini bukan sekadar angka besar; ini adalah pernyataan bahwa satu kartu inferensi sekarang bisa menyimpan model dan KV cache yang sebelumnya memaksa operator memecah beban ke banyak node.
Intel memposisikan D270 sebagai akselerator inferensi yang dioptimalkan untuk model yang sudah dilatih, dengan fokus pada agentic AI yang membutuhkan penalaran, pencarian mandiri, dan koordinasi multi‑tugas. Satu kartu diklaim mampu menjalankan model bahasa hingga 300 miliar parameter, dan konfigurasi delapan GPU dikatakan sanggup menangani model lebih dari satu triliun parameter. Bagi perusahaan, ini berarti mereka bisa mendorong memori AI enterprise ke kelas triliun parameter tanpa harus merombak total infrastruktur pusat data yang sudah ada.
Dari sudut pandang strategi, Intel bermain di dua sisi: mempertahankan CPU x86 sebagai pusat orkestrasi, sambil menambahkan GPU memori tinggi yang mengurangi kebutuhan migrasi ke arsitektur baru. Namun, hingga saat ini belum ada rincian harga maupun tanggal ketersediaan umum. Artinya, janji efisiensi biaya masih bersifat konseptual—operator pusat data perlu menunggu sebelum bisa menghitung ROI nyata.
Nvidia DGX Spark 1 TB: Unified Memory untuk LLM Lokal dan Banyak AI Agent
Jika Intel fokus pada satu kartu inferensi besar, Nvidia memilih pendekatan kluster kompak. Peningkatan terbaru memungkinkan delapan unit Nvidia DGX Spark dihubungkan menjadi satu kluster dengan unified memory hingga 1 TB. Untuk varian 64 GB, delapan unit menghasilkan 512 GB memori terpadu. Di sini, GPU memori tinggi bukan lagi satu perangkat tunggal, melainkan kumpulan node kecil yang berpikir seperti satu mesin besar.
Kapasitas memori raksasa ini dirancang untuk mengatasi hambatan utama saat menjalankan model AI tingkat lanjut di lingkungan lokal. LLM dengan context window panjang, beban beberapa AI agent sekaligus, dan eksperimen model riset mutakhir seperti GLM 5.3 dapat dijalankan tanpa bergantung penuh pada server cloud skala besar. Bagi tim riset dan pengembang, ini adalah pergeseran kekuasaan: mereka bisa membawa inferensi pusat data ke ruang lab atau kantor, dengan kontrol penuh atas data dan latensi.
Secara teknis, kluster mengandalkan jaringan ConnectX‑7 untuk menekan latensi antarnode. Kekurangannya, konfigurasi delapan sistem masih memerlukan pengaturan manual, dan Nvidia baru menjanjikan dukungan kluster otomatis lewat pembaruan Nvidia Sync akhir bulan ini. Namun arah strateginya jelas: unified memory skala 1 TB membuat ekspansi kapasitas memori menjadi fitur utama, bukan bonus, dalam desain sistem komputasi AI skala besar.
Marvell Photonic Fabric: Memori Optik 32TB sebagai “Pool Bersama” untuk AI
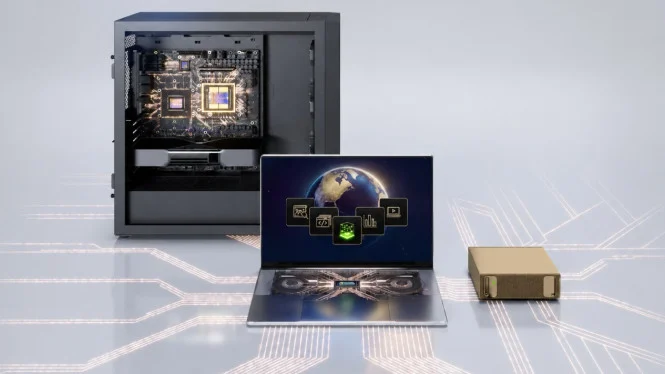
Jika Intel dan Nvidia masih bermain di ranah GPU dan node, Marvell mencoba mengubah aturan main memori itu sendiri. Photonic Fabric Memory Module diperkenalkan sebagai modul memori high-capacity, high-bandwidth dengan interkoneksi optik. Enam belas modul digabung menjadi Photonic Fabric Memory Appliance yang menyediakan 32TB DDR5 dan 1.152GB HBM3e, dibagi ke hingga 16 host melalui serat optik. Pendekatannya sederhana namun radikal: menggantikan tembaga dengan cahaya agar puluhan terabyte memori bisa ditempatkan di kotak terpisah dan dipakai bersama banyak prosesor sekaligus.
Target utamanya adalah KV cache LLM, yang membengkak pada konteks panjang dan sesi agentic. Saat KV cache melampaui HBM lokal dan DRAM host, server biasanya harus membuang, menghitung ulang, atau mengambil dari penyimpanan yang jauh lebih lambat. Dengan tier memori komunal, satu akselerator dapat menggunakan kembali konteks yang sudah dihitung akselerator lain sebagai cross‑node KV cache. Ini menggeser logika belanja: operator tidak perlu membeli GPU tambahan hanya untuk mendapat kapasitas HBM lebih besar, karena memori bisa dibeli terpisah dari compute.
Namun, solusi ini masih di horizon. Perangkat belum dikirim ke pelanggan dan Marvell menargetkan customer sampling pada 2027. Tanpa angka biaya yang jelas, argumen CAPEX masih berupa janji. Meski begitu, arah inovasinya penting: memori AI enterprise mulai diperlakukan seperti jaringan—dipool, dibagi, dan diakses lintas node, bukan lagi menempel kaku di satu GPU.
Menuju Arsitektur Memori AI Generasi Baru: Implikasi bagi Enterprise
Tiga pendekatan berbeda ini—GPU inferensi 480 GB dari Intel, kluster unified memory 1 TB dari Nvidia, dan memori optik 32TB dari Marvell—sebenarnya menjawab tekanan yang sama: tren kebutuhan memori yang terus meningkat untuk model AI skala besar di enterprise. Tanpa ekspansi kapasitas memori yang agresif, LLM dengan context panjang, agentic AI, dan beban inferensi pusat data generasi baru akan terjebak dalam siklus out‑of‑memory dan optimasi setengah hati.
Bagi pengambil keputusan TI, pesan praktisnya jelas. Pertama, perencanaan infrastruktur AI tidak boleh lagi berhenti di jumlah TFLOPS; memori AI enterprise—kapasitas, bandwidth, dan cara memori dibagi lintas node—harus menjadi metrik utama. Kedua, strategi investasi perlu memisahkan compute dan memori sejauh mungkin, sejalan dengan gagasan bahwa memori harus bisa berkembang lebih independen dari compute. Ketiga, eksperimen dengan GPU memori tinggi dan arsitektur memori bersama perlu dimulai sekarang, sebelum model dan workload melampaui kemampuan generasi perangkat keras saat ini.
Kesimpulannya, revolusi memori AI sudah berjalan dan tidak menunggu roadmap CPU atau GPU tradisional. Enterprise yang menganggap memori sekadar spesifikasi pendukung akan tertinggal; yang memperlakukannya sebagai lapisan strategis—setara jaringan dan penyimpanan—akan lebih siap menyambut komputasi AI skala besar berikutnya.