
Pemrosesan AI Lokal: Dari Cloud ke Perangkat Pribadi
Pemrosesan AI lokal adalah pendekatan komputasi di mana model kecerdasan buatan, termasuk model bahasa besar dan generator gambar atau video, dijalankan langsung di perangkat pengguna tanpa bergantung pada server jarak jauh atau layanan cloud, sehingga mengurangi latensi, ketergantungan internet, dan risiko kebocoran data pribadi sekaligus membuka peluang baru bagi perangkat pribadi menjadi pusat komputasi cerdas yang mandiri. Pergeseran ini bukan tren kosmetik, melainkan respons terhadap tiga masalah nyata: biaya langganan cloud yang makin berat, kekhawatiran privasi data, dan jeda waktu saat aplikasi harus bolak-balik ke server untuk setiap permintaan. Ketika komputasi AI offline menjadi mungkin di laptop dan mini PC, pengguna tidak lagi sekadar "klien tipis" yang pasif, tetapi pemilik penuh atas alur kerja dan data mereka.

GPU Blackwell RTX Spark: Laptop Biasa, Mesin AI Luar Biasa
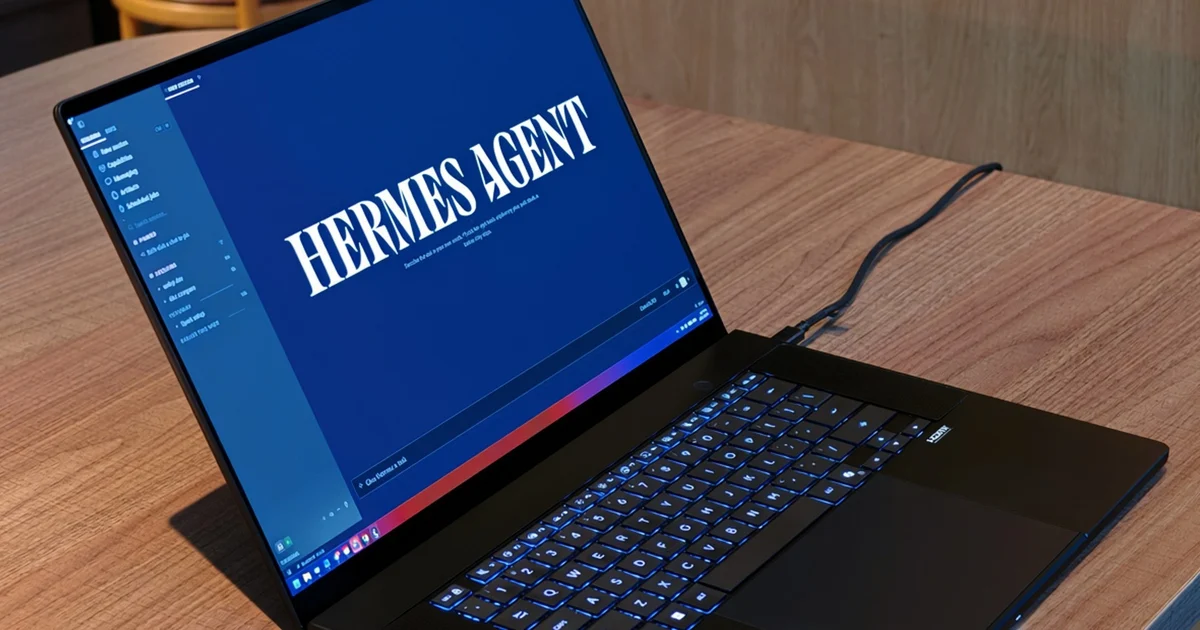
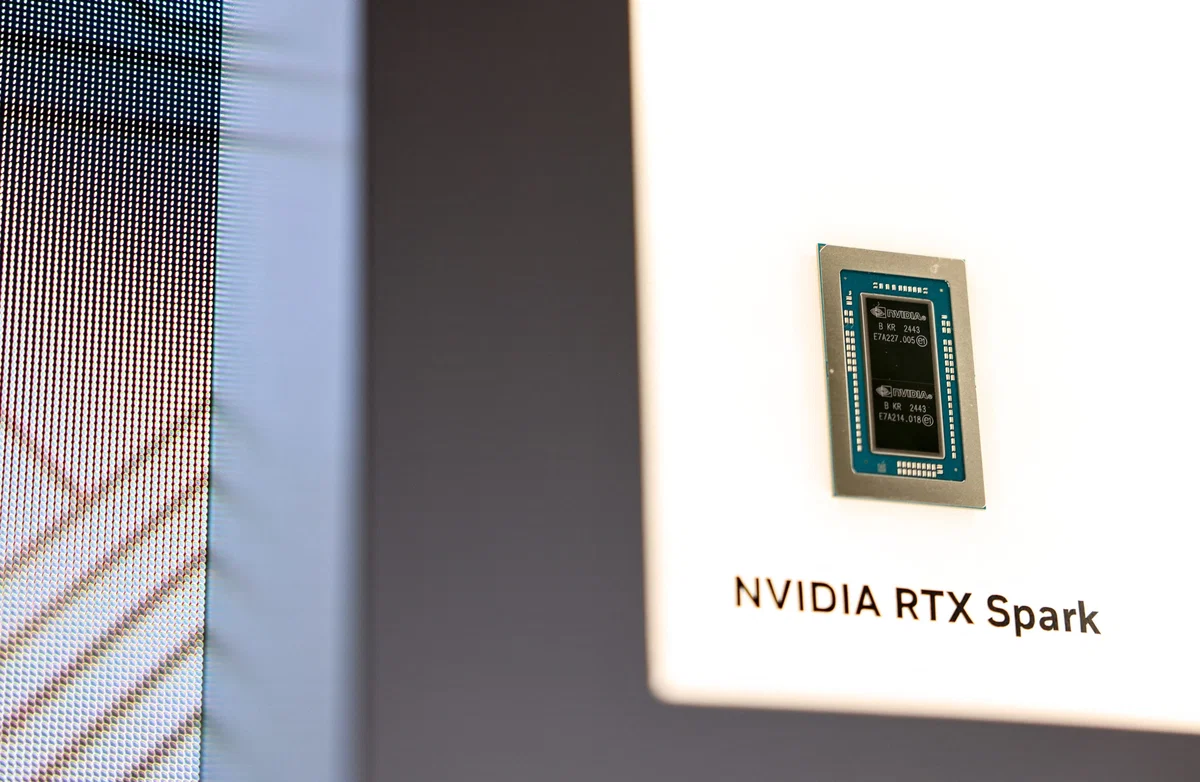
Peluncuran RTX Spark pada tanggal 16 menandai ambisi jelas: menjadikan laptop Windows sebagai mesin pemrosesan AI lokal berperforma tinggi, bukan sekadar terminal cloud. Superchip ini menggabungkan GPU RTX berbasis Blackwell dan CPU Grace, dengan memori terintegrasi hingga 128GB yang dibagi antara CPU dan GPU untuk menjaga aliran data tetap cepat dan efisien. Di konfigurasi tertinggi, kombinasi 6.144 CUDA core dan CPU Grace 20-core mampu mencapai performa AI hingga 1 petaflop pada FP4, sementara arsitektur memori LPDDR5X bersama menawarkan bandwidth sampai 300 GB/detik. "Dengan memori gabungan 64 GB, RTX Spark dapat menjalankan model AI dengan puluhan miliar parameter langsung di laptop". Ini bukan lagi demo futuristik: pengguna bisa menjalankan LLM besar, agen AI seperti Hermes, hingga alat pengembang kode secara lokal tanpa koneksi cloud permanen.
Dari Chatbot ke Studio Kreatif: Apa yang Bisa Dilakukan Secara Offline
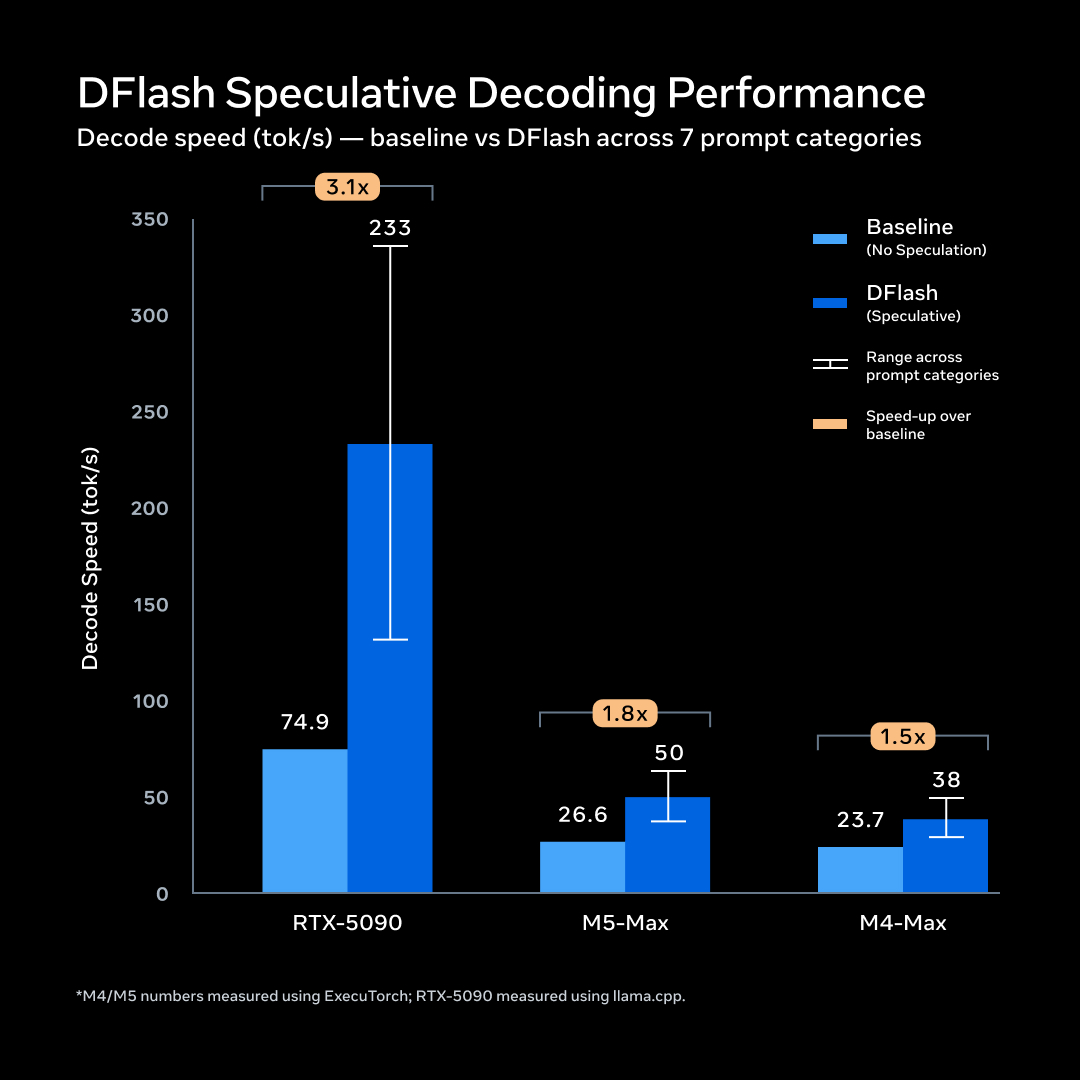
Kekuatan pemrosesan AI lokal baru terasa ketika kita melihat jenis tugas yang kini bisa dijalankan langsung di perangkat. Pengujian pada RTX Spark menunjukkan laptop ini mampu menangani model bahasa skala besar seperti Qwen3.8 27B untuk tugas multi-langkah, mulai dari analisis permintaan hingga penulisan kode, dengan kecepatan generasi teks yang meningkat dari 20,69 menjadi 36,22 token per detik berkat optimasi DFlash. Di ranah kreatif, ComfyUI memungkinkan pembuatan gambar dan video langsung di perangkat; model FLUX.2 Klein 4B menghasilkan gambar dalam rata-rata 14,05 detik, sementara LTX 2.5 menyelesaikan pembuatan video sekitar 68,51 detik. Lebih menarik lagi, agen Hermes yang berjalan lokal mampu mengembangkan aplikasi Windows QuickWebP secara mandiri dalam sekitar 2 jam 9 menit, termasuk mendeteksi dan memperbaiki kesalahan pustaka, lalu memproses ratusan gambar JPG dalam hitungan menit. Infrastruktur edge AI semacam ini mengubah laptop menjadi studio kreatif dan laboratorium pengembangan yang sepenuhnya berada di tangan pengguna.
Axera AX8860P: NPU Akselerator AI Menantang Dominasi GPU
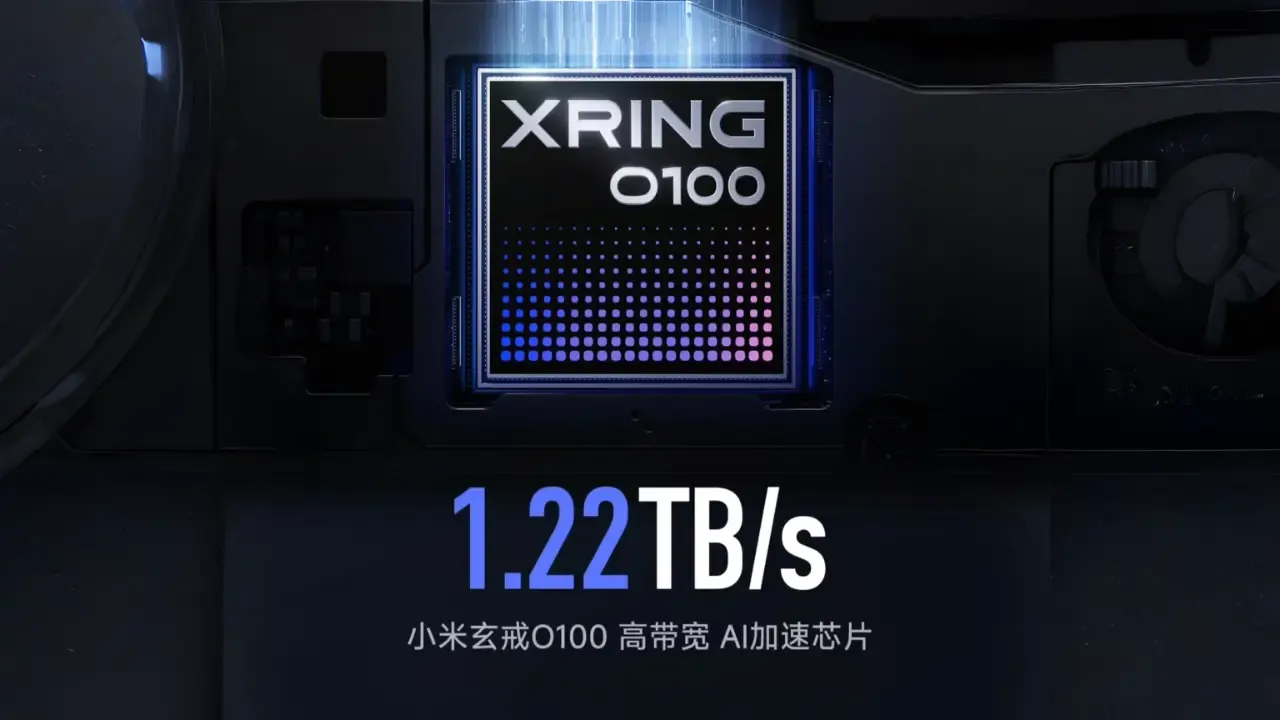
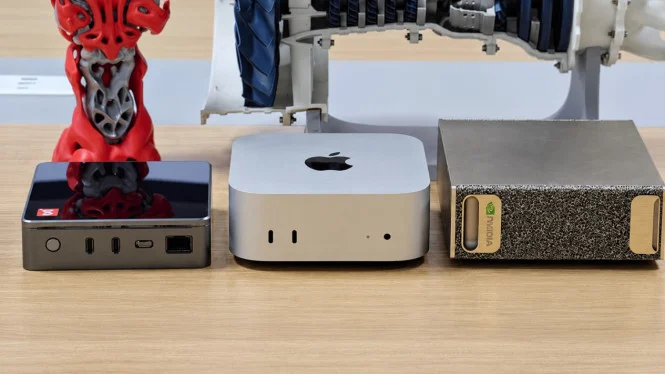
Di sisi lain spektrum, Axera mengambil jalur berbeda untuk komputasi AI offline dengan cip AX8860P yang dibekali NPU AXNeutron sebagai akselerator pemrosesan saraf mandiri. Tidak seperti pendekatan GPU klasik ala Blackwell, AXNeutron mengandalkan rancangan programmable dataflow yang mengoptimalkan aliran data langsung di tingkat perangkat keras, dengan klaim daya komputasi hingga 256 TOPS pada presisi FP4. Cip ini dirancang sebagai system-on-chip untuk komputer mini seperti Sipeed MaixStation, menjadikannya chip AI edge device yang ringkas namun siap menangani beban inferensi LLM dan model visi secara lokal. Perangkat Mini PC AI berbasis AX8860P diproyeksikan menjadi mesin komputasi lokal berkinerja tinggi yang menantang dominasi perangkat keras AI kelas atas, terutama di segmen yang membutuhkan efisiensi daya dan biaya tanpa mengorbankan kemampuan menjalankan model kompleks. Jika berhasil, ekosistem NPU akselerator AI seperti AXNeutron bisa memaksa pasar keluar dari ketergantungan tunggal pada GPU Nvidia.
Privasi, Kedaulatan Data, dan Masa Depan Komputasi AI Offline
Inti dari pemrosesan AI lokal bukan hanya soal performa, tetapi soal kedaulatan data. Ketika LLM dan agen AI berjalan langsung di perangkat, kebutuhan untuk mengirim dokumen, kode, atau gambar sensitif ke server jauh berkurang drastis. Pengguna dapat mengedit gambar, membuat video, dan mengembangkan aplikasi dengan bantuan AI tanpa meninggalkan jejak di infrastruktur pihak ketiga. Tingginya biaya cloud dan isu privasi internal sudah lama menjadi keluhan; kini, hardware seperti GPU Blackwell RTX Spark dan NPU AXNeutron menawarkan jalan keluar yang konkret. Tentu, model hibrida yang memadukan perangkat lokal dan cloud masih akan bertahan, terutama untuk tugas yang melampaui kapasitas memori atau komputasi perangkat. Namun arah pergeseran sudah jelas: masa depan AI yang sehat adalah masa depan di mana komputasi cerdas terjadi sedekat mungkin dengan pengguna, di laptop dan mini PC mereka sendiri. Siapa pun yang mengabaikan komputasi AI offline berisiko tertinggal dalam perlombaan privasi, efisiensi, dan kendali atas data.