
AI Agentic Butuh Tiga Kelas Chip, Bukan Satu
Arsitektur AI agentic adalah rancangan komputasi yang menyatukan CPU, GPU, dan akselerator khusus untuk menjalankan agen AI otonom skala besar, mulai dari orkestrasi di pusat data, inferensi di cloud, hingga pemrosesan langsung di perangkat pengguna akhir, dengan fokus pada efisiensi biaya dan performa yang dapat disesuaikan kebutuhan beban kerja. Intel memamerkan tiga arsitektur AI agentic barunya di ajang Hot Chips 2026: Diamond Rapids, Crescent Island, dan Wildcat Lake. Langkah ini menandai pergeseran strategi: bukan lagi satu prosesor serbaguna, tetapi portofolio yang membentang dari rak server sampai laptop. Menurut penulis, inilah cara paling masuk akal menghadapi AI agentic, karena beban kerja orkestrasi, pelatihan ringan, dan inferensi di edge memiliki karakter yang sangat berbeda—baik dari sisi performa, konsumsi daya, maupun anggaran.
Diamond Rapids 256 Core: Pondasi Baru Prosesor AI Enterprise
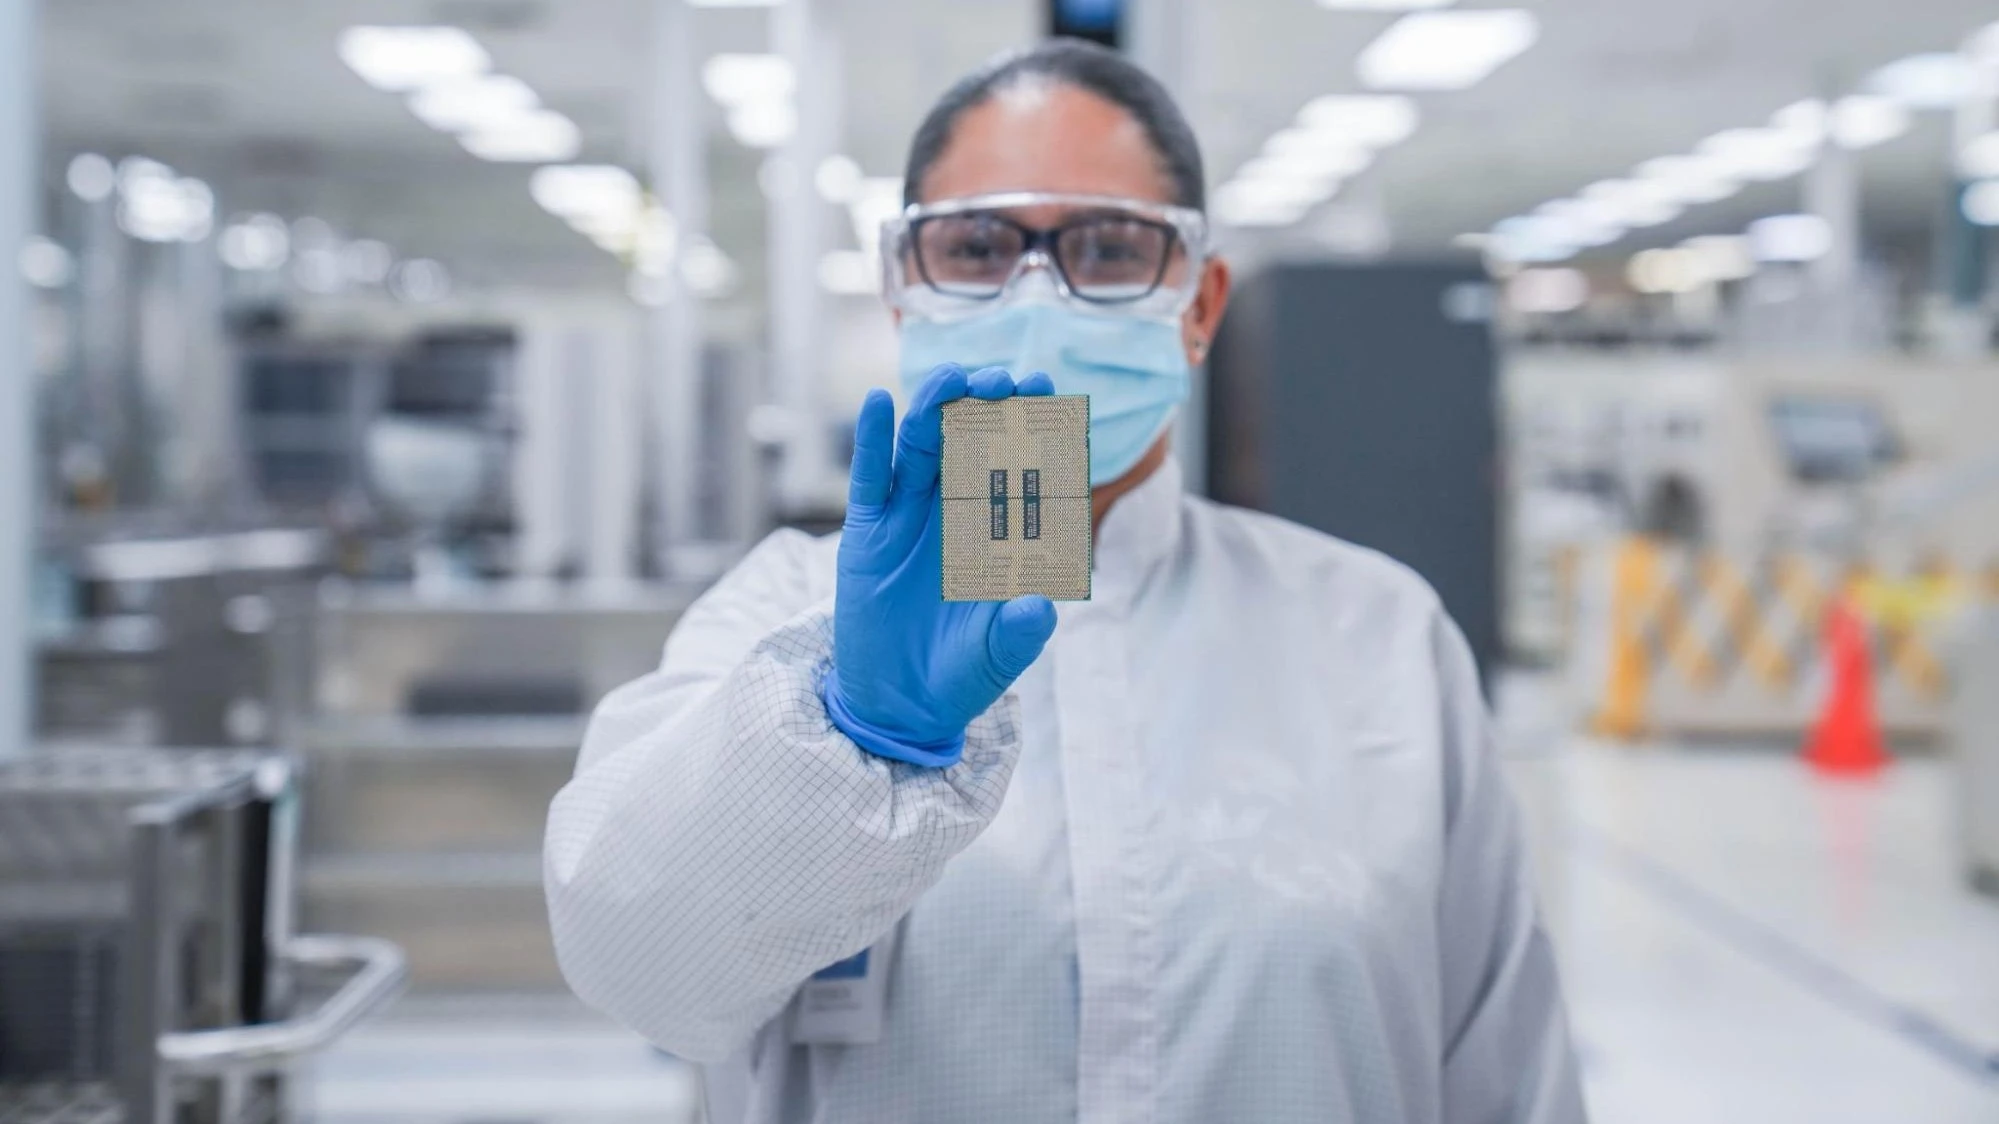
Diamond Rapids jelas diposisikan sebagai prosesor AI enterprise generasi baru. CPU pusat data ini dapat dikonfigurasi hingga 256 core, dilengkapi 1,28 GB last-level cache, 16 channel memori hingga 12.800 MT/s, serta 128 lane PCIe Gen 6 dan CXL 3.0. Secara spesifikasi, ia didesain sebagai fondasi komputasi untuk Agentic AI di lingkungan enterprise, dan nantinya dipasarkan sebagai lini Xeon 7. Namun, konfigurasi 256 core ini datang dengan catatan: AMD sudah menawarkan 256 core dengan dukungan multithreading melalui EPYC 9996, sementara Diamond Rapids baru dijadwalkan hadir pada 2027. Artinya, Intel tidak sekadar berlomba soal jumlah core, tetapi harus membuktikan bahwa kombinasi APX, AMX, dan arsitektur chiplet 18A-P mampu memberikan performa per watt dan total biaya kepemilikan yang menarik untuk workload AI agentic jangka panjang.
GPU Inferensi Crescent Island: Taruhan Berani Lawan HBM
Di sisi GPU inferensi, Crescent Island adalah kartu PCIe 350W berpendingin udara berbasis arsitektur Xe3P, dengan 32 core yang menggerakkan 256 mesin XMX generasi ketiga dan 32 MB unified L2 cache. Intel menyebutnya sebagai GPU berdaya lebih rendah untuk AI inference, menggunakan memori LPDDR5X hingga 480 GB, meski kartu bermerek Intel dibatasi 160 GB. Pemilihan LPDDR5X alih-alih HBM adalah keputusan strategis: mengorbankan bandwidth puncak demi kapasitas besar, konsumsi daya yang lebih jinak, dan biaya sistem yang lebih terkontrol. Menurut penulis, ini menjadikan GPU inferensi Crescent Island lebih cocok untuk deployment skala luas dan inferensi model besar yang sensitif terhadap total biaya, bukan sekadar mengejar angka benchmark. Namun, Intel belum mengungkap bandwidth memori, padahal angka ini krusial untuk throughput decode dan ekonomi token di beban kerja generatif.
Wildcat Lake UCIe: AI Mainstream yang Masih Tertahan NPU
Wildcat Lake adalah satu-satunya dari tiga arsitektur yang sudah bisa dibeli konsumen saat ini, hadir sebagai Intel Core Series 3 untuk mini PC dan laptop. SoC ini memakai dua performance core dan empat efficiency core, grafis terintegrasi Xe3 dengan akselerasi XMX, serta NPU dengan kemampuan hingga 17 TOPS. Wildcat Lake juga menjadi prosesor Intel pertama yang menggunakan UCIe, memperjelas arah jangka panjang menuju ekosistem chiplet yang lebih fleksibel di segmen klien. Namun, di sisi AI lokal, angka 17 TOPS NPU masih jauh di bawah 40 TOPS yang disyaratkan untuk sertifikasi Copilot+; 40 TOPS yang diklaim Intel adalah total gabungan CPU, GPU, dan NPU, bukan dari NPU saja. Itu berarti, untuk sekarang, Wildcat Lake lebih cocok dilihat sebagai batu loncatan menuju laptop AI mainstream, bukan ujung tombak komputasi agentic di sisi klien.
Strategi Tiga Lapisan Intel: Kuat di Visi, Waktu Eksekusi Menjadi Taruhan
Dengan Diamond Rapids di pusat data, GPU inferensi Crescent Island untuk beban AI kompleks, dan Wildcat Lake di klien, Intel sedang membangun ekosistem arsitektur AI agentic dari cloud hingga edge. Perusahaan tegas menyasar efisiensi biaya dan performa, memanfaatkan proses 18A, Foveros Direct 3D, dan interkoneksi chiplet berbasis UCIe untuk desain yang lebih fleksibel. Menurut penulis, visi ini tepat: enterprise tidak ingin solusi AI yang mahal dan boros daya, melainkan platform yang bisa diskalakan sesuai kebutuhan. Namun, keberadaan tiga arsitektur ini belum otomatis menjamin Intel mampu mengejar kebutuhan AI yang berkembang cepat; performa nyata, harga, dan ketersediaan produk akan menjadi penentu di lapangan. Dengan Diamond Rapids baru hadir 2027 dan Wildcat Lake belum memenuhi standar NPU Copilot+, pertanyaan kuncinya adalah apakah Intel bisa mengeksekusi peta jalan ini cukup cepat sebelum kompetitor mengunci lebih banyak pangsa pasar.