
DeepInfer: Membuka Dapur Mesin Inferensi DeepSeek
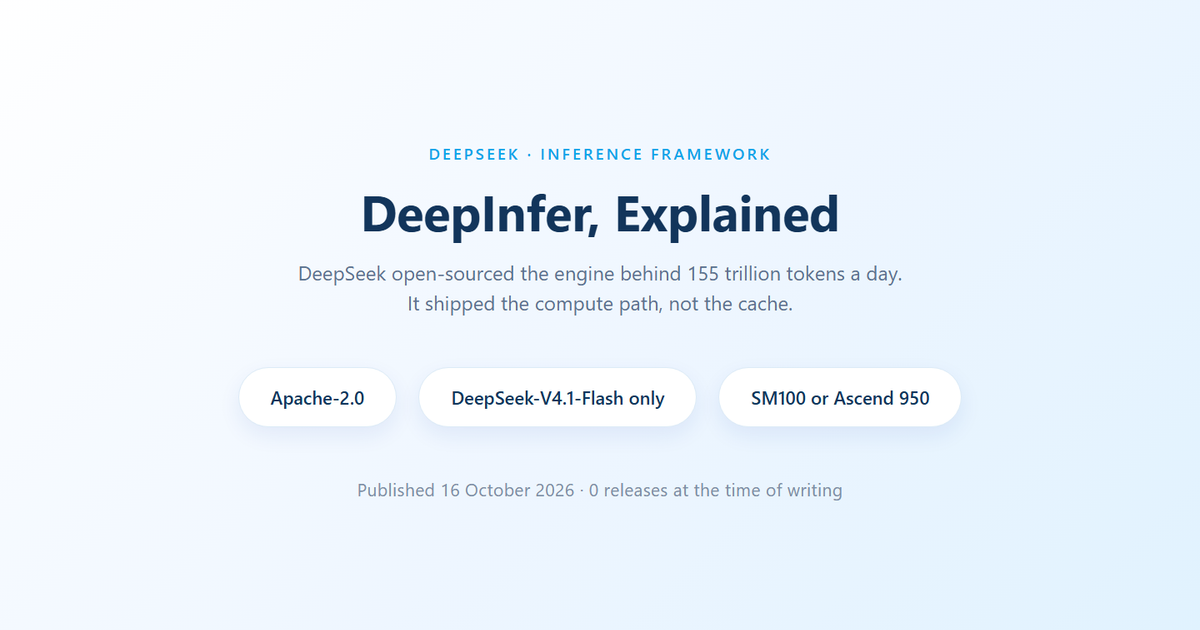
DeepInfer adalah kerangka kerja inferensi AI open-source berlisensi Apache-2.0 yang menjadi mesin produksi di balik model DeepSeek-V4.1-Flash, dirancang khusus untuk mengoptimalkan efisiensi inferensi AI terdistribusi dan menekan biaya deployment model AI skala besar melalui kombinasi kernel kustom, paralelisme canggih, dan teknik decoding spekulatif. Rilis ini bukan sekadar repositori baru di GitHub; ini adalah pernyataan bahwa perang biaya deployment AI tidak lagi ditentukan hanya oleh kecanggihan model bahasa besar, tetapi oleh seberapa efisien framework LLM efisien di lapisan inferensi. DeepSeek menerbitkan DeepInfer pada 16 Oktober 2026 sebagai perangkat lunak open-source yang memberikan akses langsung ke kerangka inferensi internal yang selama ini menyalakan sistem V4.1-Flash mereka. Dengan langkah ini, mereka mengundang komunitas developer untuk mengkloning, membangun, dan memodifikasi jalur komputasi yang sebelumnya eksklusif, sambil secara terang-terangan menyisakan komponen infrastruktur yang tetap tertutup.
Apa Saja yang Sebenarnya Dibuka DeepInfer?
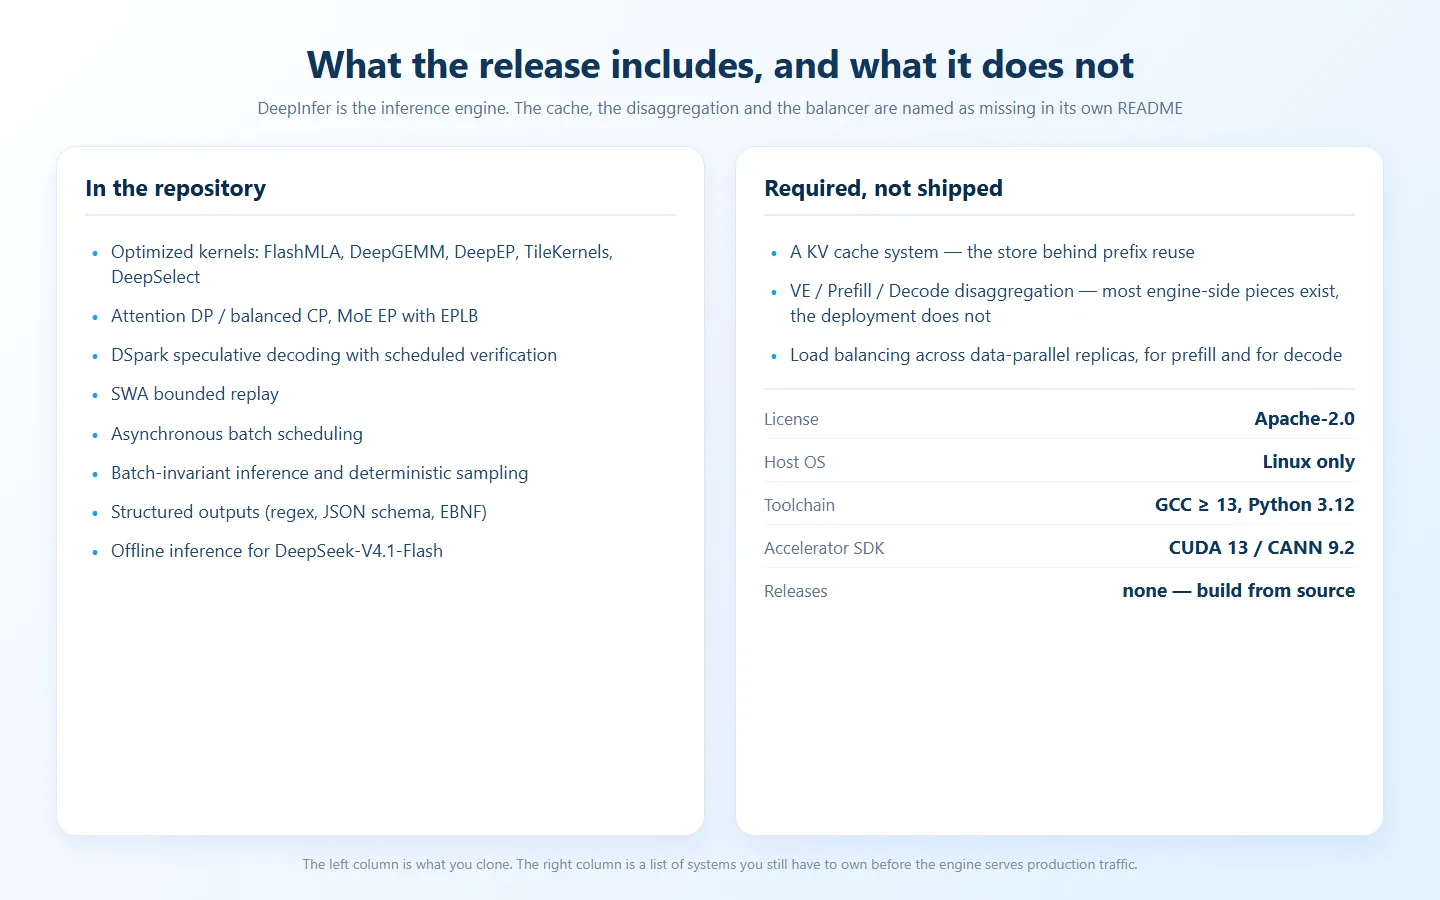
Inti DeepInfer adalah jalur komputasi inferensi: kumpulan kernel, skema paralelisme, decoding spekulatif, penjadwalan, dan keluaran terstruktur. Di dalamnya terdapat pustaka kernel yang sudah dikenal, seperti FlashMLA untuk attention, DeepGEMM untuk perkalian matriks, DeepEP untuk komunikasi expert-parallel, ditambah TileKernels dan DeepSelect. Attention berjalan sebagai data parallelism dengan context parallelism yang seimbang, sementara bagian mixture-of-experts menggunakan expert parallelism dengan load balancer khusus. DeepInfer juga menyertakan DSpark, stack speculative decoding dengan panjang verifikasi yang dijadwalkan, serta mekanisme SWA bounded replay yang mencegah cache attention sliding-window memaksa komputasi ulang penuh pada setiap cache miss. Di sisi antarmuka, ada penjadwalan batch asinkron, inferensi batch-invariant dengan sampling deterministik, dan output terstruktur yang dapat dibatasi oleh regex, skema JSON, atau EBNF. Namun, yang sengaja tidak dibuka adalah sistem cache KV, logika disagregasi vision encoder/prefill/decode, dan penyeimbangan beban lintas replika paralel-data—tiga komponen yang justru menentukan seberapa murah jalur komputasi ini dapat dioperasikan pada skala besar.
Inferensi AI Terdistribusi: Cara DeepInfer Menekan Biaya Deployment
DeepInfer secara eksplisit dirancang sebagai framework LLM efisien untuk menekan biaya deployment AI, bukan hanya mempercepat satu GPU. Mesin ini mengintegrasikan beberapa metodologi pengurangan biaya yang telah terbukti, termasuk inferensi AI terdistribusi dan speculative decoding yang disesuaikan untuk memaksimalkan efisiensi chip di seluruh arsitektur model DeepSeek. Beban kerja didistribusikan ke seluruh kluster perangkat keras, sementara proses pembuatan output disederhanakan sehingga biaya komputasi per permintaan turun tanpa memerlukan modifikasi perangkat keras khusus. Sistem ini dipisahkan menjadi encoder visi, prefill dan decode, ditambah node penyimpanan khusus, sehingga setiap tahap dapat diskalakan terhadap bottleneck-nya sendiri. Tolok ukur yang dipublikasikan diukur pada empat GPU SM100 untuk prefill dan 64 GPU SM100 untuk decode, yang menunjukkan bentuk deployment model AI yang memang ditargetkan untuk throughput tinggi, bukan demo di laptop. Kombinasi ini menjadikan DeepInfer lebih mirip cetak biru cara menjalankan LLM besar dengan biaya operasional yang lebih terkendali, dibandingkan sekadar library inferensi generik.
Gerbang Perangkat Keras dan Dampaknya bagi Pengguna
Di balik narasi open-source, DeepInfer tetap selektif terhadap perangkat keras: mesin ini menargetkan akselerator NVIDIA SM100 dan Huawei Ascend 950, tanpa jalur untuk Ampere atau Hopper yang mendominasi banyak klaster saat ini. Toolchain-nya pun ketat—hanya Linux, GCC 13 ke atas, Python 3.12, CUDA 13 untuk NVIDIA atau CANN 9.2 untuk Ascend, dan tidak ada rilis siap unduh; pengguna harus mengkloning dan membangun sendiri. Anggaran interkoneksi yang disebutkan sekitar 400 Gbps per delapan GPU, dengan pengakuan bahwa serat optik antar bangunan mudah terpotong. Bagi penyedia layanan cloud dan perusahaan yang men-deploy model AI pada infrastruktur privat, efisiensi perangkat lunak seperti ini langsung memengaruhi margin operasional dan harga bagi pengguna akhir. Menurut salah satu laporan, "DeepInfer bertujuan membantu organisasi eksternal meningkatkan utilisasi perangkat keras, mendongkrak throughput permintaan, dan secara signifikan mengurangi latensi eksekusi." Artinya, pengguna biasa tidak akan mengkompilasi DeepInfer sendiri, tetapi mereka akan merasakan dampaknya lewat layanan AI yang lebih cepat dan lebih murah.
Open-Source, Satu Model, dan Masa Depan Framework LLM Efisien
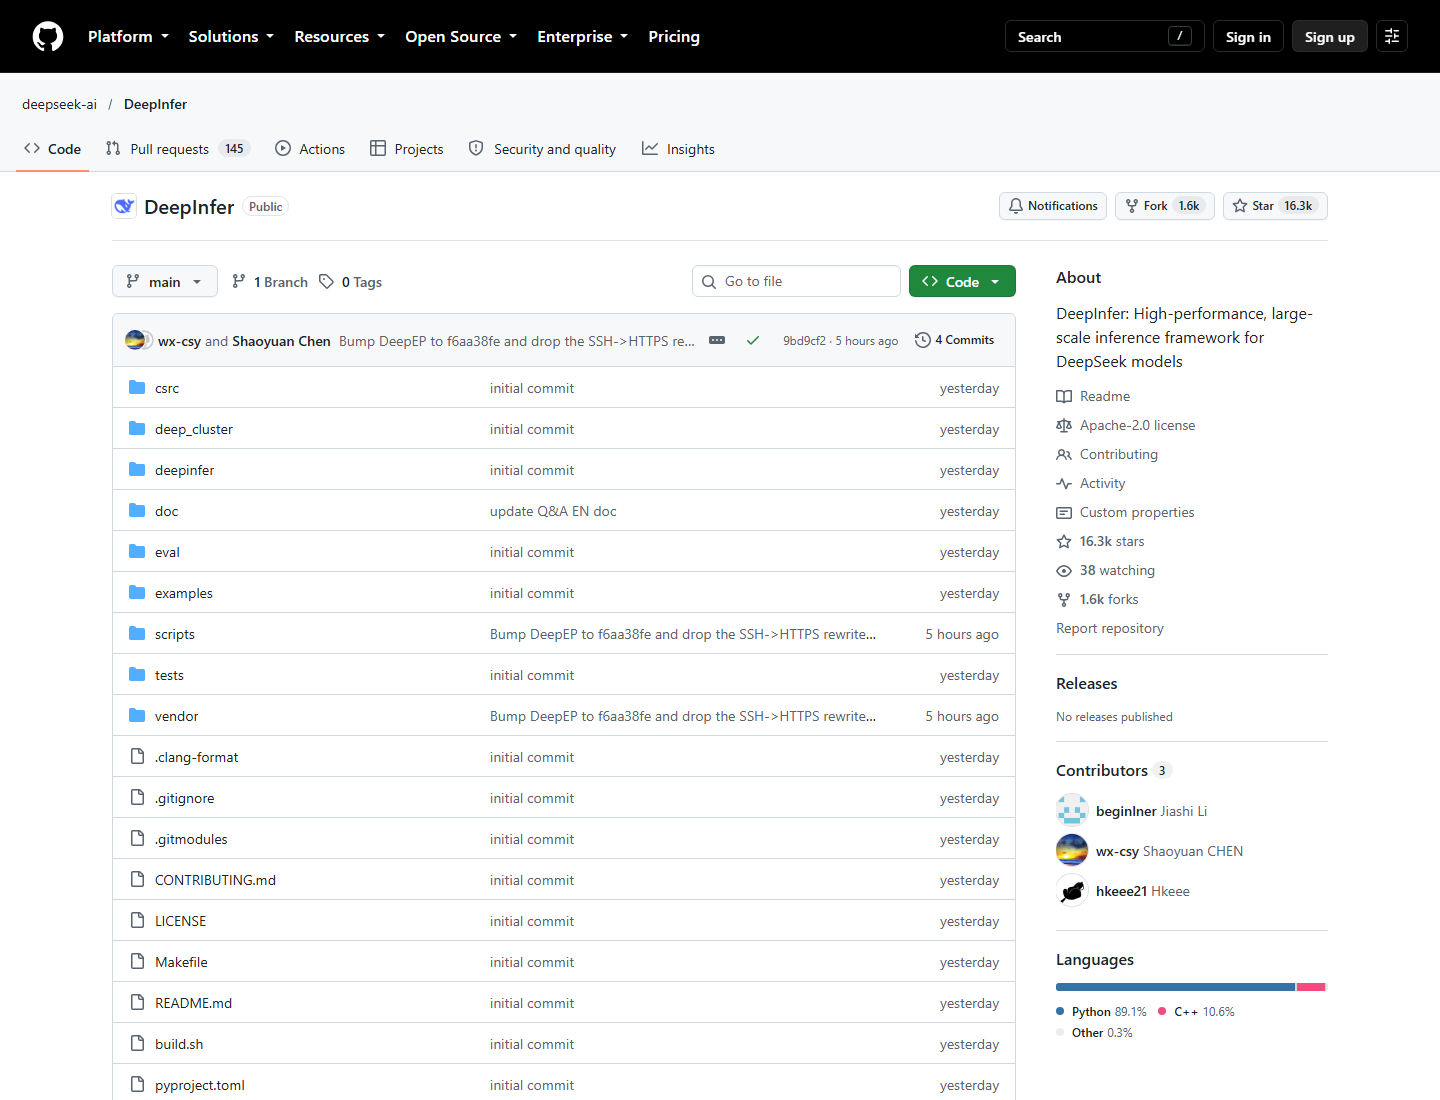
Meski DeepInfer open source, cakupannya sengaja dibatasi: kerangka ini melayani tepat satu model, DeepSeek-V4.1-Flash, dengan DeepSeek-V4.1-Flash-1017 sebagai checkpoint default. Titik masuknya dibuat kecil; setelah menyetel DEEPINFER_ACCELERATOR ke nvidia atau Ascend dan menjalankan build.sh, pengguna dapat menjalankan contoh offline_inference.py dari awal hingga akhir, mengarahkan DEEPINFER_HF_MODEL_DIR ke direktori bobot yang berbeda. Perusahaan mengonfirmasi bahwa kode inferensi dan optimasi berkelanjutan untuk iterasi model di masa mendatang juga akan dipublikasikan melalui repositori open-source tersebut. Secara praktis, ini berarti komunitas developer mendapat akses ke mesin inferensi produksi yang terus berevolusi, sementara lapisan penyimpanan dan perutean tetap menjadi keunggulan internal. Di GitHub, repositori DeepInfer dapat dikloning dan dibangun dengan toolchain sendiri, membuka ruang bagi port pihak ketiga ke GPU generasi sebelumnya dan adaptasi ke ekosistem yang lebih luas. Kesimpulannya, DeepSeek tidak sedang memberi kita "produk jadi", melainkan kerangka pikir: bahwa mengurangi biaya deployment AI dimulai dari jalur komputasi yang efisien, dan sisanya adalah tugas komunitas dan operator untuk mengisi celah infrastruktur.