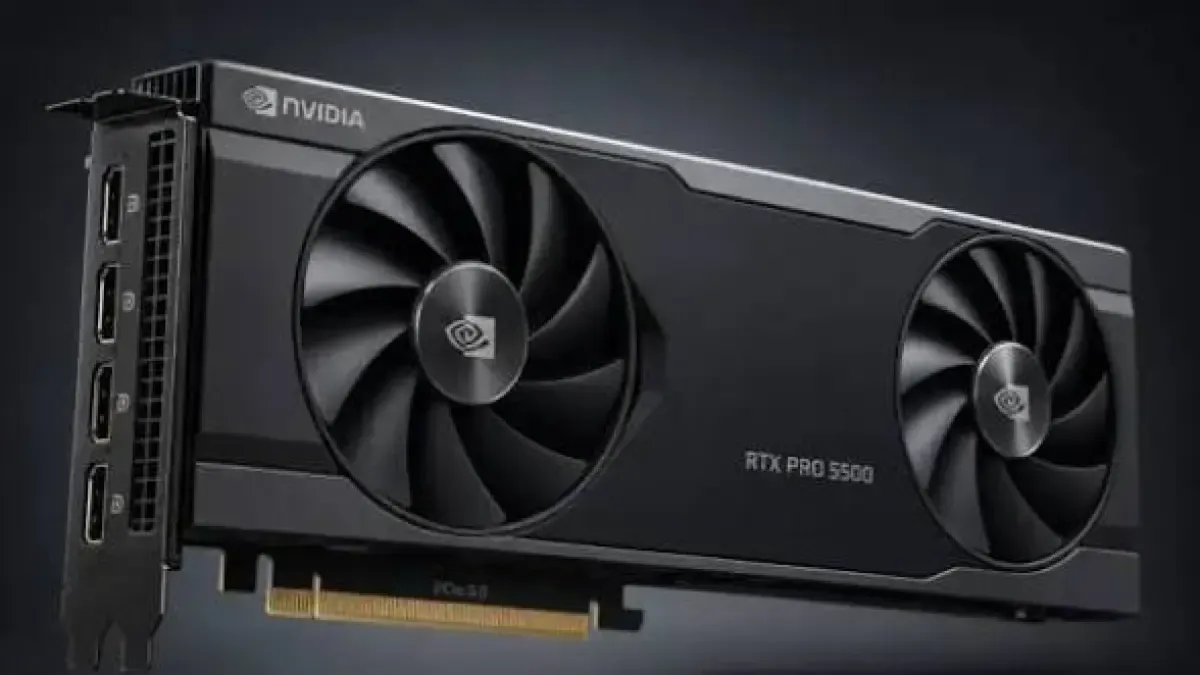

Apa Itu RTX Pro 5500 Blackwell dan Mengapa Penting
RTX Pro 5500 Blackwell adalah GPU AI profesional berbasis arsitektur Blackwell yang memakai chip GB202 turunan GeForce RTX 5090, tetapi dikonfigurasi ulang sebagai kartu workstation dengan fokus pada kapasitas memori besar dan stabilitas untuk beban kerja kecerdasan buatan, simulasi fisika, serta aplikasi grafis profesional berintensitas tinggi.
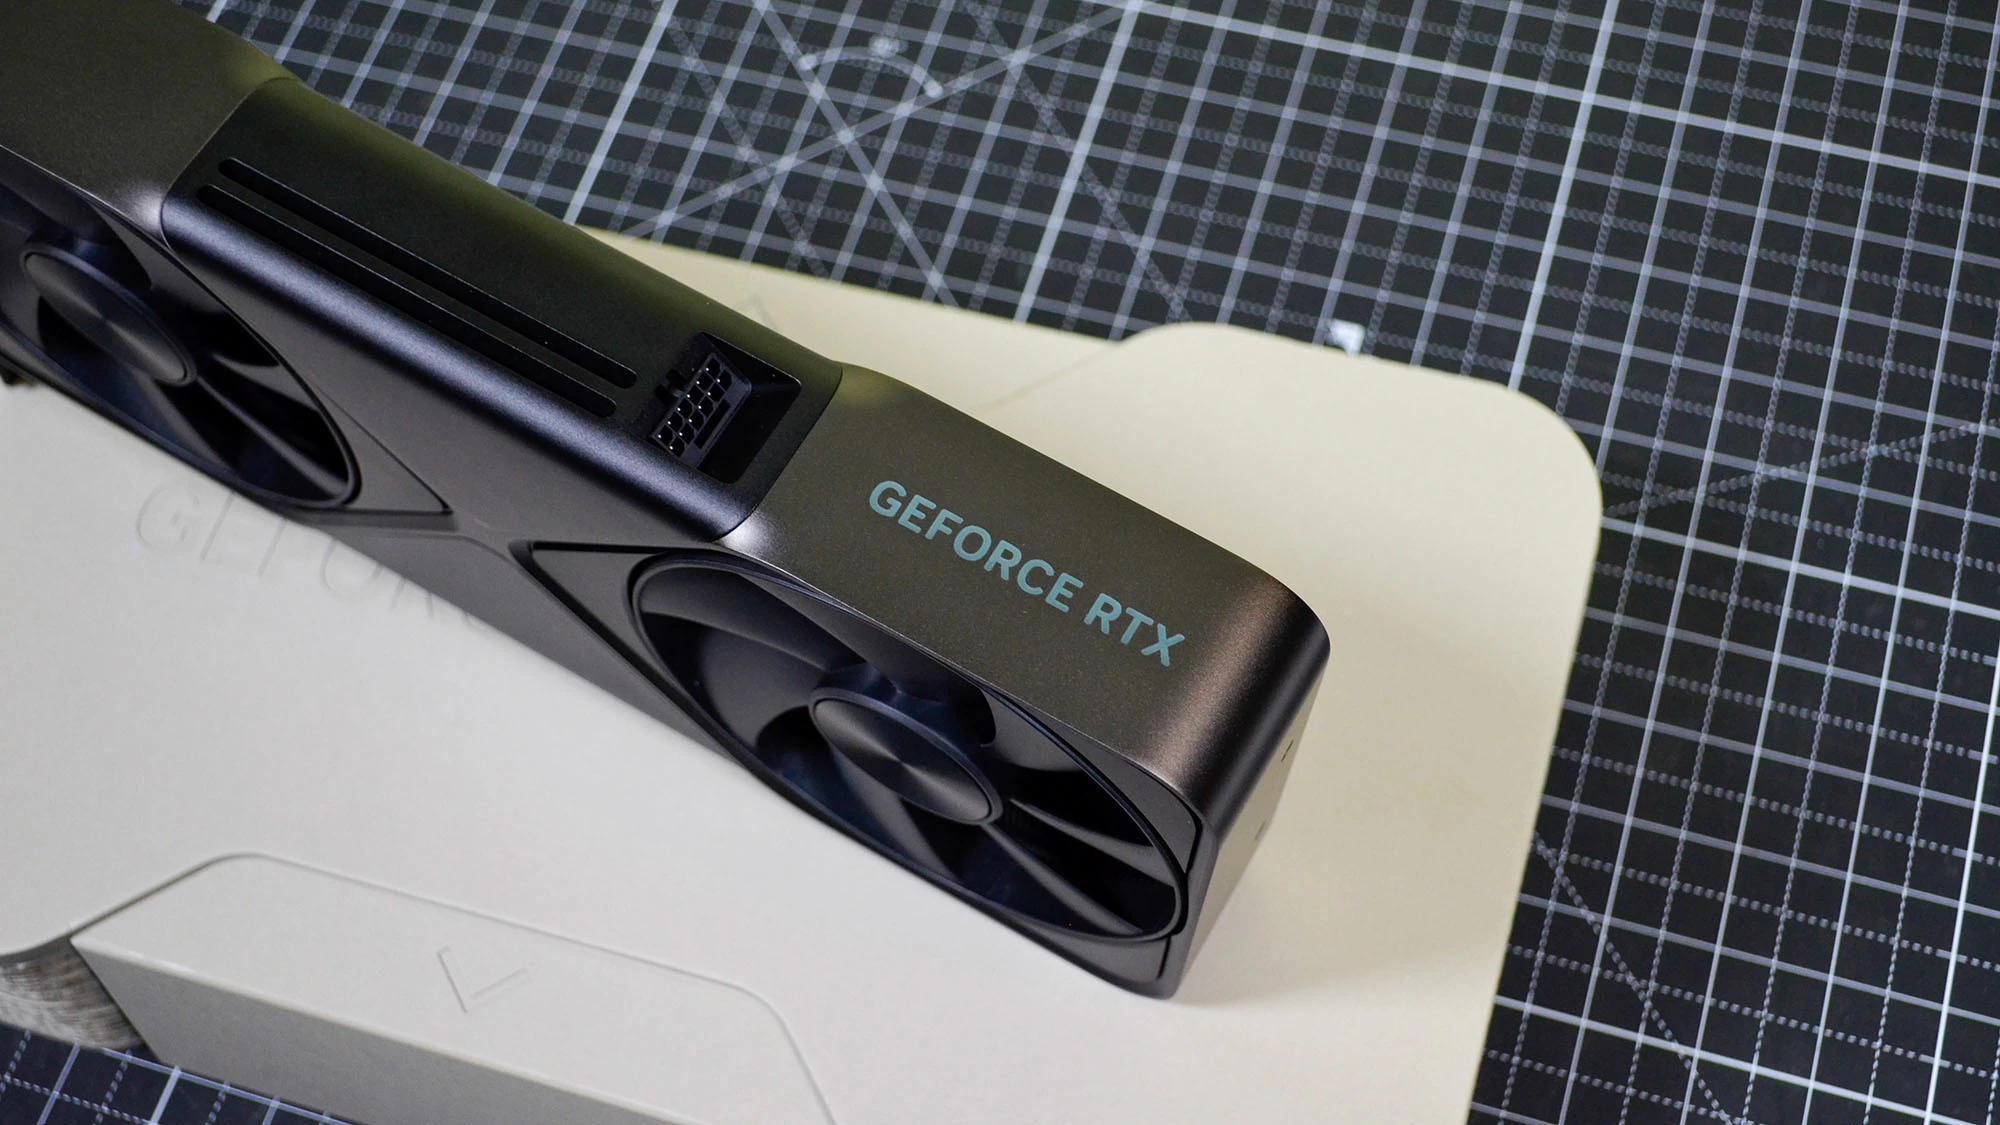
Langkah Nvidia mengubah GPU gaming GeForce RTX 5090 menjadi RTX Pro 5500 Blackwell Workstation Edition menandai pergeseran strategi: “GPU yang sama di dalam, tetapi jiwa yang berbeda di luar”. Produsen ini memakai “otak” yang sama, yaitu chip GB202 berbasis Blackwell, lalu menggesernya dari pasar enthusiast ke pasar GPU AI profesional dengan penyesuaian khusus untuk workload AI dan simulasi.
Kunci posisinya ada pada kombinasi 84GB VRAM GDDR7 dan 21.760 CUDA Core. Di atas kertas, angka ini menempatkan RTX Pro 5500 sebagai jembatan antara dunia consumer dan enterprise: performa mentah ala kartu gaming kelas atas, namun dengan kapasitas memori yang selama ini hanya kita temukan di kelas workstation dan data center.
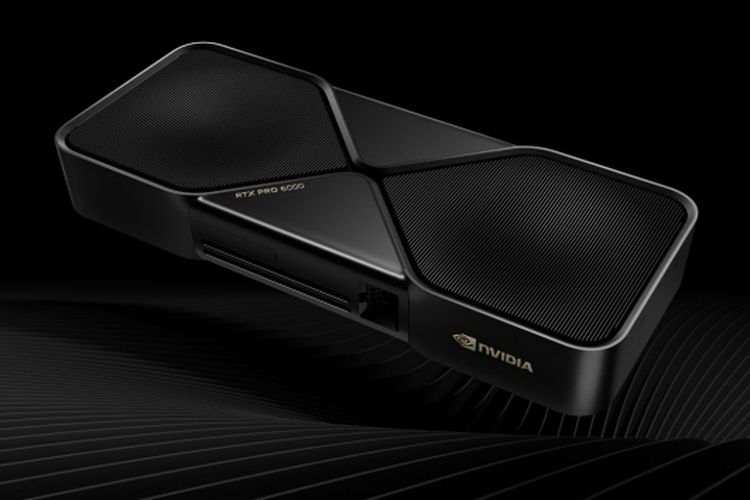
84GB VRAM GDDR7: Mengorbankan Bandwidth Demi Kapasitas
Keputusan paling berani di RTX Pro 5500 Blackwell adalah loncatan VRAM ke 84GB GDDR7, 2,6 kali lebih besar dibanding RTX 5090 yang hanya 32GB dengan tipe yang sama. Untuk mencapainya, Nvidia memakai 28 chip GDDR7 berkapasitas 3GB dalam konfigurasi clamshell, 14 chip di masing-masing sisi PCB.
Konsekuensinya, antarmuka memori “turun” ke 448-bit dengan kecepatan 25 Gbps dan bandwidth sekitar 1.398 GB/detik, sedangkan RTX 5090 mempertahankan bus 512-bit pada 28 Gbps dengan bandwidth sekitar 1.790 GB/detik. Artinya, RTX Pro 5500 mengorbankan puncak bandwidth demi kapasitas memori masif.
Untuk gaming, keputusan ini bisa diperdebatkan; bandwidth tinggi sering lebih menguntungkan. Namun untuk GPU AI profesional, cerita berbeda. Model AI besar dan dataset kompleks butuh ruang, bukan sekadar pipa memori yang lebar. Nvidia sendiri menekankan bahwa kapasitas memori yang jauh lebih besar dirancang untuk beban kerja yang membutuhkan VRAM besar, karena model AI berukuran besar memerlukan memori GPU tinggi untuk menampung parameter dan data selama komputasi.
21.760 CUDA Core: Tenaga Komputasi Kelas Enthusiast di Dunia Workstation
Di sisi komputasi, RTX Pro 5500 Blackwell tidak berkompromi. GPU ini memiliki 170 Streaming Multiprocessors dari total 192 SM pada chip GB202, yang menghasilkan 21.760 CUDA Core, identik dengan GeForce RTX 5090 sebagai kartu grafis kelas enthusiast.
Secara arsitektur, ini berarti fondasi performa komputasi untuk training dan inference AI profesional tetap sangat tinggi. Selain CUDA Core, GPU ini membawa 680 Tensor Core dan 176 Ray Tracing Core, seluruhnya dibangun di proses fabrikasi TSMC 4N. Kombinasi ini menjadikan RTX Pro 5500 cocok untuk agentic AI, physical simulation, rendering grafis, dan pekerjaan komputasi intensif lain yang selama ini mengandalkan farm GPU khusus.
Dari sisi daya, Total Board Power mencapai 600 watt, sedikit di atas RTX 5090 yang berada di 575 watt. Ini memperjelas bahwa RTX Pro 5500 adalah kartu “serius”. Bukan solusi hemat energi, tetapi mesin kerja yang menukar konsumsi listrik dengan throughput komputasi yang besar, sesuai ekspektasi di kelas workstation.
Dampak Praktis: Siapa yang Diuntungkan oleh 84GB VRAM?
Pertanyaan penting: siapa yang benar-benar membutuhkan 84GB VRAM GDDR7? Jawabannya bukan gamer, melainkan pengembang AI, studio grafis, dan tim simulasi yang selama ini terkunci oleh batas VRAM. Kapasitas sebesar ini memungkinkan model AI besar dan dataset kompleks dimuat langsung ke GPU tanpa harus dipecah atau di-offload ke CPU, sehingga mengurangi bottleneck memori dan overhead komunikasi.
Untuk agentic AI dan aplikasi dengan konteks panjang, lebih banyak data konteks dapat disimpan di VRAM, mengurangi kebutuhan pembagian batch. Dalam physical simulation, mesh dan parameter yang besar bisa tetap berada dekat dengan komputasi. Pada rendering, tekstur dan geometri beresolusi tinggi dapat dipertahankan tanpa trik kompresi agresif.
Perangkat ini dirancang untuk menangani beban kerja seperti agentic AI, physical simulation, rendering grafis, dan pekerjaan komputasi intensif lainnya. Kapasitas VRAM yang jauh lebih besar menjadi alasan kuat mengapa RTX Pro 5500 lebih relevan untuk model AI dan aplikasi profesional dengan kebutuhan memori tinggi, ketimbang memaksakan diri mengandalkan kartu consumer yang lebih sempit VRAM-nya.
Strategi Nvidia: Daur Ulang Chip Consumer Menjadi Produk Enterprise
Secara bisnis, RTX Pro 5500 Blackwell adalah contoh jelas strategi Nvidia mengoptimalkan chip consumer menjadi solusi enterprise. Mereka memakai chip GB202 yang sama dengan RTX 5090, termasuk konfigurasi 21.760 CUDA Core, lalu memposisikannya sebagai produk workstation. Dengan cara ini, biaya R&D ditekan karena desain silikon tidak perlu diulang, sementara time-to-market dipercepat.
Pendekatan ini masuk akal di tengah ledakan kebutuhan GPU untuk AI. Alih-alih membangun lini chip yang benar-benar terpisah, Nvidia bermain di sisi konfigurasi: mengubah layout memori, profil daya, dan sertifikasi software, lalu mengemasnya sebagai GPU AI profesional. Hasilnya adalah produk yang memadukan karakter consumer (performa tinggi, ekosistem CUDA luas) dengan kebutuhan enterprise (stabilitas, VRAM besar, driver workstation).
Di satu sisi, strategi ini memberi akses lebih cepat bagi pasar profesional terhadap arsitektur terbaru. Di sisi lain, ini memperkuat dominasi Nvidia karena ekosistem software pengembang AI tetap berputar di sekitar CUDA dan keluarga GPU yang mereka rilis berlapis—dari gaming hingga workstation dan data center—dengan “bahasa hardware” yang familiar.