
Argumen efisiensi di tengah pasokan ketat
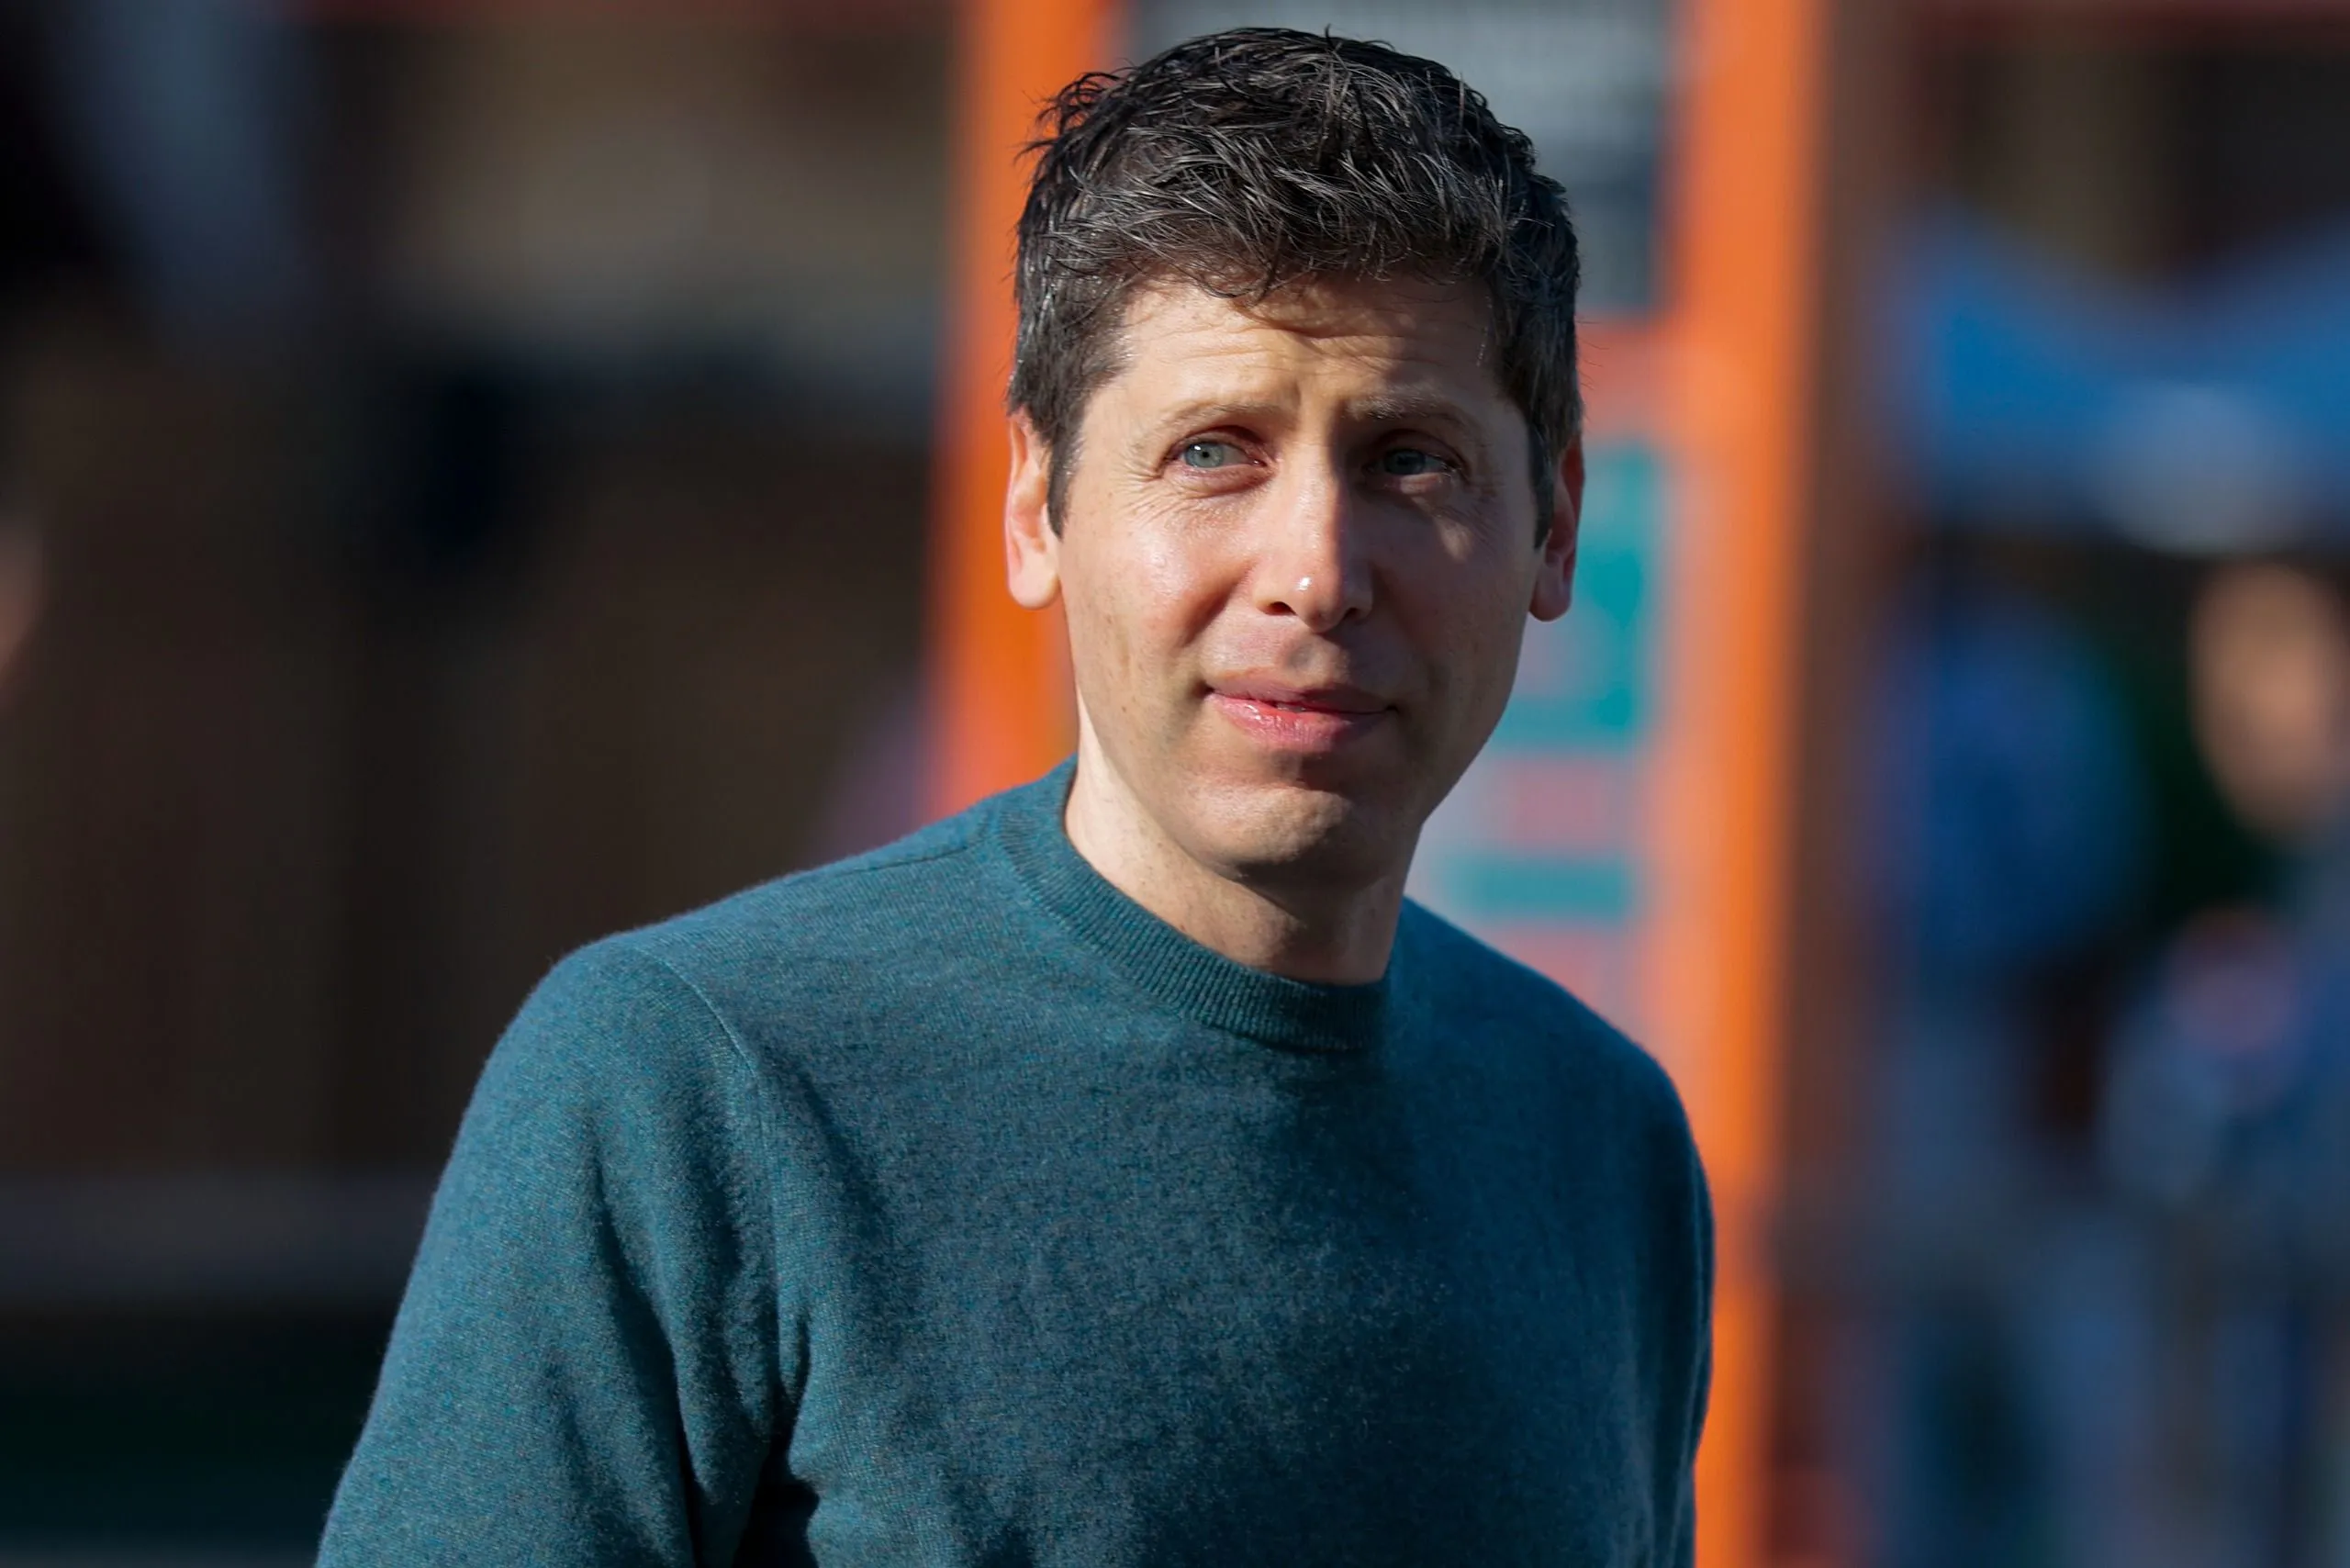
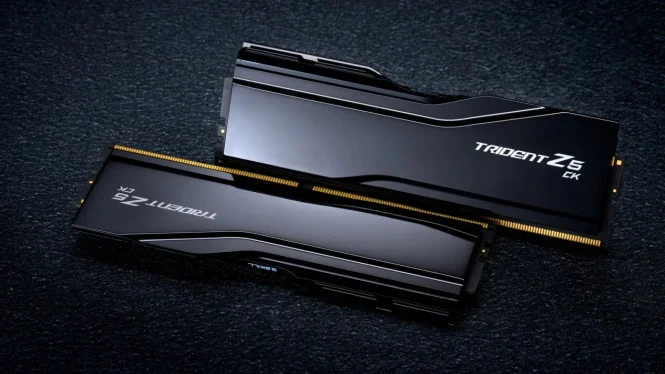
RAM komputer adalah memori kerja yang menyimpan data sementara agar perangkat dapat menjalankan aplikasi, dan Sam Altman berpendapat kapasitasnya lebih efisien jika dikumpulkan di server yang melayani banyak permintaan AI. Dalam wawancara dengan kanal YouTube Cheeky Pint, CEO OpenAI itu menyebut inferensi lokal dan kepemilikan DRAM di komputer rumahan sebagai pilihan yang “sangat buruk” dari sudut alokasi global.
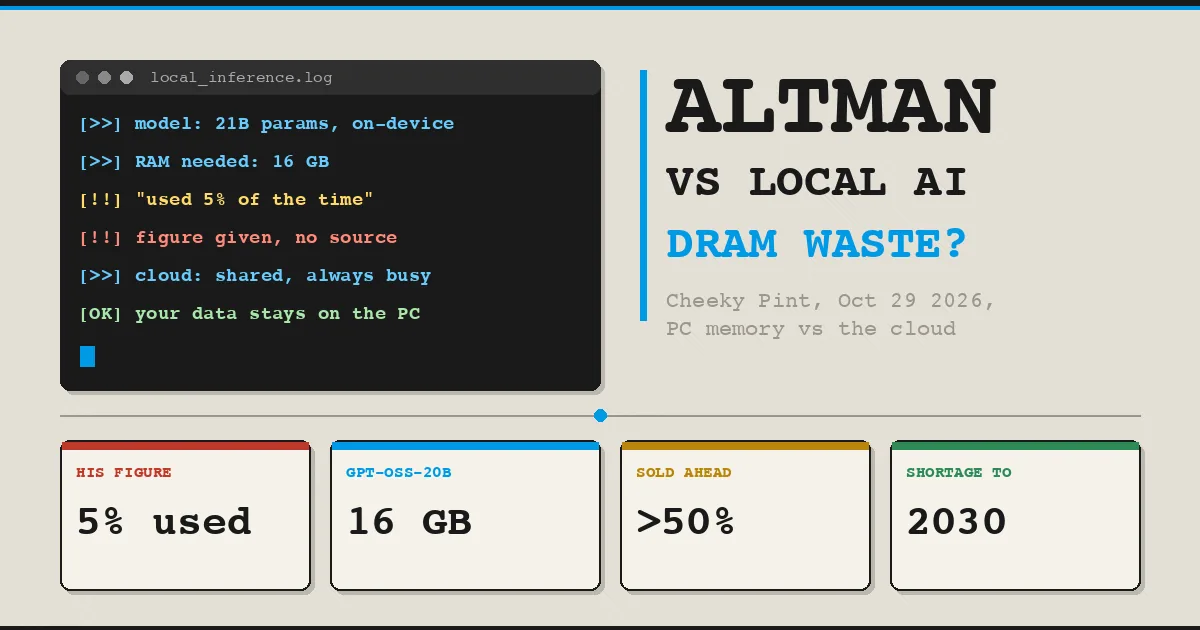
Alasan yang ia ajukan berangkat dari pasokan DRAM dunia yang terbatas ketika kebutuhan komputasi AI meningkat. Menurut Altman, pemilik PC hanya menggunakan RAM sekitar 5 persen dari waktu, sehingga kapasitas besar di jutaan perangkat bisa menganggur saat tidak sedang dibutuhkan. Ia ingin pemanfaatan RAM dimaksimalkan di cloud, tempat sumber daya dapat dipakai bergantian, bukan tersebar di komputer pribadi.
Logika ini masuk akal jika tujuan utama adalah melayani sebanyak mungkin permintaan dengan persediaan memori terbatas. Namun, menyebut memori pribadi sebagai pemborosan mengabaikan bahwa kapasitas itu dibeli untuk memenuhi kebutuhan pemiliknya, bukan untuk memaksimalkan statistik utilisasi industri.
Kapasitas terpusat punya keunggulan, sekaligus batas
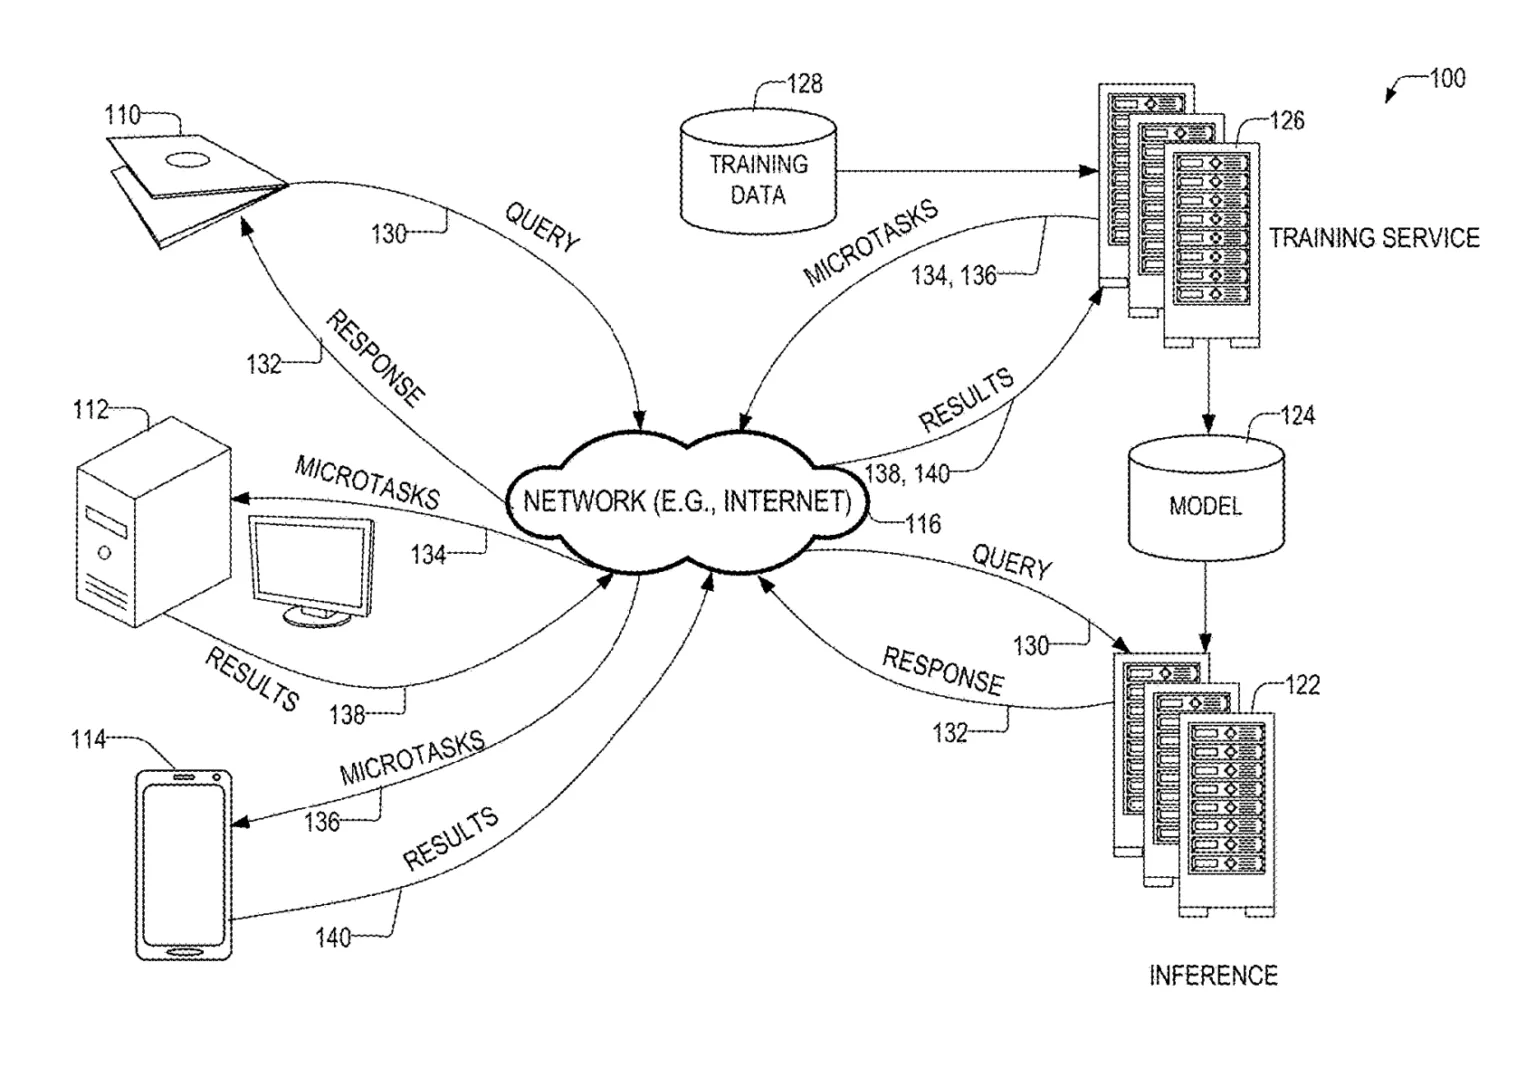
Memori data center dapat dipakai bergiliran oleh banyak pengguna, sementara server beroperasi sepanjang waktu. Data center, menurut argumen Altman, dapat melayani ribuan permintaan inferensi AI secara bergantian; komputer pribadi biasanya melayani satu orang dan tidak selalu bekerja pada kapasitas penuh. Dari sudut pandang efisiensi agregat, pemusatan memang tampak lebih hemat.
Namun, utilisasi tinggi bukan satu-satunya ukuran manfaat. Pengguna yang bergantung pada AI di pusat data memerlukan koneksi ke layanan jarak jauh dan harus menerima bahwa pemrosesan berlangsung di infrastruktur penyedia. Sebaliknya, RAM lokal juga menjalankan aplikasi sehari-hari—mulai dari peramban hingga gim—dan siap dipakai tanpa menunggu kapasitas server.
Altman benar bahwa server dapat membagi kapasitas dengan lebih luwes. Tetapi efisiensi bagi penyedia tidak otomatis berarti kendali atau kenyamanan yang lebih baik bagi setiap pengguna. Ketika memori dipusatkan, akses terhadapnya ikut bergantung pada layanan yang mengelola pusat data.
AI lokal memberi kendali yang tidak ditawarkan cloud
Tren inferensi lokal menunjukkan mengapa sebagian orang memilih menyimpan RAM besar di PC. Model open-weight seperti Llama, Mistral, dan DeepSeek dapat dijalankan di perangkat dengan bantuan GPU dan memori yang memadai. Pilihan ini menarik karena pengguna tidak memerlukan langganan bulanan dan dapat menjaga data tetap di perangkat mereka.
Menjalankan model sendiri juga dapat mengurangi ketergantungan pada layanan berlangganan, jika perangkat pengguna sanggup menangani beban tersebut. Bagi pengguna yang mengutamakan privasi, akses tanpa koneksi, atau kebebasan memilih perangkat lunak, RAM lokal bukan kapasitas sia-sia meski tidak terus-menerus penuh.
Sebaliknya, pemusatan membuat kemampuan AI bisa dibagikan tanpa setiap orang perlu menyediakan perangkat keras besar. Komprominya jelas: cloud mengutamakan skala dan utilisasi, sedangkan komputasi lokal mengutamakan kendali, privasi, dan kemandirian. Tidak ada satu pilihan yang paling efisien untuk semua kebutuhan.
Efisiensi industri bukan alasan menghapus pilihan
Pernyataan Altman layak dibaca sebagai argumen tentang alokasi sumber daya, bukan rumus universal tentang cara orang seharusnya memakai komputer. Ia menyoroti kapasitas DRAM yang terbatas dan peluang server untuk melayani banyak permintaan secara bergantian. Namun, sebagai CEO perusahaan yang menjalankan model di pusat data, ia juga membela pendekatan yang menjadi dasar layanan bisnis OpenAI.
Karena itu, angka 5 persen tidak cukup untuk menyimpulkan bahwa RAM PC tidak berguna. Rata-rata pemakaian yang rendah tidak menggambarkan nilai kapasitas yang tersedia saat dibutuhkan, seperti ketika pengguna menjalankan aplikasi berat atau model AI lokal. Mengukur efisiensi hanya dari seberapa sering memori terisi berisiko mengabaikan manfaat kesiapan dan kepemilikan.
Kesimpulannya, pemusatan memori dapat membantu memenuhi permintaan AI dengan lebih efisien, tetapi tidak seharusnya menjadi alasan untuk menyingkirkan komputasi lokal. Pilihan terbaik adalah ekosistem yang memberi ruang bagi AI di pusat data maupun model yang berjalan di perangkat. Efisiensi penting, tetapi kendali pengguna juga bernilai.