
Penyimpanan AI Enterprise adalah Fondasi Baru Infrastruktur Hyperscale
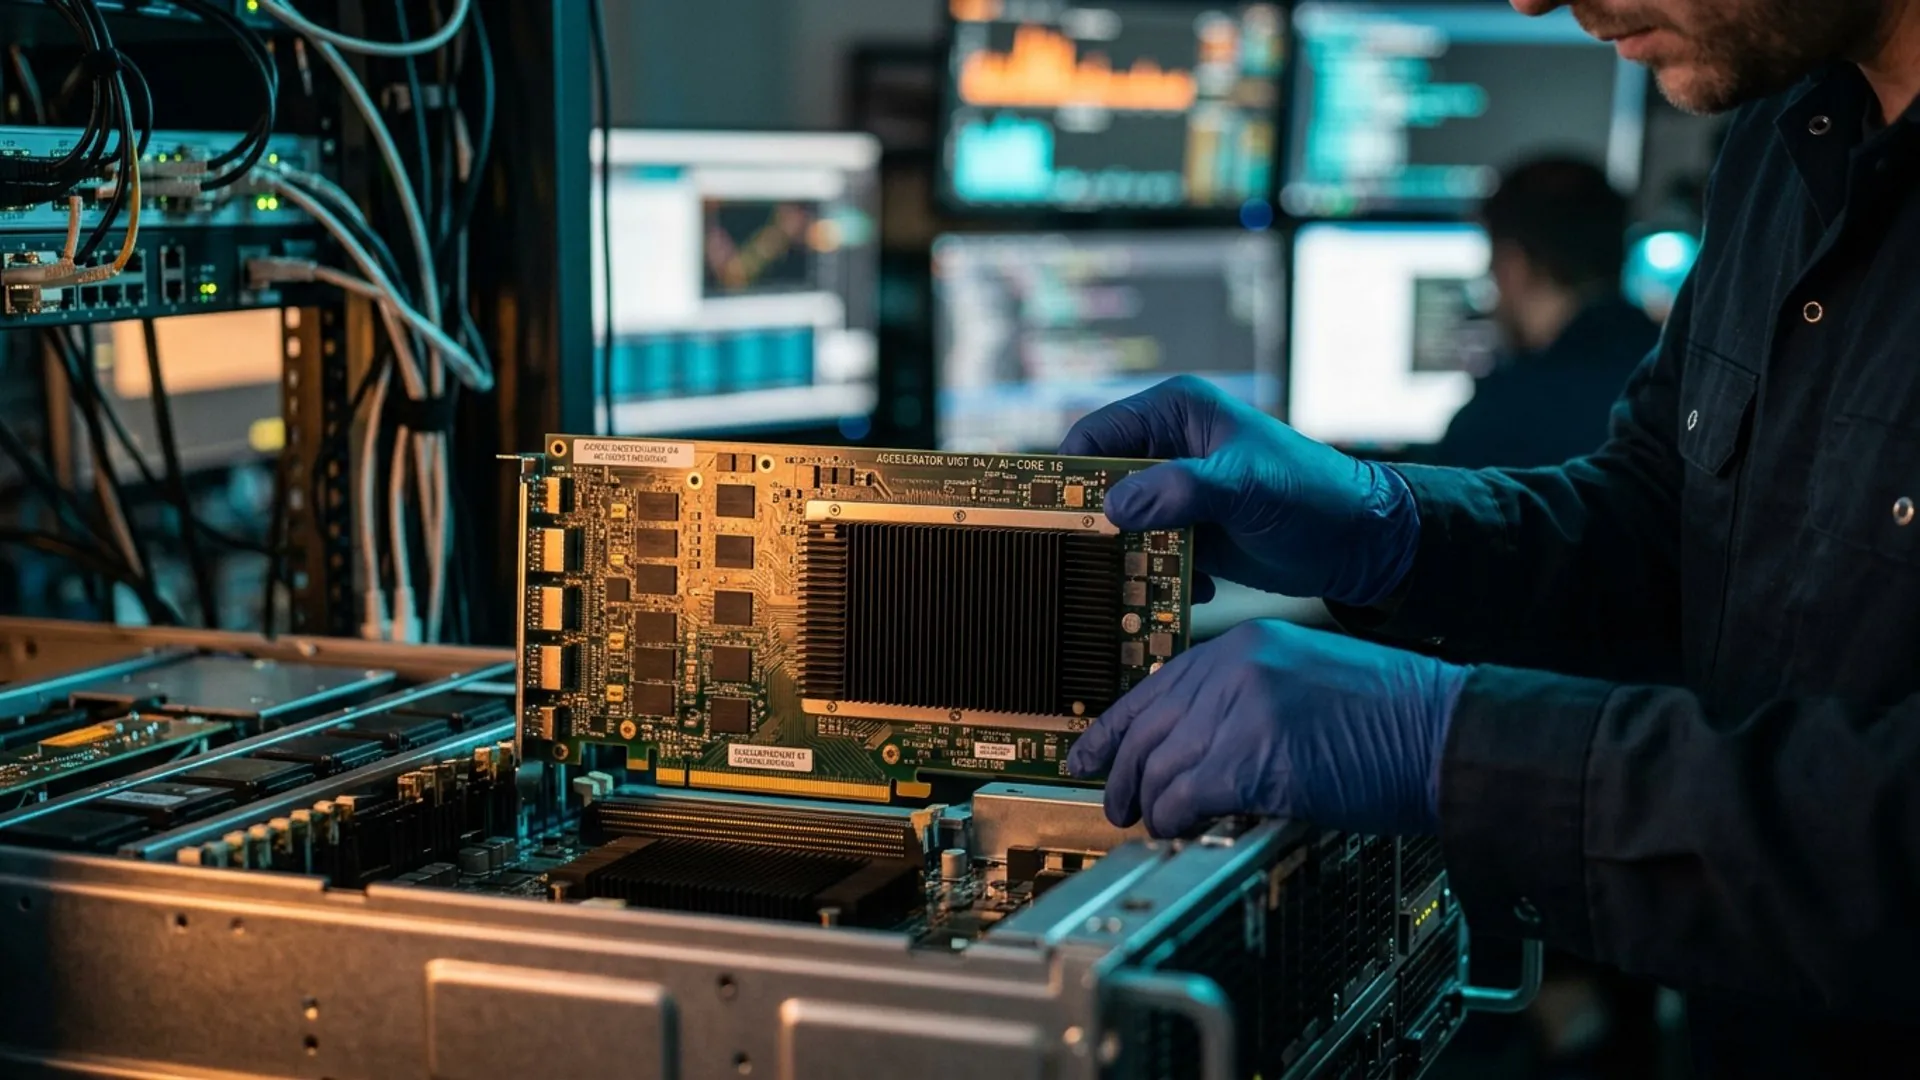
Penyimpanan AI enterprise adalah arsitektur storage berperforma tinggi yang dirancang khusus untuk memasok, menyimpan, dan mengoordinasikan data bagi model kecerdasan buatan skala besar, mengatasi keterbatasan memori on-chip dan DRAM melalui lapisan SSD dan sistem bertingkat dengan kapasitas hingga skala petabyte, latensi mikrodetik, serta integrasi erat dengan komputasi dan jaringan di pusat data hyperscale. Perspektif yang dominan beberapa tahun terakhir—bahwa GPU adalah bintang utama AI—mulai usang. Bottleneck nyata bukan lagi tfops di chip, melainkan kemampuan sistem untuk memindahkan dan mengingat konteks dalam jumlah masif tanpa tersandung latensi. Ketika inferensi agentic AI menuntut context window lebih dari satu juta token, pendekatan “tambah RAM, tambah GPU” tidak memadai. Jawaban yang layak bukan memaksa hardware komputasi bekerja lebih keras, melainkan memindahkan logika memori ke lapisan penyimpanan yang memang didesain untuk skala besar dan trafik acak.
OceanStor M900: Menjadikan KV Cache PB-Scale sebagai Senjata Inferensi
Langkah Huawei dengan OceanStor M900 Context Memory Storage harus dibaca sebagai pernyataan tegas: era inferensi AI hyperscale hanya mungkin jika context memory diperlakukan sebagai sumber daya bersama berskala PB, bukan fitur tambahan di DRAM server. Sistem ini membangun KV cache global berjenjang melalui jaringan UnifiedBus, sehingga satu klaster dapat menyediakan hingga 64 PB ruang memori bersama dan menaikkan kapasitas per NPU dari level gigabita ke terabita. Konsekuensinya jelas: model dengan 10 triliun parameter dan context window lebih dari satu juta token tidak lagi bergantung pada memori lokal yang sempit; mereka mendapat "otak eksternal" yang cukup luas untuk agentic AI yang bekerja mandiri. Di sini OceanStor M900 storage bukan sekadar perangkat; ia memaksa arsitek infrastruktur hyperscale menggabungkan komputasi, jaringan, dan penyimpanan ke dalam satu desain terpadu, demi menekan latensi dari milidetik menjadi sekitar 60 mikrodetik dan mendorong bandwidth agregat hingga 40 TB/detik.
VSP One Block NVMe: Menyatukan Mainframe, Sistem Terbuka, dan Beban AI
Sementara Huawei menyerang problem KV cache di dunia hyperscale, Hitachi VSP One Block High End menyerang problem klasik enterprise: silo antara mainframe, open systems, dan AI. Storage enterprise berbasis all-flash NVMe ini sengaja dirancang sebagai satu infrastruktur untuk mengelola beban kerja mainframe dan sistem terbuka, sekaligus menopang database, analitik real-time, dan kebutuhan data untuk kecerdasan buatan. Klaim kemampuan hingga 50 juta IOPS pada model VSP One Block 85 mengirim pesan yang tidak halus: bottleneck I/O tidak boleh lagi menjadi alasan downtime aplikasi transaksi atau lambatnya inferensi model di atas data operasional. Konfigurasi tertinggi dengan 12 controller dan 288 SSD NVMe 60 TB memberi kapasitas mentah 17,33 PB dan efektif hingga 18,68 PB, angka yang menempatkan VSP One sebagai tulang punggung penyimpanan AI enterprise yang serius. Penting dicatat, ini bukan komputer AI atau pengganti server GPU; fungsi utamanya adalah lapisan all-flash storage berkecepatan tinggi yang memberi makan data pada model AI, analitik, dan aplikasi perusahaan tanpa mengorbankan ketahanan beban kerja mission-critical.
Cisco AI POD untuk Splunk: Latensi Data On-Premises Bukan Lagi Penghalang
Di sisi lain, Cisco mengingatkan bahwa persoalan AI enterprise tidak hanya soal kapasitas dan IOPS, tetapi juga soal di mana data berada dan bagaimana analitik berjalan di lingkungan yang dikunci oleh kebijakan keamanan. Pada 15 September 2026, perusahaan ini mengumumkan Cisco AI POD untuk Splunk, yang membawa kemampuan AI Splunk yang dikelola sendiri ke lingkungan on‑premises, cloud privat, dan lingkungan terisolasi melalui kemitraan yang diperluas dengan NVIDIA. Konfigurasi AI POD menggabungkan perangkat lunak runtime AI baru dengan infrastruktur Cisco, komputasi yang dipercepat NVIDIA, dan arsitektur berbasis Kubernetes yang sudah pra‑divalidasi untuk beban kerja AI Splunk. Pesan tersiratnya jelas: analitik log dan keamanan yang kritis—seperti yang disediakan edisi baru Observability Cloud Essentials dan Premier—tidak boleh dikorbankan demi kenyamanan cloud publik ketika kedaulatan dan regulasi menuntut operasi on‑premises. Dengan Splunk AI Assistant yang sudah tersedia dan Agent Launchpad dijadwalkan untuk akhir 2026, serta rencana penambahan model terbuka NVIDIA Nemotron dalam beberapa bulan ke depan, ekosistem ini sedang membangun jalur penuh untuk agen AI yang hidup dekat dengan sumber data, bukan jauh di pusat data orang lain.
Mengapa Bottleneck Memori dan Latensi Akan Menentukan Pemenang AI Enterprise
Garis besar tren ini terang: pada 2026, AI bergeser dari sekadar terobosan teknologi menjadi implementasi skala besar, dan aplikasi bergeser dari chatbot ke agen AI yang menyelesaikan tugas kompleks secara mandiri. Dalam dunia seperti itu, organisasi yang masih menganggap storage sekadar gudang data akan tertinggal. Memori on‑chip dan DRAM yang semakin terbatas memaksa industri merancang sistem penyimpanan bertingkat untuk membentuk ruang memori bersama berkapasitas sangat besar. Di lapangan, perusahaan yang menjalankan layanan mission‑critical—sistem transaksi, aplikasi yang harus selalu tersedia—diberi pilihan: memodernisasi infrastruktur untuk memperkuat ketahanan operasional, atau mempertahankan arsitektur lama yang akan runtuh di bawah beban AI dan analitik real‑time. Sementara itu, di domain observabilitas dan keamanan, analitik log hemat biaya untuk debugging aplikasi dan infrastruktur menjadi bagian dari strategi menyeluruh untuk menjaga agen AI tetap terukur dan aman. Kesimpulannya tegas: pemenang AI enterprise bukan yang punya GPU paling banyak, melainkan yang berani mendesain ulang penyimpanan—dari PB‑scale context memory storage, all‑flash NVMe multi‑platform, sampai stack AI on‑premises—sebagai komponen inti, bukan afterthought.


