
Atlas 960E SuperPoD: Jawaban Huawei untuk AI 10 Triliun Parameter
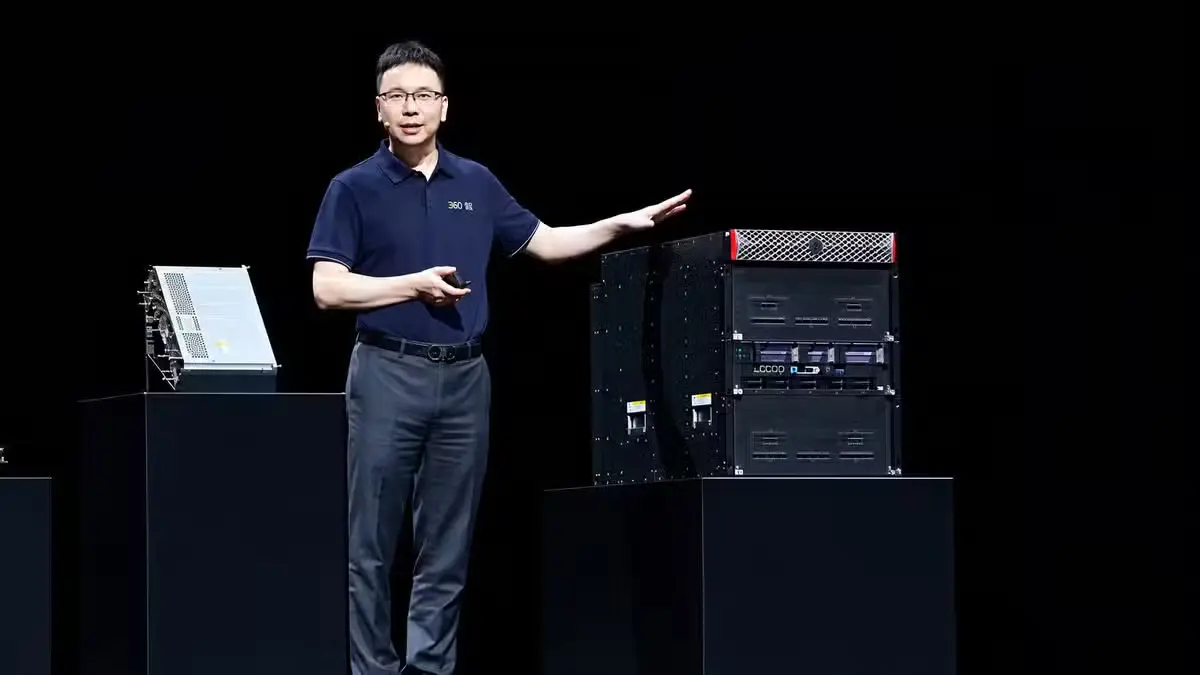
Atlas 960E SuperPoD adalah sistem komputasi AI berskala besar yang menggabungkan ribuan NPU akselerator AI dalam satu arsitektur terpadu berbasis UnifiedBus dan Near-Packaged Optics untuk mempercepat pelatihan serta inferensi model dengan hingga 10 triliun parameter sambil menekan konsumsi daya dan beban jaringan di pusat data hyperscale. Peluncuran Atlas 960E SuperPoD dan OceanStor M900 pada ajang HUAWEI CONNECT 2026 menegaskan bahwa pertarungan komputasi AI enterprise bukan lagi soal menambah jumlah chip, tetapi bagaimana menyatukan komputasi, jaringan, dan penyimpanan dalam satu desain infrastruktur data center AI yang efisien. Dalam konteks ini, langkah Huawei patut dibaca sebagai upaya agresif menggeser status quo yang selama ini didominasi pendekatan tradisional berbasis modul optik diskrit dan memori terbatas di level node.
Secara strategis, Huawei menempatkan Atlas 960E SuperPoD sebagai pondasi untuk era agentic AI, ketika aplikasi tidak lagi sekadar chatbot tetapi agen yang mampu menyelesaikan tugas kompleks secara mandiri dengan model berskala 10 triliun parameter dan context window lebih dari satu juta token. Ini bukan peningkatan bertahap, melainkan lompatan arsitektural: komputasi AI enterprise didorong menuju desain klaster yang mengasumsikan bahwa memori, jaringan, dan storage harus “berpikir” sebagai satu otak, bukan kumpulan komponen terpisah. Jika pendekatan ini berhasil, standar infrastruktur data center AI bisa bergeser dari sekadar memperbesar GPU/NPU ke arsitektur terpadu ala SuperPoD dan SuperCluster.
4.096 NPU dan UnifiedBus: Saat Skala Menjadi Fitur Utama
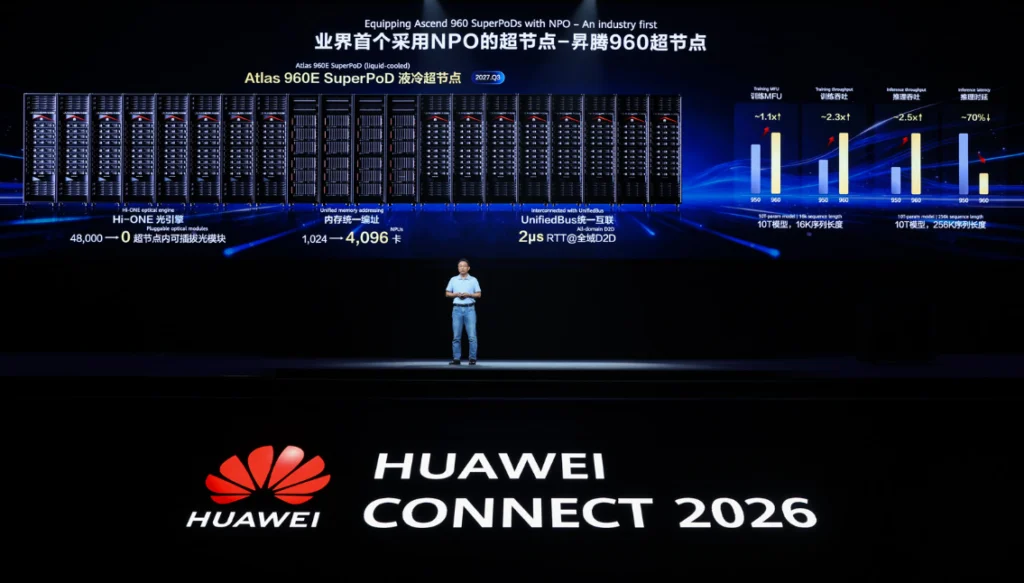
Jantung Atlas 960E SuperPoD adalah integrasi hingga 4.096 NPU Ascend 960 dalam satu sistem, dengan kemampuan komputasi 8 EFLOPS pada FP8 dan 16 EFLOPS pada FP4 per SuperPoD. Alih-alih membiarkan setiap server berjalan sebagai pulau terpisah, UnifiedBus menyediakan pengalamatan memori terpadu dan satu protokol jaringan, sehingga ribuan NPU dapat bertindak seperti satu akselerator raksasa dengan akses memori lintas server fisik. Dalam ekosistem komputasi AI enterprise, ini adalah pergeseran penting: manajemen beban kerja, komunikasi gradien saat training, hingga distribusi KV cache saat inferensi berpotensi lebih sederhana dan lebih deterministik dibanding desain heterogen campuran.
SuperPoD sebagai konsep bukan hal baru; ia adalah cara menyatukan banyak server dan chip AI agar berperilaku sebagai satu sistem untuk model sangat besar. Yang berbeda dari Atlas 960E adalah ambisinya di level skala: beberapa SuperPoD dapat digabung menjadi SuperCluster via UnifiedBus atau RoCE, dengan klaim skala hingga ratusan ribu hingga satu juta NPU dalam konfigurasi multi-rail. Di sini terlihat pandangan Huawei: masa depan infrastruktur data center AI bukan sekadar rak‑per‑rak, melainkan fabric komputasi kontinu yang bisa diperbesar hampir tanpa batas logis. Namun skala ini hanya bermakna jika jaringan dan memori tidak menjadi bottleneck—dan di sinilah NPO dan storage konteks masuk.
Near-Packaged Optics dan Hi-ONE: Menukar 48.000 Modul Optik dengan 5.500 Mesin
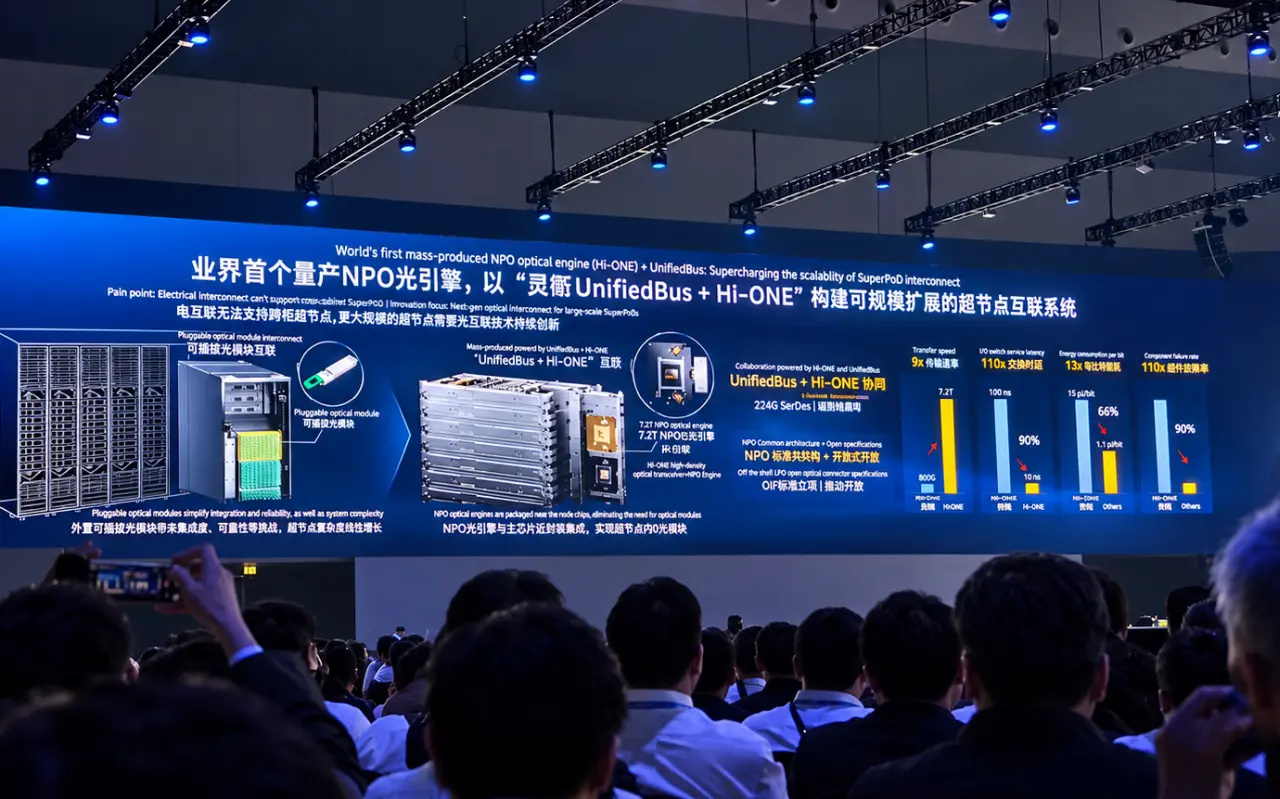
Near-Packaged Optics (NPO) adalah taruhan teknis paling berani dalam Atlas 960E SuperPoD. Dengan menempatkan komponen optik lebih dekat ke paket chip, NPO bertujuan menyediakan konektivitas berbandwidth tinggi dengan daya dan latensi lebih rendah dibanding modul optik tradisional yang jauh dari prosesor. Huawei mengimplementasikan ide ini melalui Hi-ONE, mesin interkoneksi optik berbasis NPO yang diklaim sebagai produk NPO pertama di industri yang siap diproduksi massal, dengan kapasitas transmisi 7,2 Tbit/s per unit dan sumber cahaya terintegrasi. Secara arsitektural, Hi-ONE menggabungkan desain optik, mekanik, elektrikal, elektromagnetik, dan termal dalam satu paket, menandakan bahwa interkoneksi kini diperlakukan sama seriusnya dengan chip itu sendiri.
Keputusan paling provokatif adalah mengganti sekitar 48.000 modul optik 800G dengan kira-kira 5.500 unit Hi-ONE dalam satu Atlas 960E SuperPoD. Huawei mengklaim, “Desain tersebut dapat memangkas konsumsi daya lebih dari 550 kilowatt, sekaligus mencapai ketersediaan sistem hingga 99,8 persen.” Jika angka ini konsisten di lapangan, dampaknya langsung ke biaya operasional infrastruktur AI hyperscale: daya yang biasanya termakan interkoneksi bisa dialihkan ke komputasi atau pendinginan. Bagi operator data center, NPO dalam bentuk Hi-ONE bukan sekadar fitur teknis, tetapi instrumen penghematan energi yang bisa mengubah perhitungan total cost of ownership untuk klaster AI berskala raksasa.
OceanStor M900: Memori Konteks PB-Scale untuk Agentic AI
Pertumbuhan model hingga skala 10 triliun parameter dan context window di atas satu juta token membuat volume KV cache membengkak, sementara memori on‑chip dan DRAM semakin kewalahan. Di titik ini, bottleneck komputasi AI enterprise bukan lagi sekadar FLOPS, tetapi ketersediaan memori konteks yang cukup dekat dengan NPU. OceanStor M900 Context Memory Storage dirancang sebagai jawaban: klaster penyimpanan memori konteks yang menyediakan ruang memori bersama bagi SuperPoD pada skala petabyte dan performa hingga terabit per detik, terhubung melalui UnifiedBus satu hop. Secara konsep, ini menggeser inferensi dari model besar ke arsitektur memori bertingkat, di mana KV cache global disusun sebagai lapisan tambahan antara DRAM dan SSD.
Satu klaster OceanStor M900 diklaim bisa menyediakan kapasitas hingga 64 PB, dengan kapasitas per NPU meningkat dari gigabita menjadi terabita, yang pada gilirannya meningkatkan rasio hit KV cache secara signifikan. Selain kapasitas, arsitektur yang mengintegrasikan CPU, network controller unit, dan NAND controller unit memungkinkan NPU SuperPoD terhubung langsung ke SSD tanpa konversi protokol, menurunkan latensi dari milidetik ke sekitar 60 mikrodetik dengan bandwidth agregat hingga 40 TB/detik. Artinya, OceanStor M900 bukan sekadar “storage cepat”, tetapi bagian inti arsitektur komputasi: tanpa memori konteks PB‑scale yang dekat dengan NPU, agentic AI dengan context window masif akan kembali tersendat di I/O, bukan di inti komputasinya.
Apa Arti Atlas 960E bagi Strategi Komputasi AI Enterprise
Atlas 960E SuperPoD dan OceanStor M900 menunjukkan sebuah tesis yang tegas: masa depan komputasi AI enterprise adalah infrastruktur data center AI yang didesain end-to-end, bukan sekadar menumpuk akselerator. Huawei menyatukan NPU akselerator AI, jaringan UnifiedBus, interkoneksi optik NPO, pendinginan cair, dan context memory storage PB‑scale dalam satu paket strategis. Di atas kertas, kombinasi ini menjawab tiga tekanan utama: skala model sampai 10 triliun parameter, meledaknya context window, dan biaya daya yang tidak lagi masuk akal untuk pendekatan modul optik tradisional.
Pertanyaannya bukan lagi apakah arsitektur seperti ini diperlukan, tetapi siapa yang sanggup membangunnya dengan disiplin teknis dan ekosistem software yang cukup matang. Dengan komitmen pada pendekatan sistem dan, menurut David Wang, fokus pada infrastruktur AI yang kuat serta ekosistem terbuka, Huawei jelas ingin memosisikan diri sebagai penentu arah, bukan pengikut. Namun keberhasilan Atlas 960E SuperPoD akan ditentukan oleh dua hal yang belum terlihat di panggung peluncuran: bagaimana performanya di workload dunia nyata yang beragam, dan seberapa cepat pasar siap mengadopsi paradigma komputasi AI enterprise yang memindahkan kompleksitas dari aplikasi ke arsitektur pusat data.