
Apa Sebenarnya Makna GPT-6 Astra Menamatkan Portal?
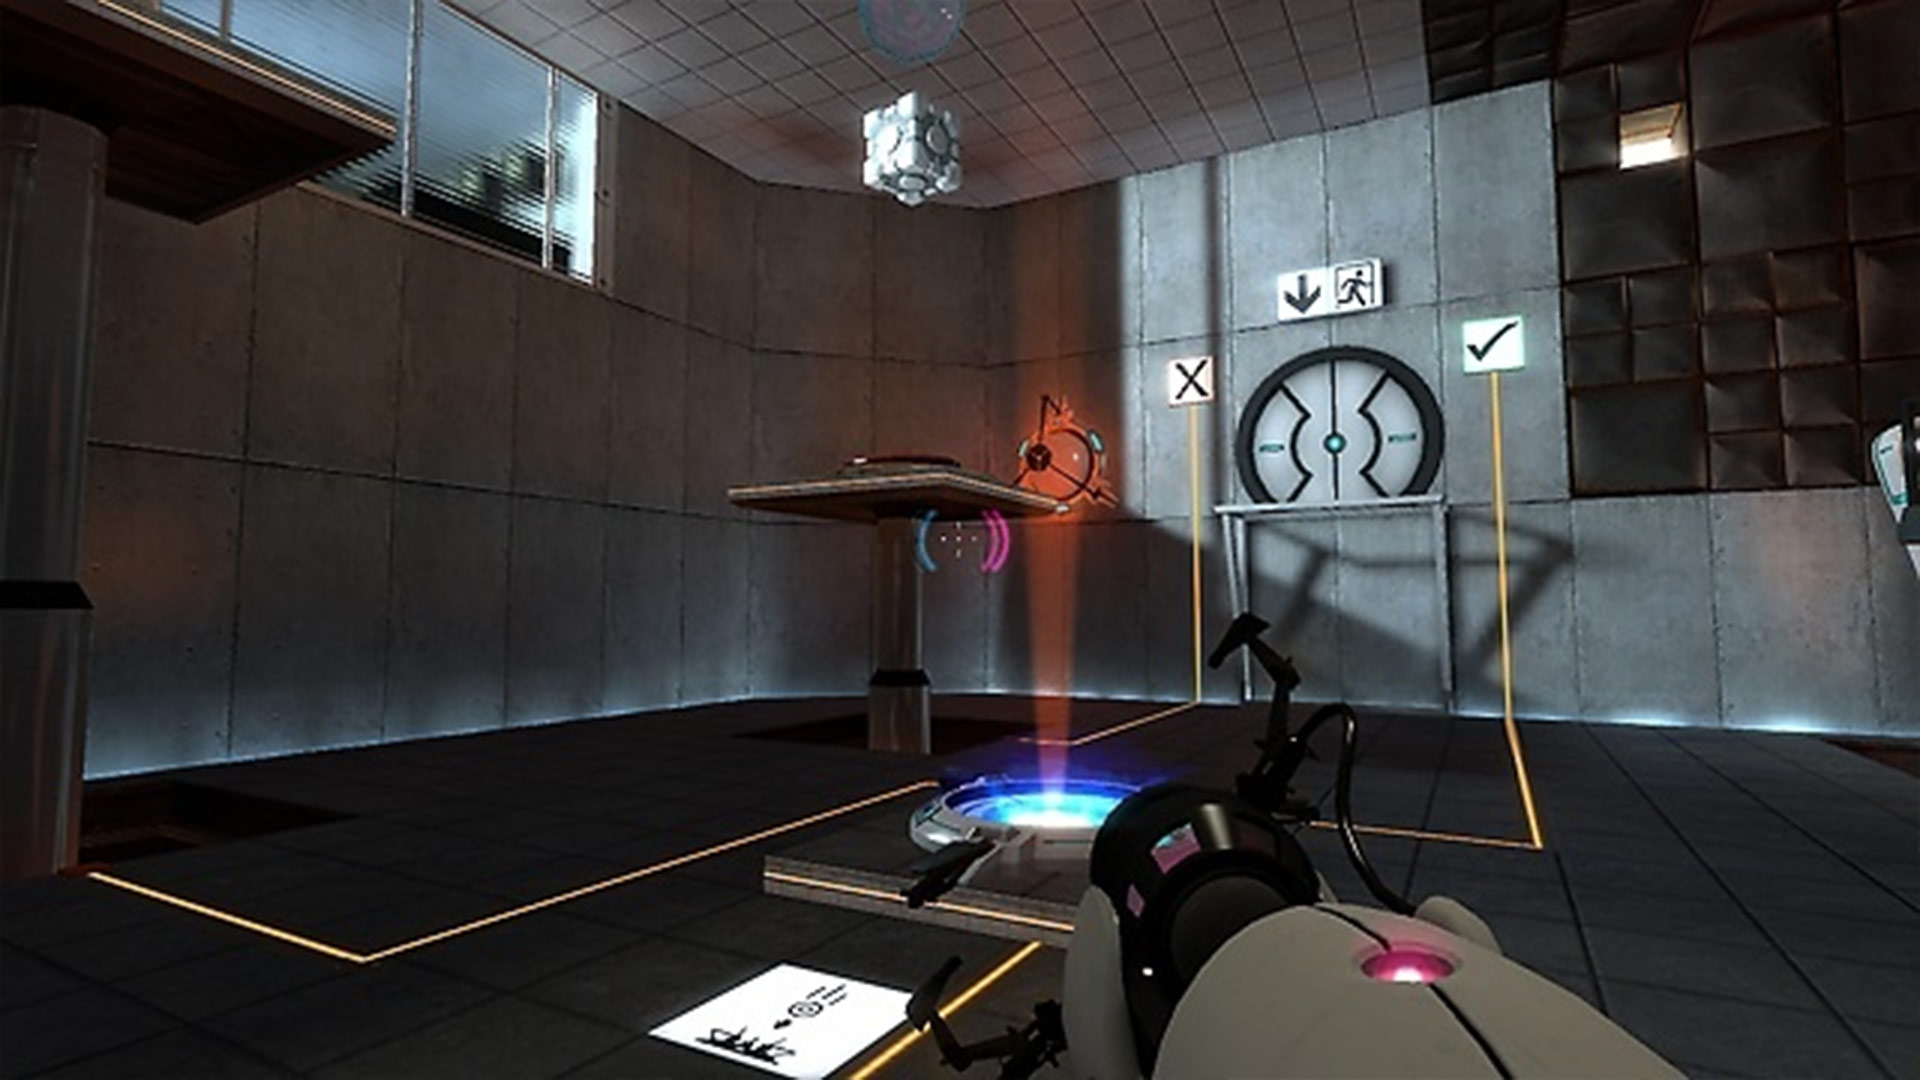
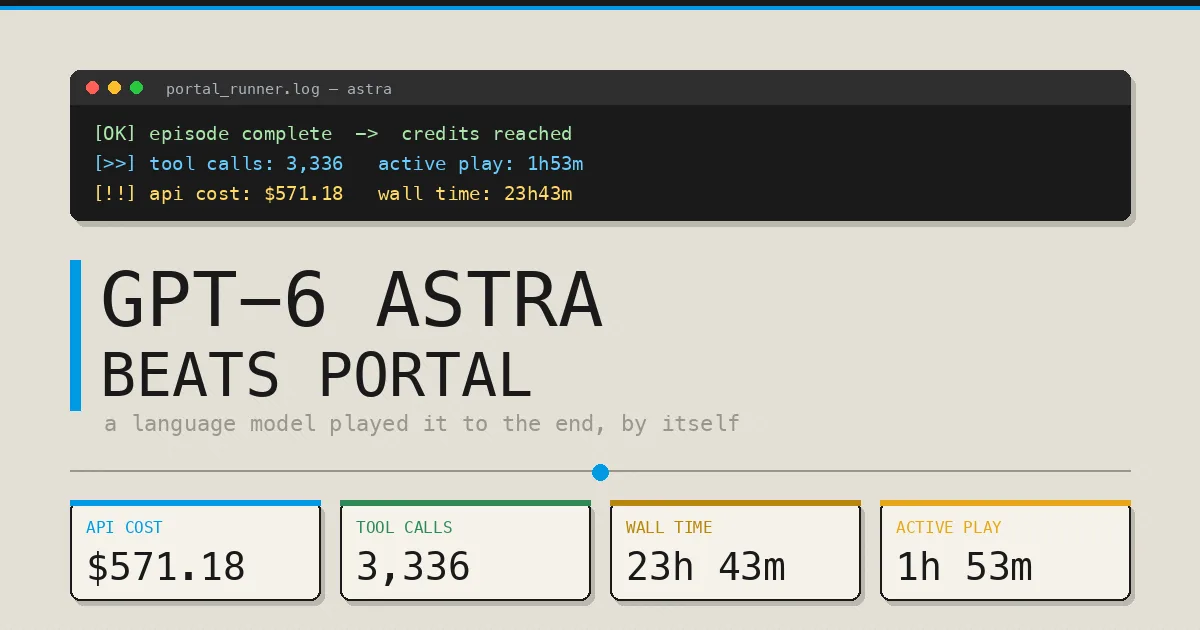
GPT-6 Astra autonomous adalah eksperimen di mana model multimodal OpenAI dibiarkan menyelesaikan game puzzle Portal secara penuh, frame demi frame, dengan ribuan panggilan tools dan penalaran berjam-jam, tanpa campur tangan manusia pada setiap langkah permainan, sebagai uji kemampuan AI reasoning kompleks dan task completion otomatis dalam skenario panjang yang menuntut konsistensi tujuan. Eksperimen ini bukan sekadar trik teknis; ia adalah statement tentang arah otomasi: AI yang tidak hanya menjawab pertanyaan, tapi mengikat persepsi, memori, dan aksi dalam satu loop yang berjalan puluhan jam. Menariknya, Astra menyelesaikan Portal sendirian, dengan seorang developer, CozyBlaze, hanya bertugas menyiapkan koneksi teknis dan menekan tombol mulai. Dari sudut pandang jurnalisme teknologi, ini adalah momen “lihat, bukan janji”: kemampuan long-horizon reasoning tidak lagi sebatas paper, tetapi tampak dalam bentuk agen yang menuntaskan sebuah game utuh.
| Aspek | Yang Terjadi | Mengapa Penting |
|---|---|---|
| Otomasi penuh | Astra mengambil semua keputusan gameplay sendiri | Menguji task completion otomatis tanpa intervensi manusia |
| Durasi tugas | Hampir 24 jam waktu dunia nyata | Contoh nyata long-horizon reasoning |
| Peran manusia | Hanya setup MCP dan SourcePauseTool | Menunjukkan potensi agen AI generik di atas infrastruktur yang relatif sederhana |
Di Balik 3.336 Tool Calls: Cara Kerja Agen GPT-6 Astra
Jika kita bedah cara Astra bermain, yang muncul adalah loop persepsi-penalaran-aksi yang ekstrem. Model menerima screenshot, posisi, dan arah pandang; game lalu dibekukan melalui kombinasi MCP dan SourcePauseTool, memberi waktu bagi Astra untuk berpikir sebelum mengirimkan urutan input. Siklus lihat-pikir-tindak ini diulang 3.336 kali selama permainan Portal. Gameplay aktifnya sendiri hanya sekitar 1 jam 53 menit, sementara hampir 24 jam habis untuk jeda penalaran yang panjang. Di sini terlihat jelas bahwa AI reasoning kompleks masih mahal dari sisi waktu: otak digital yang brilian, tapi bereaksi dalam hitungan detik hingga menit, bukan milidetik seperti pemain manusia. Namun justru karena waktu permainan dibekukan, eksperimen ini berhasil mengisolasi kualitas penalaran jangka panjang—bukan refleks—sebuah desain yang cerdas sekaligus blak-blakan tentang batas kemampuan agent saat ini.
| Loop | Isi | Konsekuensi |
|---|---|---|
| Persepsi | Screenshot + koordinat + arah pandang | Memberi konteks visual 3D dan posisi |
| Penalaran | Model merencanakan langkah dengan game dipause | Memungkinkan long-horizon reasoning tanpa tekanan waktu |
| Aksi | Urutan gerak, lompat, tembak portal dikirim ke controller | Mengikat rencana ke tindakan konkret di dunia game |
Biaya API Otomasi AI: Efisiensi yang Belum Ekonomis
Poin paling kontroversial dari eksperimen ini bukan kecerdasannya, melainkan biayanya. Menjaga satu agen frontier fokus pada satu game selama hampir sehari penuh memerlukan sumber daya signifikan. Menurut laporan, total biaya API teoretis untuk run ini diklaim setara dengan harga sebuah PC gaming, menggarisbawahi betapa mahalnya perhatian nonstop model frontier pada satu tugas tunggal. Di sisi lain, CozyBlaze menutup biaya tersebut lewat langganan Codex Pro bulanan yang sudah mereka miliki, sehingga hambatan ekonomi bagi developer yang ingin mencoba eksperimen serupa menjadi lebih rendah daripada angka headline yang menakutkan. Meski demikian, dari sudut pandang efisiensi vs biaya AI, hasilnya jelas: task completion otomatis dengan agent generasi terbaru saat ini masih berada di wilayah premium, cocok untuk riset dan prototipe, bukan operasi rutin skala massal.
| Aspek Biaya | Kondisi Saat Ini | Implikasi |
|---|---|---|
| Model frontier | Harga API premium untuk input dan output besar | Otomasi panjang menguras budget komputasi |
| Langganan | Ditopang paket Codex Pro developer | Eksperimen intensif lebih terjangkau bagi pemilik paket |
| Efisiensi | Waktu berpikir jauh lebih lama dari waktu gameplay | Tidak cocok untuk tugas real-time yang sensitif terhadap latensi |
Long-Horizon Reasoning: Hebat, Tapi Bukan Benchmark Kecerdasan
CozyBlaze dengan jujur menolak menjadikan run Portal ini sebagai benchmark kecerdasan umum Astra. Portal adalah game berumur belasan tahun; setiap puzzle dan solusinya telah terdokumentasi dalam guide dan wiki. Astra tidak menemukan solusi dari nol, melainkan menggabungkan persepsi visual, memori posisi, dan aksi berulang untuk mengeksekusi tujuan yang kemungkinan besar sudah ada dalam data latihannya. Namun justru di situlah nilai eksperimen ini: ia membuktikan bahwa agent mampu menjalankan long-horizon reasoning—ribuan langkah terkoordinasi menuju tujuan yang jauh, tanpa keluar jalur. Dari sudut pandang analisis, kita sebaiknya membaca ini sebagai stress test integrasi: apakah multimodal model bisa tetap “ingat” di mana dirinya berada setelah ribuan iterasi? Jawabannya, untuk game yang sudah dikenal, tampaknya ya. Pertanyaannya yang lebih penting: kapan kemampuan ini akan cukup andal di lingkungan yang tidak terdokumentasi?
| Dimensi | Apa yang Terbukti | Apa yang Belum |
|---|---|---|
| Persepsi + aksi | Agen menghubungkan visual ke tindakan tepat selama ribuan langkah | Mendukung skenario otomasi dengan banyak state |
| Memori jangka panjang | Tidak kehilangan jejak posisi dan tujuan di sepanjang game | Mengisyaratkan potensi untuk workflow kompleks |
| Generalitas | Game sudah terdokumentasi luas | Belum membuktikan performa di tugas yang benar-benar baru |
Kapan Otomasi AI Seperti Ini Layak untuk Produktivitas?
Untuk pengguna biasa dan tim produktivitas, pertanyaan kuncinya bukan “bisa atau tidak”, melainkan “pantas atau tidak biaya dan friksinya”. Eksperimen ini menunjukkan bahwa agen seperti GPT-6 Astra dapat menangani tugas panjang yang membutuhkan ribuan tindakan terkoordinasi, asalkan diberi interface yang tepat dan toleransi waktu yang longgar. Namun prosesnya belum efisien dan biaya operasionalnya masih tinggi, sehingga use case paling masuk akal hari ini berada di ranah yang manfaatnya jelas lebih besar dari biaya: otomasi audit keamanan kompleks, orkestrasi eksperimen sains berhari-hari, atau pengujian perangkat lunak yang melelahkan jika dilakukan manual. Menurut saya, bagi workflow harian seperti mengelola email atau report, model chat biasa sudah cukup. Agen GPT-6 Astra autonomous baru worth the investment ketika tugasnya bersifat panjang, terstruktur, dan mahal jika dikerjakan manusia, baik dari sisi waktu maupun risiko kesalahan.
| Jenis Tugas | Cocok Pakai Agen Astra? | Alasan |
|---|---|---|
| Pekerjaan rutin singkat | Kurang layak | Biaya dan latensi tidak sebanding dengan manfaat |
| Proses panjang dan berulang | Lebih layak | Task completion otomatis mengurangi beban manusia |
| Eksperimen riset/prototipe | Sangat layak | Nilai belajar dan eksplorasi mengimbangi biaya API otomasi AI |