
Server AI Enterprise: Eksekusi Agen, Bukan Sekadar Menjalankan Model
Server AI enterprise adalah infrastruktur processor AI yang dirancang bukan hanya untuk menjalankan model, tetapi untuk menangani seluruh siklus kerja agen AI—mulai dari eksekusi kode, orkestrasi alat, pemrosesan data, hingga integrasi dengan sistem perusahaan—dengan fokus pada skalabilitas, efisiensi energi, dan kemampuan menyesuaikan konfigurasi CPU-GPU dengan karakteristik beban kerja yang terus berubah di pusat data modern. ASUS XA P2N-E2 dan AMD Helion sama‑sama lahir dari kebutuhan ini, namun menawarkan filosofi desain yang berbeda. ASUS memilih pendekatan server 2U berbasis NVIDIA Vera architecture yang sangat terfokus pada lapisan eksekusi agen, sementara AMD Helion platform dibangun sebagai agentic AI infrastructure berskala rak yang fleksibel untuk berbagai skenario enterprise dan hyperscale. Bagi pengambil keputusan IT, perbedaan arah ini jauh lebih penting daripada sekadar angka spesifikasi.
ASUS XA P2N-E2: CPU NVIDIA Vera sebagai Mesin Eksekusi Agen
ASUS XA P2N-E2 adalah server AI enterprise 2U berbasis arsitektur NVIDIA MGX yang ditenagai dua CPU NVIDIA Vera. Ini bukan sekadar server umum yang diberi label AI: desainnya jelas memposisikan CPU sebagai pusat eksekusi agen, sementara GPU hanya menangani pelatihan dan inferensi model. Setiap prosesor Vera mengintegrasikan 88 inti Olympus dengan Spatial Multithreading untuk total 176 utas dan TDP hingga 480 W per soket. ASUS menggambarkan Vera sebagai CPU pertama yang dirancang khusus untuk agen AI, dengan fokus pada kinerja utas tunggal, bandwidth memori tinggi, dan isolasi sandbox tingkat perangkat keras untuk eksekusi kode agen. Kutipan yang layak dicatat: "CPU Vera mampu memberikan kinerja utas tunggal hingga 1,8 kali CPU x86 tradisional" dan mempercepat alur kerja pemrograman hingga 1,5 kali.
Dari sisi memori, XA P2N-E2 menggunakan 16 modul SOCAMM2 LPDDR5X pada 9600 MT/dtk dengan kapasitas hingga 1,5 TB, yang diklaim memberi efisiensi energi dua kali lipat dibanding RDIMM tradisional dan mengurangi konsumsi daya memori 50%. Bandwidth memori hingga sekitar 1,2 TB/dtk dan interkoneksi internal 3,4 TB/dtk ditujukan untuk menjaga agen AI tetap responsif saat menjalankan tugas eksekusi dan evaluasi yang berat. Penyimpanan delapan drive E1.S hot-swap, dua slot PCIe Gen6 x16, dan satu slot DPU/NIC dua slot memberi ruang ekspansi yang cukup untuk aplikasi enterprise. Menariknya, seluruh sasis berpendingin udara dengan catu daya redundan 2+2 2000 W bersertifikasi 80 PLUS Titanium, sehingga tidak memerlukan infrastruktur pendingin cair. Ini menunjukkan ambisi ASUS: menghadirkan infrastruktur processor AI yang kuat untuk agentic AI tanpa memaksa pusat data beralih ke ekosistem pendinginan yang lebih kompleks.
AMD Helion: Infrastruktur Agentic AI Berskala Rak yang Fleksibel
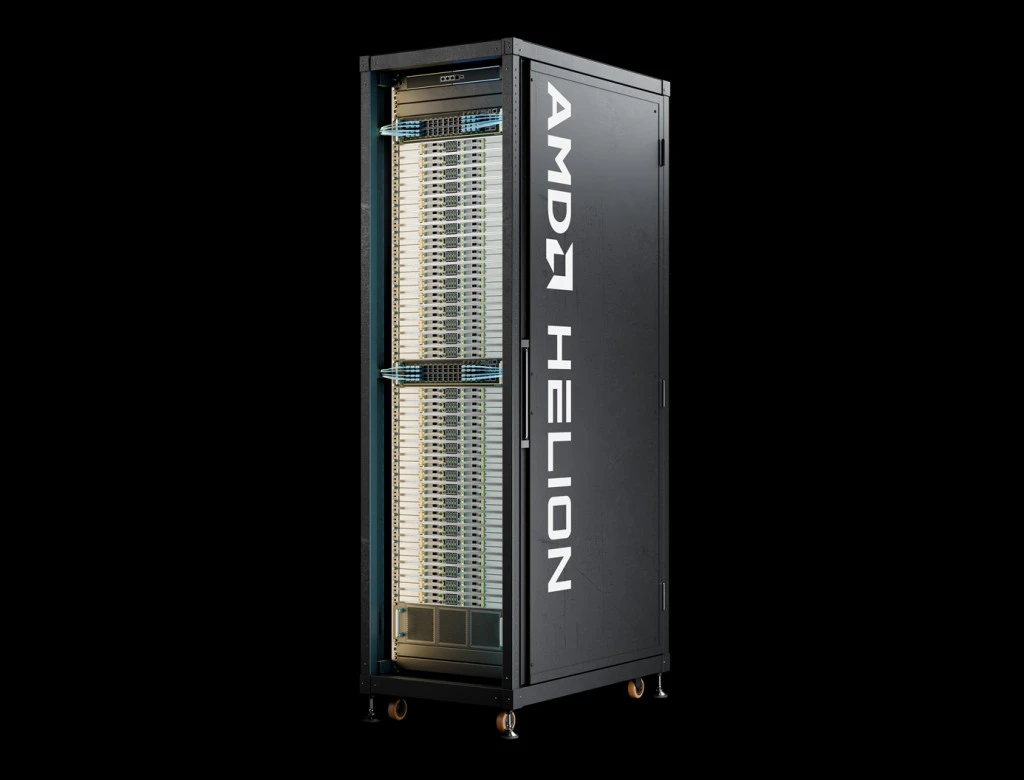
Berbeda dari pendekatan ASUS yang berpusat pada satu server, AMD Helion platform dirancang sebagai agentic AI infrastructure berskala rak untuk pusat data dan lingkungan perusahaan. Helion menempatkan fleksibilitas sebagai nilai utama: konfigurasi CPU dan GPU dapat disesuaikan dengan tugas agen AI, dari eksekusi kode hingga alur kerja kompleks. Salah satu konfigurasi menggunakan prosesor AMD EPYC generasi keenam dan dapat mendukung hingga 32.768 core CPU dalam satu rak. Angka ini jelas menyasar penyedia layanan hyperscale yang membutuhkan kapasitas besar untuk menjalankan agen AI dan menghubungkannya dengan infrastruktur inferensi model terpisah.
Pilihan konfigurasi lainnya menggabungkan node CPU AMD EPYC, GPU AMD Instinct MI350P, dan komputasi serbaguna dalam satu platform, ditujukan bagi perusahaan yang membutuhkan infrastruktur agentic AI terpadu. AMD menekankan bahwa beban kerja agen tidak selalu harus ditangani dengan konfigurasi GPU yang sama: pekerjaan yang didominasi eksekusi agen memerlukan kapasitas CPU besar, sementara tugas tertentu tetap membutuhkan akselerasi GPU. Helion dibangun di atas spesifikasi Open Compute Project dengan pendekatan perangkat keras dan perangkat lunak terbuka, dan AMD berencana menyumbangkan spesifikasinya ke OCP. Token router terintegrasi mengarahkan permintaan model dari agen ke berbagai model AI, termasuk frontier dan open-source. Ini memperlihatkan strategi AMD: menjadikan Helion sebagai tulang punggung server AI enterprise yang dapat tumbuh bersama ekosistem model dan infrastruktur TI yang sudah ada.
Perbandingan Arsitektur: Server 2U Terfokus vs Rak Fleksibel
Jika dilihat dari arsitektur, ASUS XA P2N-E2 dan AMD Helion mewakili dua cara berpikir tentang infrastruktur processor AI untuk enterprise. XA P2N-E2 adalah server 2U berbasis NVIDIA Vera architecture dalam desain MGX modular, dengan dua CPU Vera dan dukungan hingga dua GPU RTX PRO 6000 Blackwell Server Edition dua slot dalam satu sasis berpendingin udara. Pendekatan ini cocok untuk organisasi yang ingin menempatkan lapisan eksekusi agen dekat dengan aplikasi, tanpa harus mengubah seluruh rak atau arsitektur pusat data. Fokusnya jelas: kinerja utas tunggal, bandwidth memori tinggi, dan isolasi sandbox perangkat keras untuk eksekusi kode agen.
Sebaliknya, AMD Helion memulai dari skala rak. Dengan opsi rak khusus CPU yang dapat mencapai 32.768 core dan konfigurasi terpadu CPU-GPU-"komputasi serbaguna" dalam satu platform, Helion menargetkan organisasi yang melihat agentic AI sebagai beban kerja pusat data kelas hyperscale maupun enterprise besar. Pendekatan arsitektur terbuka berbasis OCP dan dukungan pendinginan udara maupun cairan memberi kebebasan desain yang luas. Di sini, token router terintegrasi menjadi komponen kunci: ia menghubungkan agen dengan berbagai model AI tanpa mengunci pelanggan pada satu vendor model. Secara praktis, XA P2N-E2 terasa seperti mesin eksekusi agen yang siap masuk ke rak yang sudah ada, sedangkan Helion adalah blueprint rak penuh untuk pusat data yang ingin membangun agentic AI sebagai layanan inti.
Implikasi bagi Pengambil Keputusan IT: Memilih Sesuai Pola Beban Kerja
Bagi pengambil keputusan IT, pertanyaan penting bukan "mana yang lebih kuat", tetapi "mana yang lebih selaras dengan pola beban kerja dan strategi pusat data". Jika organisasi Anda melihat agentic AI sebagai lapisan eksekusi yang harus dekat dengan aplikasi bisnis, dengan kebutuhan sandbox perangkat keras, kinerja utas tunggal tinggi, dan integrasi GPU yang cukup untuk pelatihan dan inferensi, ASUS XA P2N-E2 menawarkan paket yang terfokus dan relatif mudah diadopsi ke rak yang sudah ada. Server AI enterprise seperti ini cocok untuk tim yang ingin mengoptimalkan eksekusi agen tanpa merombak arsitektur pusat data secara menyeluruh.
Sebaliknya, jika perusahaan memandang agentic AI sebagai beban kerja skala besar yang akan hidup di rak khusus, terhubung ke infrastruktur inferensi model terpisah, dan membutuhkan kemampuan menyesuaikan kepadatan core, performa, serta konsumsi daya per rak, AMD Helion lebih masuk akal. Fleksibilitas konfigurasi CPU-GPU, arsitektur terbuka OCP, dan token router terintegrasi menjadikannya fondasi yang menarik untuk membangun layanan agentic AI terpadu di pusat data. Kesimpulannya, kedua platform sama‑sama kuat dan efisien untuk workload AI skala enterprise; pilihan terbaik bergantung pada apakah Anda ingin memperkuat satu server eksekusi agen, atau mendesain ulang seluruh rak sebagai infrastruktur agentic AI.