
LLM Pintar Bicara, Bukan Penjaga Kebenaran
Large Language Model (LLM) adalah sistem kecerdasan buatan yang dilatih dengan teks dalam jumlah sangat besar untuk memprediksi kata berikutnya dalam sebuah kalimat, sehingga mampu menghasilkan jawaban yang terdengar fasih, rapi, dan masuk akal, tetapi tidak dirancang untuk mengetahui atau memeriksa kebenaran fakta seperti manusia sehingga tetap berisiko mengarang informasi yang salah. LLM seperti ChatGPT dan Claude terasa seperti teman superpintar: bisa merangkum rapat, menulis email, menjelaskan konsep kuliah, bahkan membantu menyusun kode program. Namun di sinilah jebakannya. Karena jawaban terdengar meyakinkan, banyak orang tergoda menganggapnya sebagai sumber kebenaran absolut. Padahal, LLM hanya mengolah pola bahasa, bukan melakukan verifikasi informasi AI yang ketat. Kalau kita tidak waspada, LLM hallucination bahaya bisa mengarahkan keputusan salah, merusak tugas akademik, bahkan memicu masalah hukum.
Halusinasi dan Fakta Karangan: Bahaya yang Paling Halus
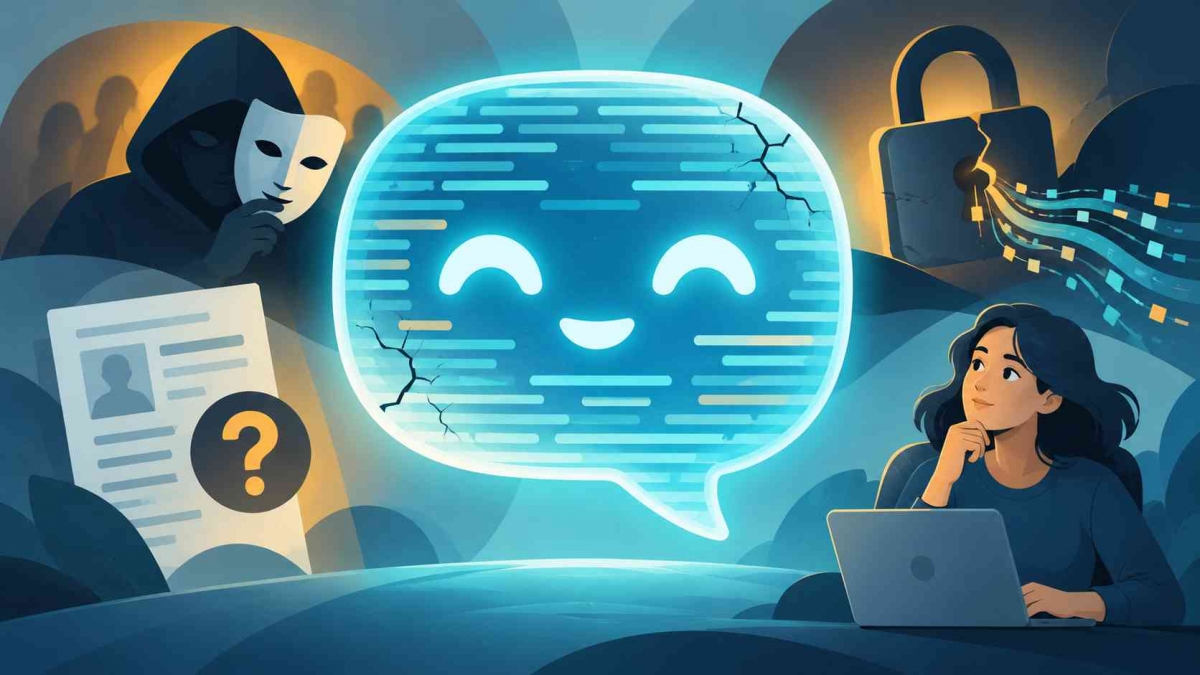
Halusinasi pada LLM adalah jawaban AI yang terdengar meyakinkan tetapi keliru atau sepenuhnya karangan. LLM tidak "mengetahui" kebenaran seperti manusia memeriksa fakta; ia menghasilkan teks yang masuk akal secara bahasa, sering kali benar, tetapi tidak selalu. Dalam perkara Mata v. Avianca, pengacara mengutip putusan pengadilan yang ternyata tidak pernah ada, hasil riset dengan ChatGPT, dan berujung sanksi dari hakim. Ini contoh nyata bagaimana LLM hallucination bahaya ketika pengguna menelan mentah-mentah jawaban tanpa verifikasi informasi AI. Penelitian menunjukkan model dilatih untuk lebih memilih menebak daripada berkata "tidak tahu", sehingga tetap cenderung mengarang meski versi terbaru diklaim lebih jarang berhalusinasi. Bahaya yang paling halus datang dari diri kita sendiri: karena jawabannya cepat dan rapi, kita tergoda menerima begitu saja tanpa cek silang ke sumber lain.
Keamanan Data ChatGPT: Jangan Menyiram Rahasia ke Server Orang
Setiap kata yang kamu ketik ke chatbot dikirim ke server penyedia layanan. Di sinilah keamanan data ChatGPT dan layanan sejenis jadi isu serius. Pada 2023, karyawan divisi semikonduktor Samsung dilaporkan menempelkan bahan rahasia ke ChatGPT: kode sumber bermasalah, kode untuk dioptimalkan, dan rekaman rapat untuk dibuatkan notulen. Perusahaan lalu melarang penggunaan AI generatif di perangkat dan jaringan internal, mengingatkan bahwa data yang sudah diunggah sulit ditarik kembali dan dihapus. Jika kamu memasukkan data pelanggan, pasien, atau siswa ke chatbot publik tanpa dasar yang jelas, kamu bukan hanya ceroboh, tapi berpotensi melanggar aturan pelindungan data pribadi. Penggunaan AI bertanggung jawab berarti sadar bahwa layar chat bukan brankas, melainkan saluran keluar data. Prinsipnya sederhana: kalau kamu tidak nyaman melihatnya bocor, jangan pernah menuliskannya ke chatbot.
Penipuan Berwajah AI: Konten Meyakinkan, Niat Jahat
Teknologi AI generatif, termasuk suara dan video, sudah dipakai penjahat sebagai senjata baru. Dalam sebuah kasus, staf keuangan mengikuti panggilan video dengan orang-orang yang tampak seperti direktur keuangan dan rekan kerja, lalu mentransfer dana besar; menurut polisi, semua peserta selain korban adalah deepfake. LLM berperan di sisi teks: membuat surel penipuan atau pesan dengan tata bahasa rapi dan meyakinkan, sehingga tanda klasik seperti salah ketik makin sulit dijadikan patokan. Penipuan memanfaatkan kemampuan AI untuk membuat konten yang meyakinkan, dari email palsu yang tampak profesional sampai dokumen yang terlihat resmi. Bahaya ini menargetkan hampir semua orang yang memakai chatbot untuk pekerjaan sehari-hari. Kalau kita tidak mengembangkan kebiasaan verifikasi informasi AI, kita mudah tertipu bukan karena bodoh, tapi karena penipu kini dibantu mesin yang fasih merangkai kata.
Strategi Aman: Jadikan AI Asisten, Bukan Hakim Kebenaran
LLM bisa jadi tutor pribadi yang menjelaskan konsep dengan banyak cara, memberi umpan balik cepat, dan mendukung pelajar yang butuh bantuan ekstra. Namun manfaat ini baru terwujud kalau penggunanya berpikir kritis, bijak, dan paham keterbatasan AI. Dengan kata lain, kalau AI dipakai sebagai "mesin jawaban", kita mungkin menyelesaikan tugas dengan cepat tapi tidak benar-benar belajar. Strategi aman itu jelas: gunakan AI sebagai asisten, bukan sebagai sumber kebenaran absolut. Selalu lakukan verifikasi informasi AI dengan cross-check ke buku, jurnal, regulasi, atau situs resmi; jangan andalkan AI sebagai satu-satunya sumber. Hakim dalam kasus halusinasi putusan pengadilan menegaskan, "memakai AI tidak otomatis salah; yang salah adalah tidak memeriksa ulang hasilnya". Penggunaan AI bertanggung jawab berarti menjadikan chatbot seperti teman diskusi: boleh memberi ide, tapi keputusan akhir tetap di tangan kamu.