
Qwen 3.8 27B dan Pertanyaan Besar soal GPU untuk AI Lokal
Perbandingan performa Qwen 3.8 27B di RTX 5090 dan RTX 4090 adalah upaya mengukur seberapa jauh GPU consumer-grade bisa menggantikan layanan AI berbayar, dengan melihat time-to-first-token, kecepatan decode, dan dukungan konteks panjang dalam skenario penggunaan nyata AI lokal, bukan sekadar angka benchmark sintetis di kertas.
Qwen 3.8 27B adalah model AI open-weight dari Alibaba dengan bobot sekitar 17GB dalam kuantisasi empat-bit yang disebut mampu mendekati performa model frontier. Tidak heran pemilik GPU kelas atas ramai mengincarnya sebagai otak utama sistem AI lokal mereka, dari RTX 5090, RTX 4090, RTX 3090, sampai Radeon RX 7900 XTX. Namun pengujian menyeluruh menunjukkan kenyataan yang kurang nyaman: performa aktual Qwen 3.8 27B sangat bergantung pada kombinasi hardware dan software, bukan sekadar besar VRAM. Di sini, istilah seperti “RTX 5090 performa AI” atau “GPU untuk AI lokal” harus dibaca dengan sikap curiga—spesifikasi di brosur tidak otomatis berbanding lurus dengan pengalaman nyata.
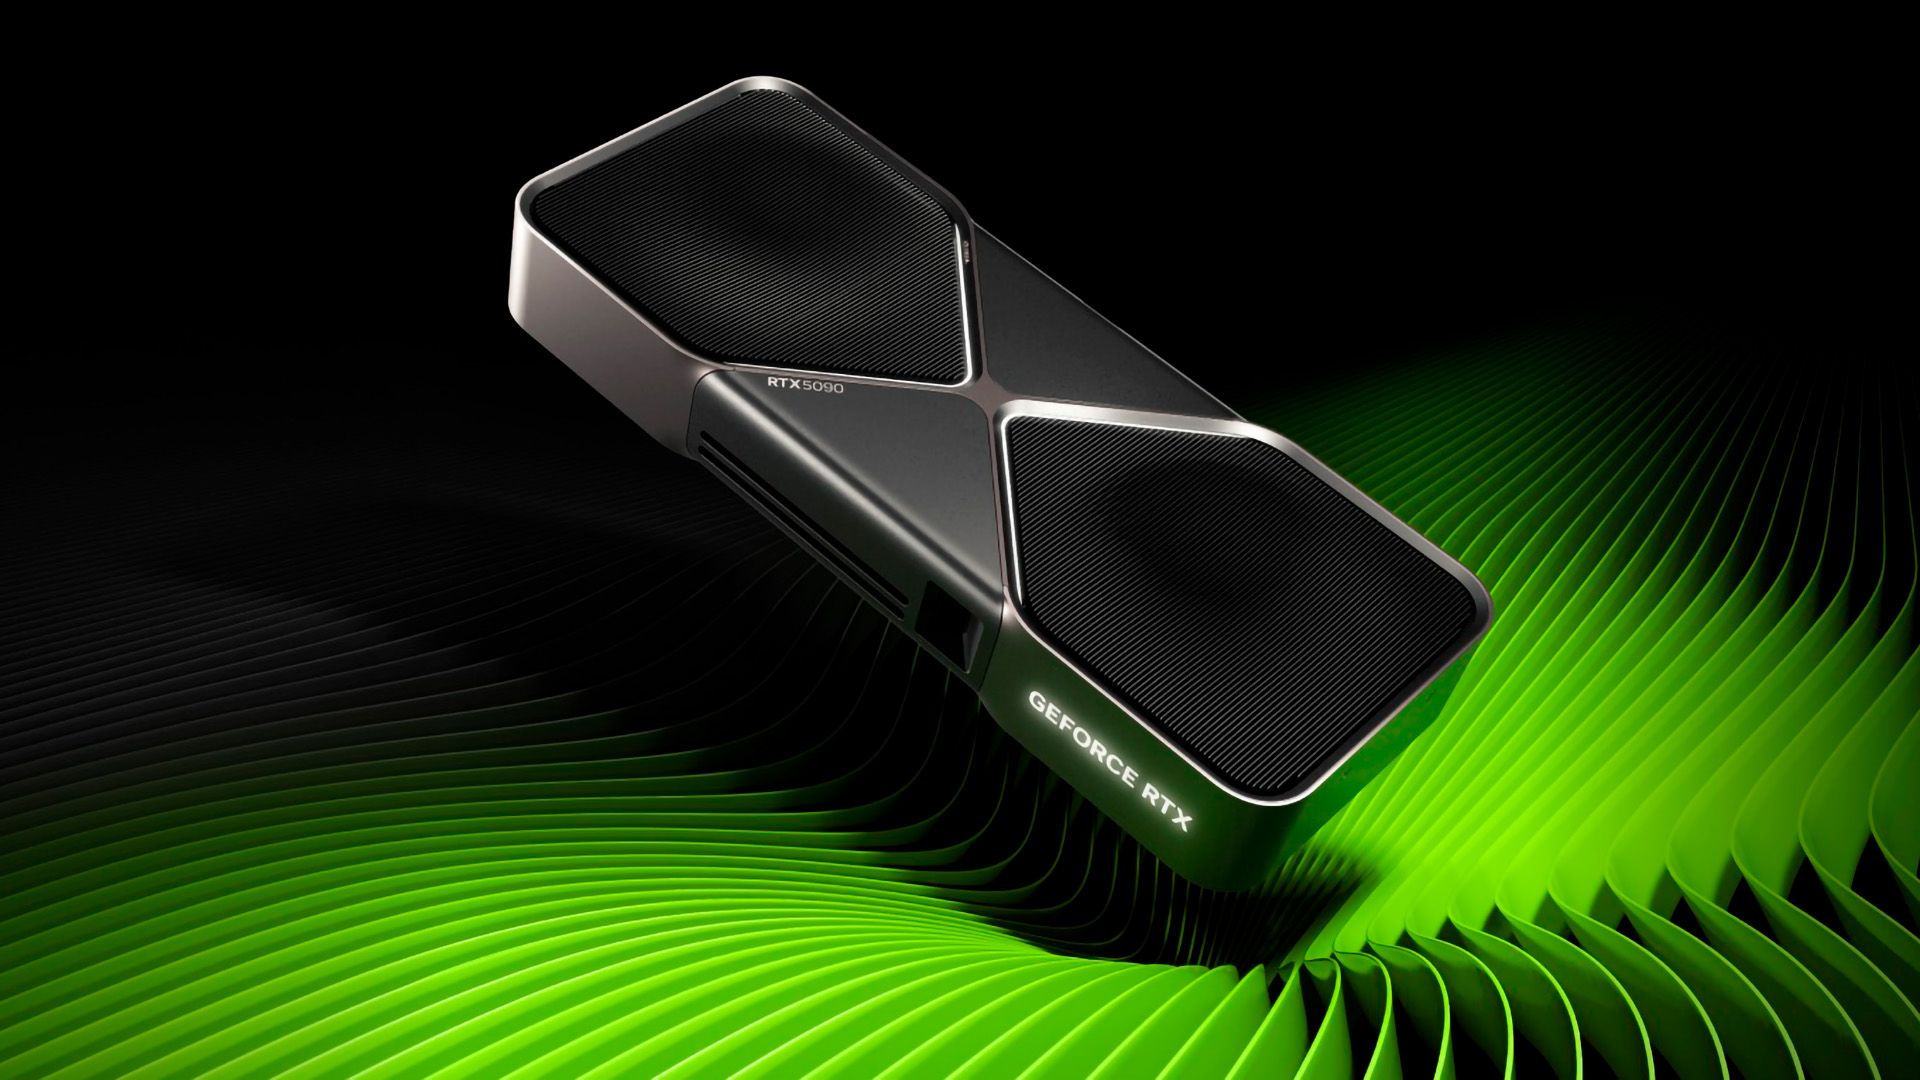
RTX 5090: Monster Spesifikasi yang Ternyata Cerewet soal Software
Di atas kertas, RTX 5090 tampak seperti jawaban sempurna untuk Qwen 3.8 27B: 32GB GDDR7 dan bandwidth 1,8 TB/s seolah menjamin segala kebutuhan inferensi selesai tanpa drama. Kenyataannya, performa AI RTX 5090 bergantung keras pada inference engine yang dipakai. Dengan llama.cpp, hasilnya kejam: meskipun context length penuh 262K bisa dialokasikan, time-to-first-token pada satu kartu bisa mencapai sekitar 30 menit—ini bukan lagi lambat, tetapi tidak layak pakai untuk kerja harian.
Berpindah ke vLLM, situasi membaik namun tetap penuh kompromi. Satu RTX 5090 dibatasi pada context 32K, dan tanpa multi-token prediction, kecepatan decode hanya sekitar 20 token per detik. Barulah konfigurasi dua RTX 5090 menyentuh level “serius”: kecepatan decode 70–80 token per detik, dan 100–110 token per detik dengan MTP aktif. Kalimat yang pantas dikutip di sini adalah: “Hasil pengujian dengan dua RTX 5090 menunjukkan peningkatan dramatis: kecepatan decode melonjak ke 70–80 token per detik, dan dengan mengaktifkan multi-token prediction, performa mencapai 100–110 token per detik.” Alternatif lain, SGLang, bahkan hampir tiga kali lebih cepat daripada vLLM pada satu RTX 5090, tetapi tetap belum menyelesaikan masalah konteks 262K—dua kartu tetap dibutuhkan.
RTX 4090 vs RTX 5090: Kapasitas, Bug, dan Batas Praktis VRAM
Pertarungan RTX 4090 vs RTX 5090 untuk Qwen 3.8 27B bukan sekadar adu angka VRAM. RTX 4090 dan 3090 dengan 24GB VRAM mampu memuat model Qwen 3.8 27B dalam format Q4_K_M GGUF memakai llama.cpp, tetapi dengan syarat ketat: KV cache harus memakai kuantisasi Q8_0 dan context depth dibatasi sekitar 112K token agar tidak kehabisan memori. Berbeda dengan RTX 5090 yang masih menyisakan ruang untuk desktop environment, kedua kartu 24GB ini praktis harus menyerahkan seluruh VRAM untuk workload AI; pengguna disarankan memakai GPU terpisah untuk display jika tidak menjalankan server headless.
Yang menggelisahkan, RTX 4090 menampilkan penurunan performa serupa RTX 5090 pada konteks panjang, sementara RTX 3090 tidak ikut terdampak. Ini indikasi kuat bahwa ada bug pada software, bukan murni keterbatasan hardware. Di titik ini, jelas bahwa VRAM besar tidak selalu menjamin performa optimal; kombinasi GPU, versi driver, dan inference engine lebih menentukan hasil sesungguhnya. Klaim kecepatan ratusan token per detik dari context window kosong juga terbukti menipu: “Kesimpulan dari pengujian ini menegaskan bahwa klaim kecepatan ratusan token per detik dari konteks kosong tidak mencerminkan kondisi nyata.” Untuk penggemar AI lokal, pesan praktisnya terang: jangan memilih kartu grafis hanya berdasarkan label RAM dan angka TFLOPS.
DGX Spark, Mac Studio, dan Menimbang Value di Luar Kubu GeForce
Benchmark Qwen 3.8 27B menjadi menarik ketika dibandingkan dengan platform memori terpadu seperti DGX Spark dan Mac Studio. DGX Spark punya bandwidth memori hanya 27 GB/s, sehingga di atas kertas tampak tidak cocok untuk model dense Qwen 3.8 27B. Namun dukungan MTP yang cukup diaktifkan lewat server launch flag memberi dorongan besar pada kecepatan decode, sementara prefill processing yang stabil membuat DGX Spark sering menyelesaikan inferensi konteks panjang lebih cepat daripada RTX 5090 ketika sama-sama menggunakan llama.cpp.
Mac Studio dengan M4 Max menawarkan bandwidth memori tertinggi di antara sistem memori terpadu yang diuji, tetapi kecepatan prompt processing-nya justru lebih lambat daripada DGX Spark. Untuk pengguna yang mencari GPU untuk AI lokal, ini menegaskan bahwa nilai sebuah sistem tidak semata diukur dari angka puncak bandwidth, melainkan dari seberapa matang dukungan software dan seberapa mudah platform tersebut dikonfigurasi. DGX Spark muncul sebagai opsi turnkey yang masuk akal ketika menghitung keseluruhan paket: performa konteks panjang, dukungan MTP bawaan, dan pengalaman setup yang lebih sederhana ketimbang membangun rig multi-GPU kelas enthusiast.
Rekomendasi Praktis: Memilih GPU untuk Inference Lokal dan Fine-Tuning
Apa artinya semua Qwen 3.8 27B benchmark ini bagi pengguna rumahan dan enthusiast? Pertama, kesimpulan besar pengujian mempertegas bahwa performa AI lokal tidak bisa diprediksi hanya dari spesifikasi hardware; pengguna perlu eksperimen dan benchmarking cermat untuk menemukan kombinasi GPU, inference engine, dan konfigurasi yang sesuai kebutuhan. Untuk fokus inference lokal dengan konteks sedang (≤32K), satu RTX 5090 masih menarik, terutama bila dipadukan dengan SGLang yang hampir tiga kali lebih cepat dari vLLM pada konfigurasi tersebut. Namun mereka yang mengincar konteks sangat panjang harus mulai memikirkan konfigurasi dua GPU atau beralih ke solusi memori terpadu seperti DGX Spark.
Untuk skenario fine-tuning, RTX 4090 dan 3090 tetap relevan, asalkan pengguna sadar penuh akan batasan VRAM 24GB dan kebutuhan pengaturan ulang kuantisasi serta context depth. Fine-tuning yang berat sebaiknya dijalankan di lingkungan terpisah dari display, agar seluruh VRAM bisa difokuskan ke workload AI. Di sisi lain, DGX Spark muncul sebagai kompromi menarik bagi pengguna yang ingin sistem siap pakai untuk inferensi panjang berkualitas produksi tanpa repot mengutak-atik driver dan konfigurasi multi-GPU. Pada akhirnya, pertanyaan “RTX 4090 vs RTX 5090 mana yang optimal untuk AI lokal?” tidak punya jawaban tunggal; pilihan terbaik adalah GPU yang selaras dengan pola kerja, batas budget, dan kesiapan Anda untuk merawat stack software yang menyertainya.