
Gambaran Umum: Dua Jalur Mini PC AI Lokal
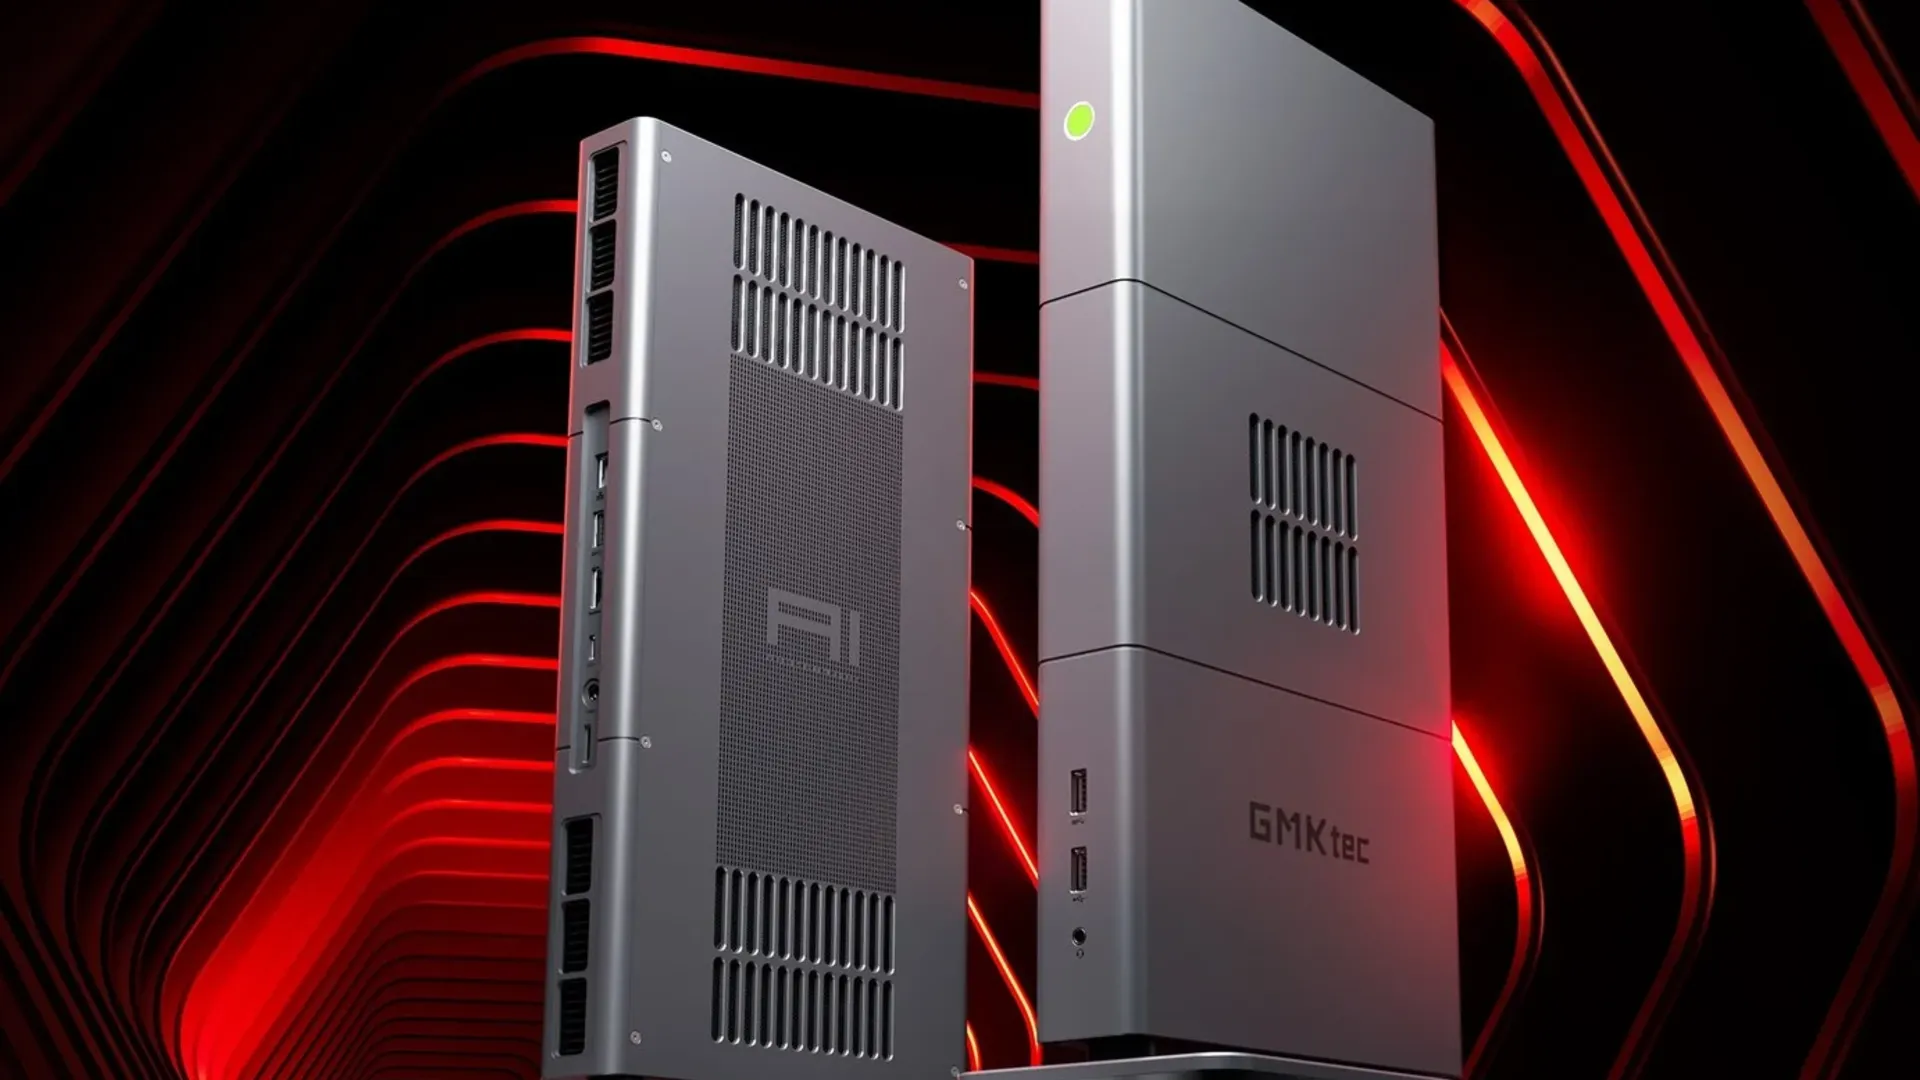
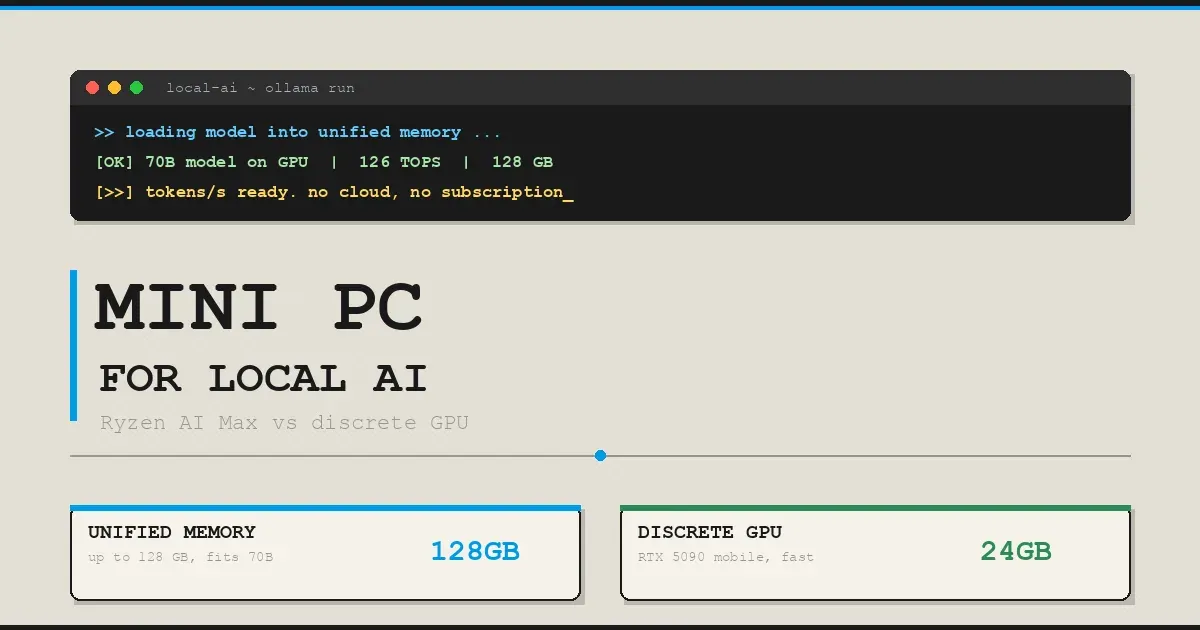
Mini PC AI lokal adalah komputer kecil yang dirancang untuk menjalankan model kecerdasan buatan di perangkat sendiri, sehingga komputasi lokal offline bisa dilakukan tanpa bergantung pada cloud atau langganan berbulan-bulan, dengan fokus pada kapasitas memori GPU, bandwidth, dan efisiensi daya agar inferensi AI berlangsung stabil untuk pemakaian harian. Mini PC untuk AI lokal sekarang terbagi menjadi dua filosofi utama: solusi dengan memori unified seperti AMD Ryzen AI Max+ 395, dan jalur GPU diskret seperti RTX 5090 mobile. Keduanya mampu menangani inferensi lokal, tetapi karakter performa, konsumsi daya, dan skalabilitas berbeda cukup jauh. Ryzen AI Max unggul di kapasitas dan integrasi AI native pada chipset, sementara RTX 5090 inferensi fokus pada kecepatan token mentah dengan bandwidth tinggi. Singkatnya: pilih Ryzen AI Max kalau prioritasmu ukuran model raksasa, pilih RTX 5090 kalau kamu mengejar respons super cepat di model menengah.
| Spec | A | B |
|---|---|---|
| Platform | Ryzen AI Max+ 395 (memori unified) | Mini PC dengan RTX 5090 mobile (GPU diskret) |
| Memori terlihat GPU | Hingga 96 GB dari total 128 GB unified | VRAM 24 GB tetap |
| Bandwidth memori | 256 GB/s | Sangat tinggi, di atas platform unified |
| Model yang muat | Hingga ~70B parameter dengan kuantisasi tepat | Sekitar 24–32B model terkuantisasi baik |
| NPU / AI engine | NPU 50 TOPS untuk tugas pendek bersertifikasi Copilot+ | Mengandalkan GPU, tidak disebut NPU khusus |
| Karakter performa | Kapabilitas besar, kecepatan token moderat | Token sangat cepat, batas kapasitas ketat 24 GB |
Performa Ryzen AI Max: Kapasitas Besar, Token Lebih Santai
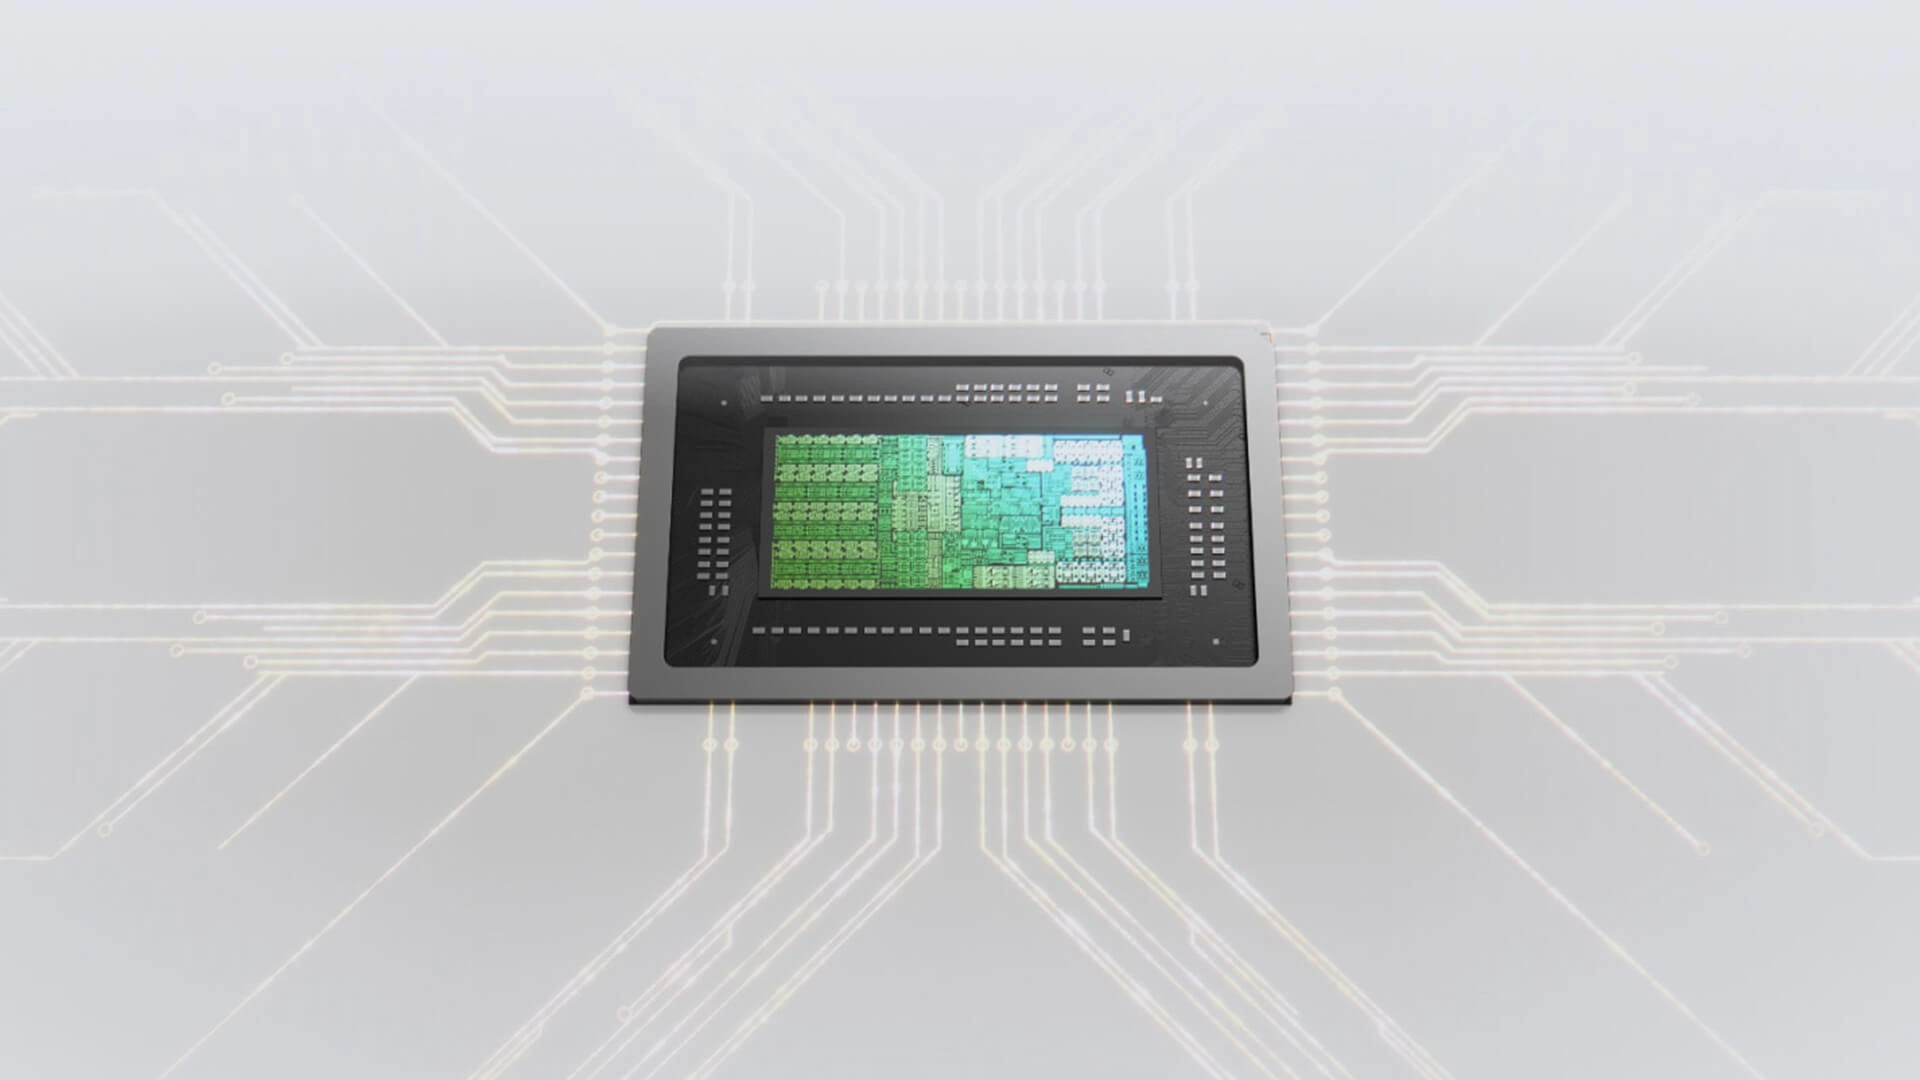
Ryzen AI Max+ 395 adalah chip mini PC dengan memori unified hingga 128 GB yang bisa dialokasikan hingga 96 GB ke GPU terintegrasi. Memori LPDDR5X yang sama digunakan oleh CPU, GPU, dan NPU, sehingga model yang dulu membutuhkan beberapa kartu grafis profesional kini dapat dijalankan di satu mesin kompak. Pendekatan ini memberi keunggulan kapasitas: model bahasa besar sampai sekitar 70 miliar parameter dengan kuantisasi Q4 masih bisa dimuat nyaman bersama sistem dan beberapa container. Namun, harga yang dibayar adalah bandwidth memori yang terbatas di 256 GB/s, jauh lebih rendah daripada GPU desktop kelas atas. Ini membuat performa token per detik terasa lebih pelan; model 70B di Q4_K_M berjalan sekitar 14–18 token per detik, cukup untuk membaca, kurang ideal untuk sesi sangat interaktif. Di sisi positif, model 30B yang dioptimalkan dapat mendekati 100 token per detik, menyeimbangkan kapasitas dan kecepatan untuk banyak skenario kerja.
Performa RTX 5090: Bandwidth Tinggi untuk Inferensi Cepat
Mini PC dengan GPU RTX 5090 mobile mengandalkan jalur GPU diskret, yaitu VRAM 24 GB yang berdiri sendiri dengan bandwidth sangat tinggi. Filosofi ini membalik kompromi Ryzen AI Max: alih-alih kapasitas raksasa, kamu mendapatkan token per detik yang jauh lebih cepat, sehingga inferensi terasa lincah untuk model menengah. RTX 5090 desktop bahkan melaju lebih tinggi lagi dalam bandwidth, menggambarkan betapa fokusnya jalur ini pada kecepatan mentah. Kelemahannya adalah “hard ceiling” 24 GB, yang membatasi penggunaan ke model sekitar 24–32 miliar parameter dalam bentuk terkuantisasi baik. Musuh lain adalah panas; menjejalkan GPU kelas ini ke sasis mini PC menuntut pendinginan serius dan konsumsi daya yang signifikan. Jika workflow-mu bergantung pada banyak permintaan paralel, respons instan, dan jarang membutuhkan model raksasa, RTX 5090 inferensi memberi pengalaman yang terasa jauh lebih gesit, dengan latensi rendah meski kapasitasnya lebih kecil.
Harga, ROI, dan Komputasi Lokal Offline untuk Kreator & Developer
Di ekosistem Ryzen AI Max+ 395, beberapa mini PC seperti unit dengan 128 GB unified memori diposisikan sebagai cara paling terjangkau untuk sampai ke kapasitas tersebut, sedangkan model lain menambahkan fitur home lab seperti jaringan 10GbE ganda dan pendinginan vapor chamber untuk menyala siang malam. Walaupun sumber menyebut kisaran harga dalam pasar tertentu, angka itu tidak bisa langsung diterapkan ke semua wilayah, sehingga lebih bijak melihatnya sebagai indikasi bahwa solusi memori unified cenderung berada di segmen premium. ROI-nya perlu ditimbang terhadap biaya langganan cloud bulanan; salah satu analisis menyarankan perhitungan pelan-pelan saat mengganti langganan AI sekitar 200 dolar per bulan dengan perangkat lokal. Untuk content creator dan developer yang ingin komputasi lokal offline—misalnya inferensi dengan Ollama atau Gemma tanpa cloud—mini PC ini menghilangkan biaya variabel dan kendala jaringan. Pilih memori unified jika kamu sering bereksperimen dengan model besar; pilih GPU diskret jika fokusmu produksi cepat dengan model menengah.
Buy if / Skip if
- Buy the Ryzen AI Max+ 395 mini PC if kamu butuh mini PC AI lokal dengan kapasitas hingga 128 GB untuk memuat model sampai 70B dan beberapa container sekaligus.
- Skip the Ryzen AI Max+ 395 mini PC if kebutuhanmu adalah inferensi super cepat pada model menengah dan kamu jarang menyentuh model di atas 30B.
- Buy the RTX 5090 mini PC if kamu mengutamakan RTX 5090 inferensi dengan kecepatan token tinggi dan latensi rendah untuk komputasi lokal offline berbasis model 24–32B.
- Skip the RTX 5090 mini PC if workflow-mu menuntut memuat model raksasa yang melampaui batas keras 24 GB VRAM dan kamu siap mengorbankan sedikit kecepatan demi kapasitas.