
Tiga model, tiga jenis keputusan
Model AI adalah sistem yang dilatih untuk menjalankan tugas seperti menulis kode, memahami konteks panjang, atau memilih jawaban; dalam perbandingan ini, cara mengaksesnya sama pentingnya dengan kemampuan teknisnya. SWE-2 Flash paling cocok bagi pengguna agen Devin yang mengutamakan respons cepat tanpa mengelola endpoint sendiri. Ripple-65B Preview lebih menarik bagi tim yang membutuhkan bobot terbuka dan kendali self-hosting, tetapi konteks panjang yang diklaim tidak tersedia lewat API hosted saat ini. PPLX Decider Flash ditujukan untuk keputusan ringan dan satu pertanyaan per state, bukan otomatis pilihan termurah untuk percakapan beruntun. Jadi, perbandingan model AI ini bukan lomba spesifikasi: tiap model memiliki batas distribusi atau pola biaya yang dapat mengubah kecocokannya.
| Spesifikasi | SWE-2 Flash | Ripple-65B Preview | PPLX Decider Flash |
|---|---|---|---|
| Fokus | Pengodean melalui agen Devin | Pengodean agentik; bobot dapat diunduh | Tugas pengambilan keputusan |
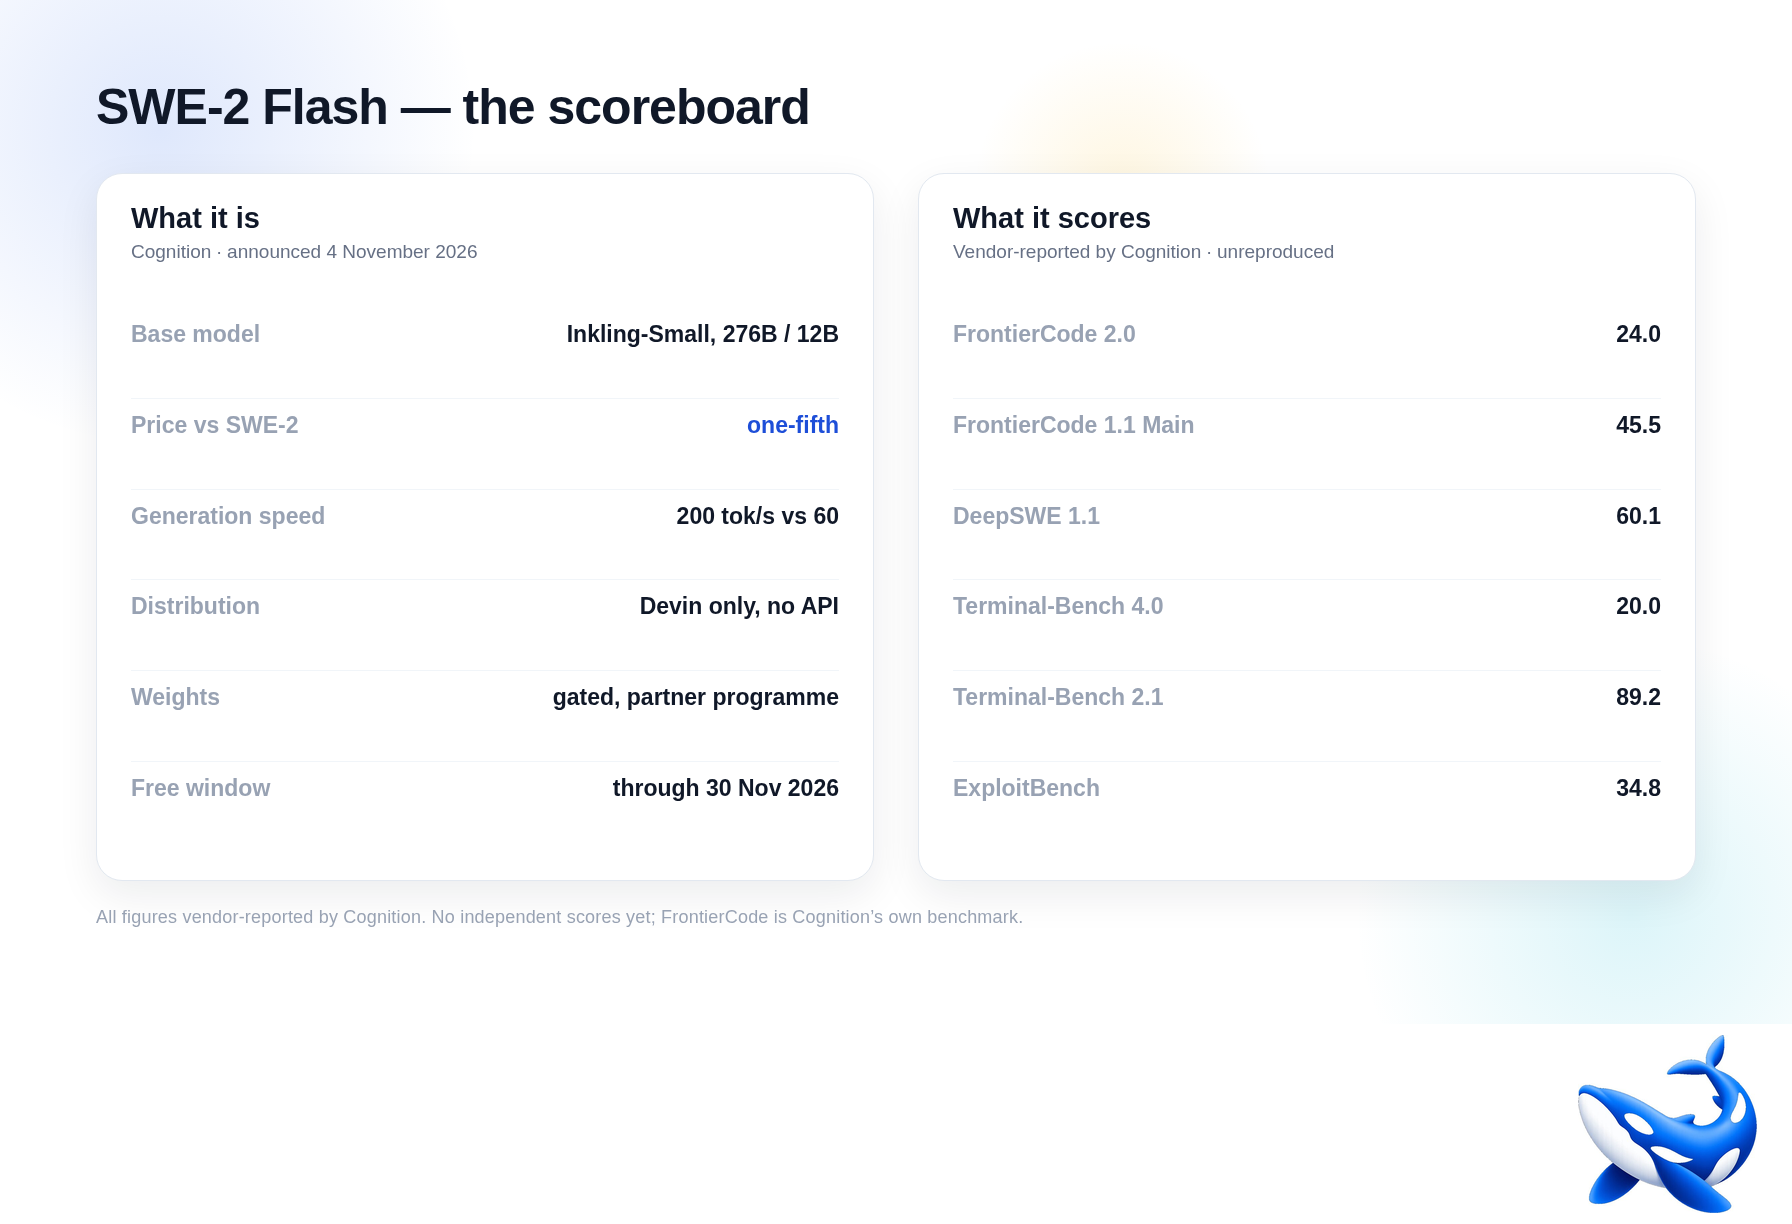
| Basis / ukuran | Inkling-Small; 276B parameter total, 12B aktif | Transformer dense 65B | Qwen3.5-4B; sekitar 9 GiB |
| Akses | Devin Desktop dan Devin CLI; tidak ada API publik | Bobot Apache 2.0; API hosted tersedia | API dan bobot Apache 2.0 |
| Konteks | Tidak dinyatakan pada materi rilis | Klaim hingga 1 juta token; API hosted 16.384 token | Default 262.144 token |
| Kecepatan / biaya | Klaim 3 kali lebih cepat dan seperlima biaya SWE-2 di Devin | Tidak ada angka biaya atau kecepatan yang sebanding dalam materi | Biaya input per token lebih rendah daripada Decider 27B, tetapi bergantung pada jumlah pertanyaan per state |
| Batas utama | Klaim angka berasal dari pengujian internal dan aksesnya terbatas pada Devin | Bobot sekitar 129,6 GB; konteks 1 juta memerlukan self-hosting | Akurasi lebih rendah daripada model 27B; penagihan berulang dapat menghapus keunggulan biaya |
SWE-2 Flash: cepat untuk pengguna Devin, bukan API umum
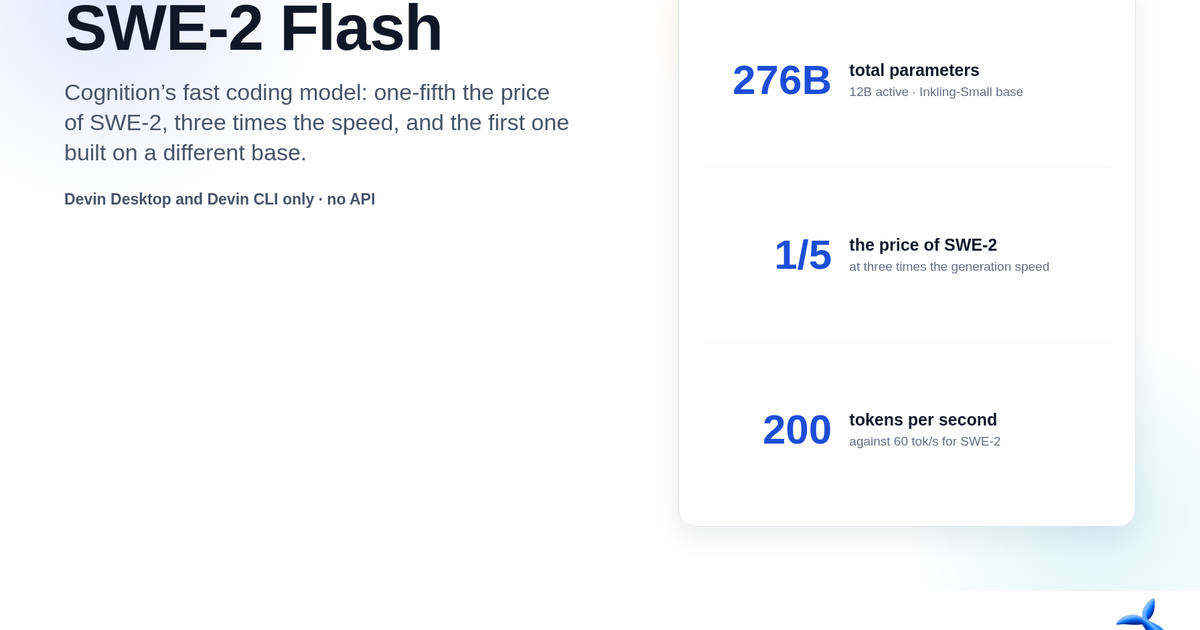
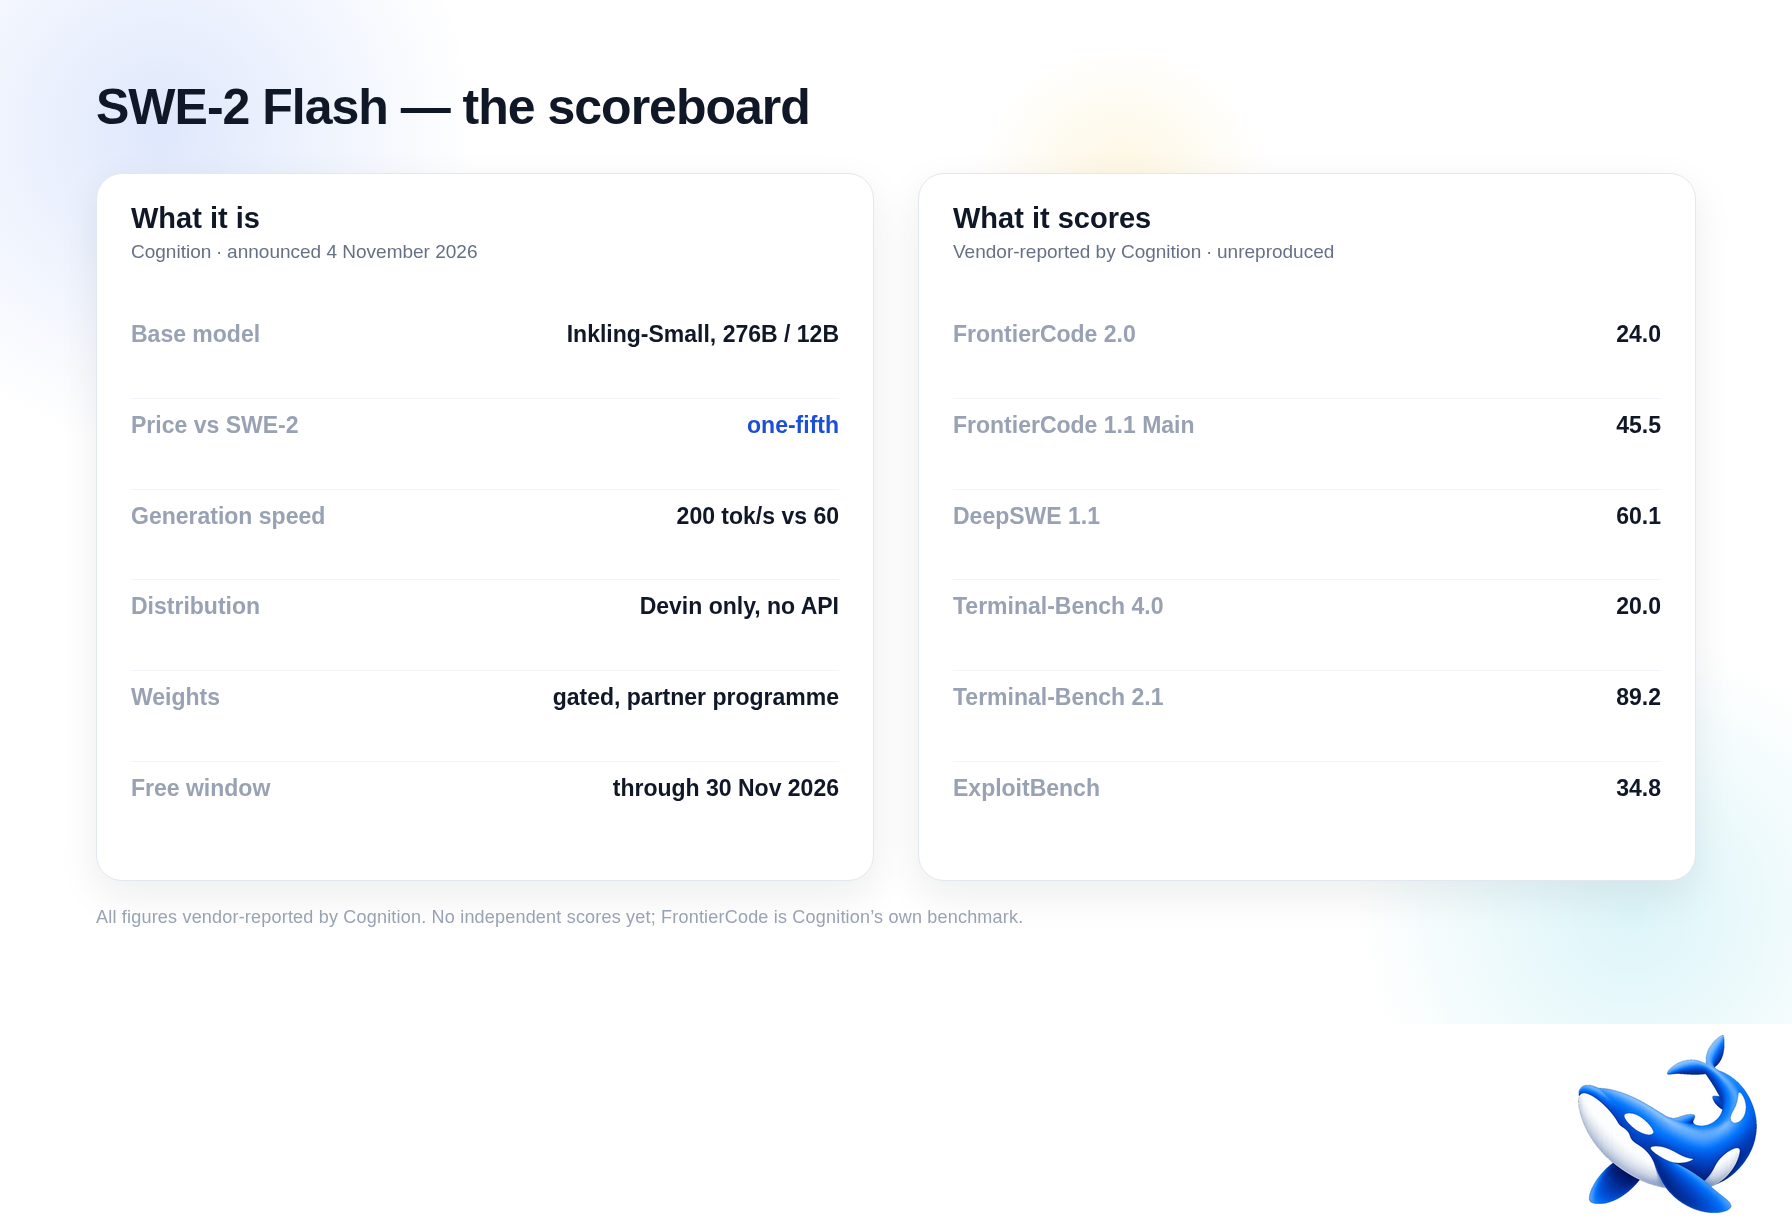
SWE-2 Flash, salah satu model AI terbaru dalam perbandingan ini, dirilis pada 4 November 2026 dengan klaim biaya seperlima dan kecepatan tiga kali SWE-2. Angka tersebut berlaku dalam Devin, bukan tarif token atau tolok ukur endpoint independen. Materi peluncuran menggambarkan pemutaran ulang tugas dengan simulasi 200 token per detik dibanding 60, sehingga angka itu tidak boleh dibaca sebagai hasil uji langsung pada layanan API publik. Basisnya berbeda dari SWE-2: model ini merupakan hasil pelatihan lanjut Inkling-Small, dengan 276 miliar parameter total dan 12 miliar aktif. Keunggulan praktisnya ialah integrasi langsung di Devin Desktop dan CLI, termasuk akses gratis hingga 30 November 2026. Namun, tidak ada endpoint publik atau daftar harga per token. Pilih model ini bila alur kerja Anda memang berada di Devin; jika perlu integrasi dari aplikasi sendiri, keterbatasan aksesnya lebih menentukan daripada klaim kecepatannya.
Ripple-65B Preview: bobot terbuka, tetapi konteks hosted jauh lebih pendek
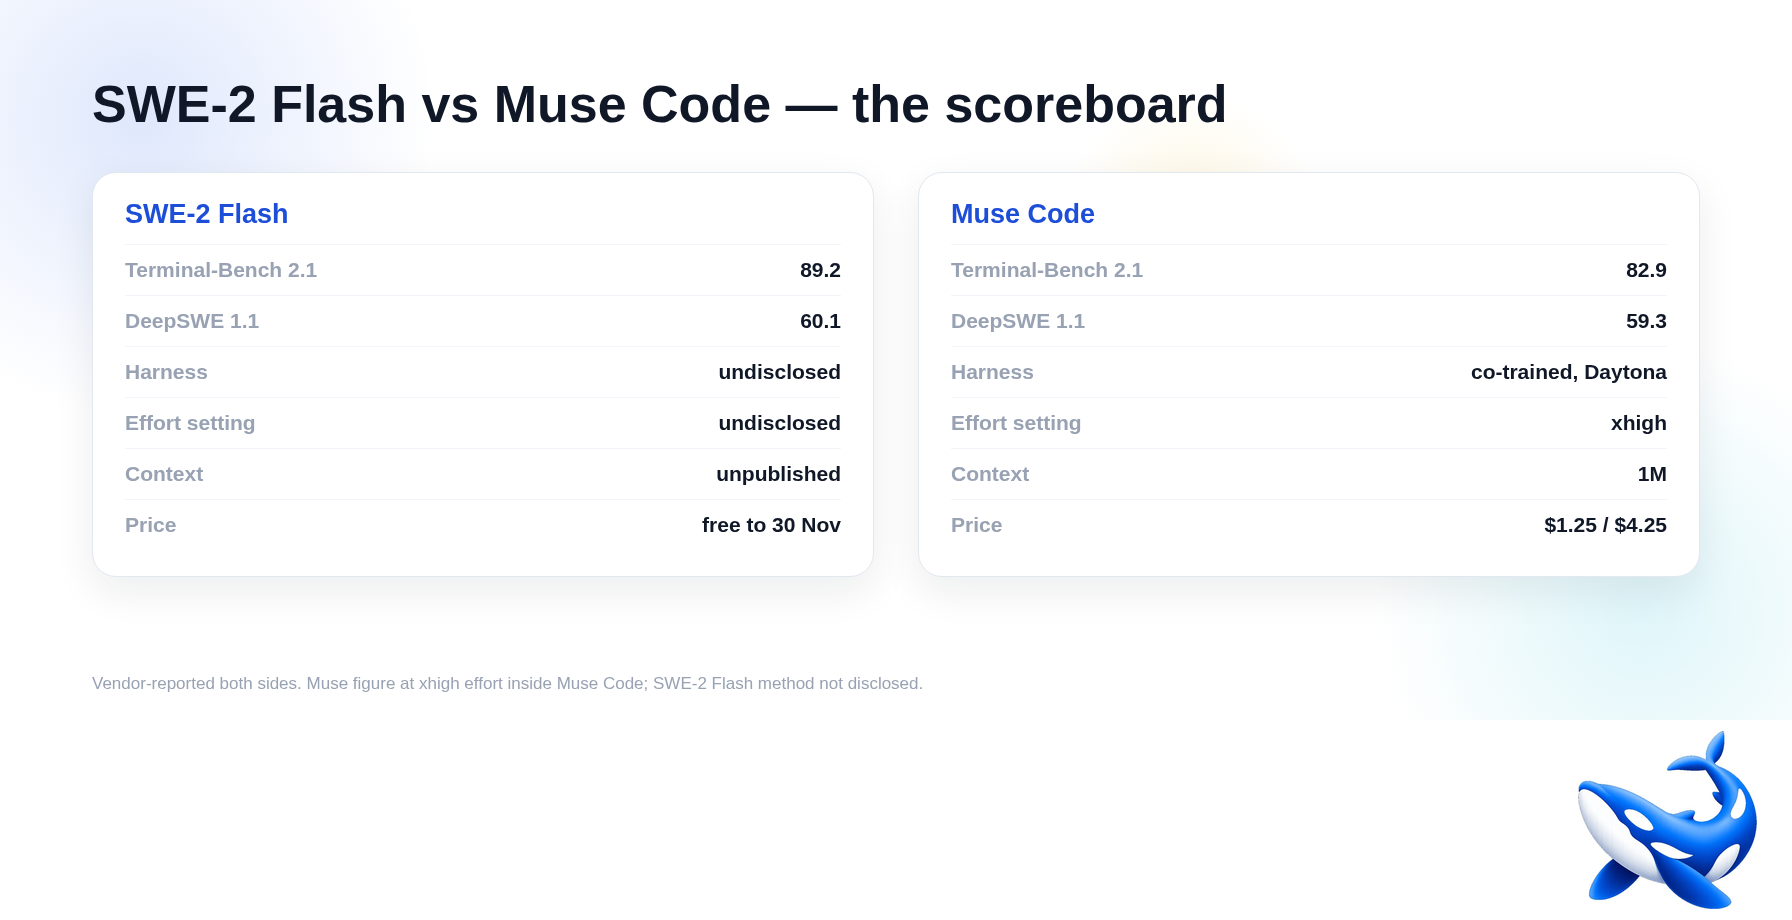
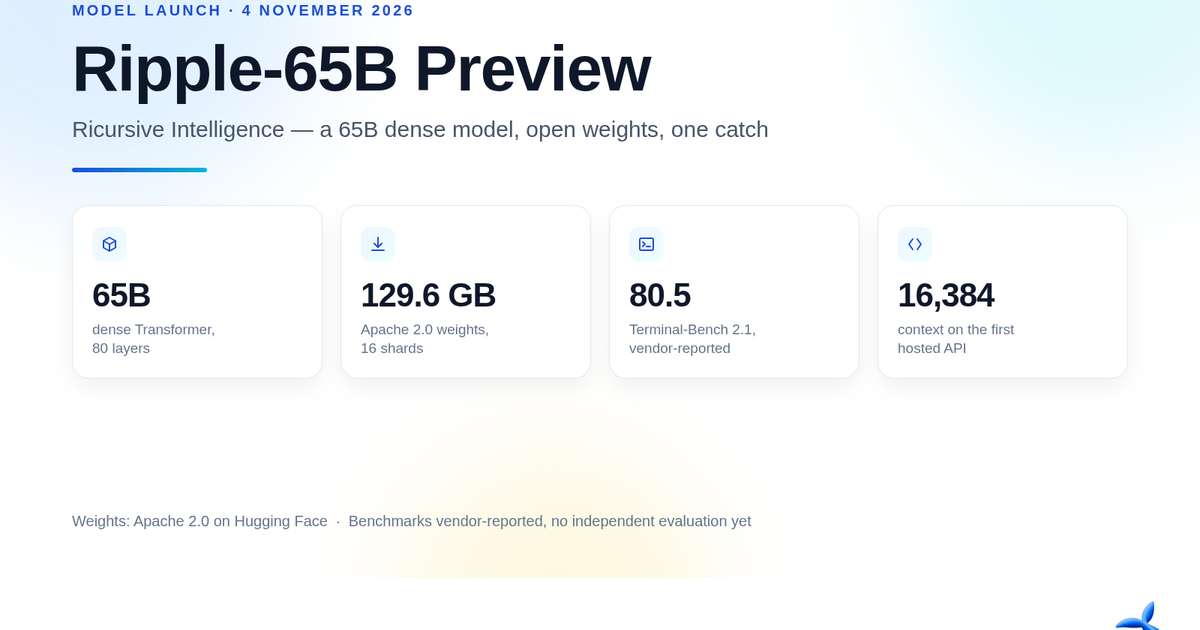
Ripple-65B Preview menawarkan pilihan berbeda: checkpoint dense 65B dengan bobot berlisensi Apache 2.0 yang dapat diunduh, sehingga tim bisa mengelola deployment sendiri. Kartu model mengiklankan konteks hingga 1 juta token, tetapi endpoint komersial hosted membatasi konteks pada 16.384 token. Selisih ini penting: jika kebutuhan utama Anda adalah memasukkan dokumen atau riwayat sangat panjang, Anda harus menyiapkan self-hosting, bukan mengandalkan API. Bobot utamanya berukuran sekitar 129,6 GB, sehingga kebebasan lisensi tidak berarti kebutuhan perangkat kerasnya ringan. Klaim performa Terminal-Bench 2.1 sebesar 80,52 berasal dari evaluasi vendor dan belum direproduksi pihak ketiga dalam materi yang tersedia. Ripple lebih masuk akal bagi tim teknis yang mengutamakan kendali, bobot terbuka, dan pengodean agentik. Untuk penggunaan hosted yang mengandalkan konteks panjang, batas 16K membuat klaim kapasitas 1 juta token kurang berguna.
PPLX Decider Flash: hemat untuk satu pertanyaan, bukan selalu untuk rangkaian
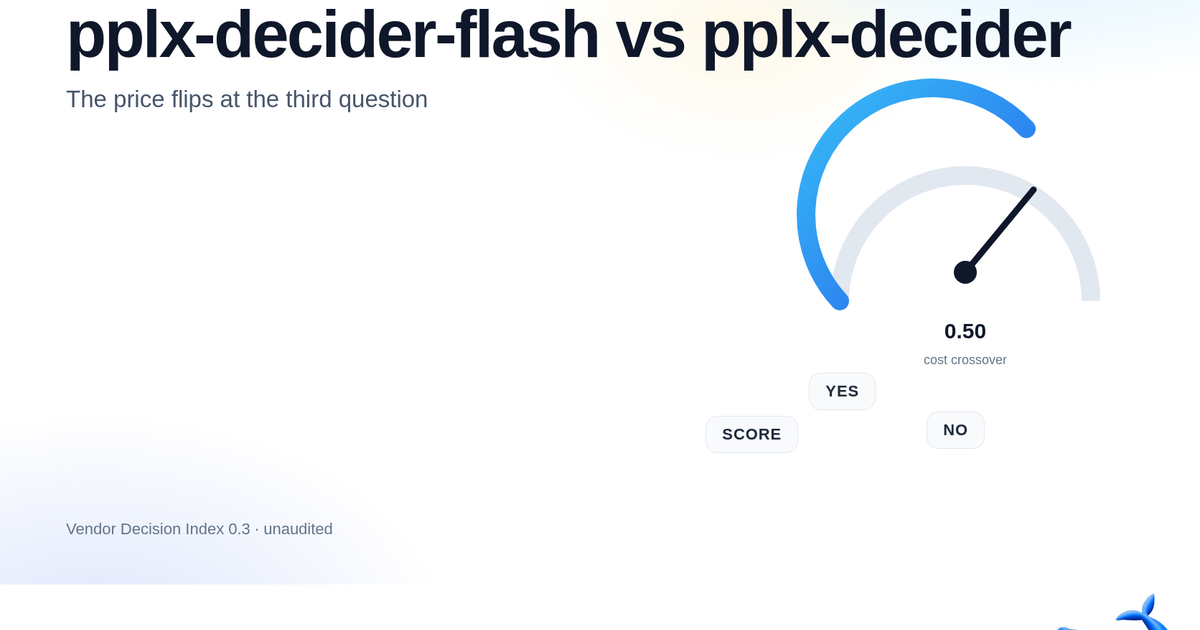
PPLX Decider Flash memakai basis Qwen3.5-4B dan berukuran sekitar 9 GiB, sehingga lebih ringan untuk latensi dan kebutuhan memori daripada Decider yang lebih besar. Harga input per tokennya lebih rendah, tetapi pola penagihan mengubah hasil saat beberapa pertanyaan berbagi state: Flash menagih state untuk setiap pertanyaan, sedangkan model 27B menagihnya sekali. Untuk satu pertanyaan, Flash menjadi pilihan yang lebih ekonomis; pada dua pertanyaan biayanya setara, dan mulai tiga pertanyaan model besar dapat lebih murah sekaligus lebih akurat. Keduanya memiliki konteks default 262.144 token dan lisensi Apache 2.0. Data evaluasi yang disediakan menunjukkan skor gabungan 58,88 untuk Flash dibanding 68,09 untuk model besar, dengan selisih khususnya terlihat pada kategori pengetahuan. Namun, skor tersebut merupakan evaluasi vendor yang belum direproduksi pihak ketiga. Pilih Flash untuk beban ringan satu pertanyaan dengan volume tinggi, bukan hanya karena angka biaya per token tampak lebih kecil.
Buy if / Skip if
- Buy the SWE-2 Flash if Anda sudah bekerja di Devin dan mengutamakan pengodean agen yang cepat tanpa mengelola layanan sendiri.
- Skip the SWE-2 Flash if aplikasi Anda memerlukan endpoint API publik atau tarif token yang bisa dibandingkan langsung.
- Buy the Ripple-65B Preview if Anda memiliki perangkat keras dan tim untuk self-hosting, serta membutuhkan bobot Apache 2.0 dengan kendali deployment.
- Skip the Ripple-65B Preview if Anda mengandalkan API hosted untuk konteks 1 juta token; batas saat ini hanya 16.384 token.
- Buy the PPLX Decider Flash if beban kerja Anda biasanya satu pertanyaan per state dan penggunaan memori rendah menjadi prioritas.
- Skip the PPLX Decider Flash if Anda mengajukan beberapa pertanyaan dalam state yang sama atau membutuhkan akurasi lebih tinggi pada tugas pengetahuan; bandingkan dengan Decider 27B.