
Gelombang Baru Chip Akselerator AI: Dari Rak Data Center ke PC Kantor
Gelombang baru chip akselerator AI adalah pergeseran strategis di mana vendor cloud dan pembuat prosesor merancang hardware AI acceleration sendiri, dari skala rak data center hingga PC bisnis, untuk mengurangi ketergantungan pada GPU proprietary dan menekan biaya inferensi AI lokal maupun di cloud sambil menjaga kendali atas data dan performa operasional.
Inti cerita hari ini bukan sekadar chip baru, tetapi perebutan kendali atas infrastruktur AI. AMD datang dengan Helion sebagai rancangan acuan terbuka untuk infrastruktur agentic AI berskala rak, yang memungkinkan kombinasi CPU–GPU disesuaikan dengan beban kerja agen AI perusahaan. Microsoft memilih jalur berbeda dengan Maia 300, chip inferensi internal yang akan menjadi mesin utama Azure mulai 2027. Di sisi klien, AMD Ryzen AI Max 400 membawa inferensi AI lokal ke PC bisnis, sehingga agen AI tidak selalu bergantung pada cloud. Tekanan biaya infrastruktur AI yang melonjak dan tuntutan keamanan data membuat langkah ini bukan pilihan tambahan, melainkan strategi bertahan hidup di era AI generatif.
AMD Helion: Agentic AI Skala Rak sebagai GPU Alternative Enterprise
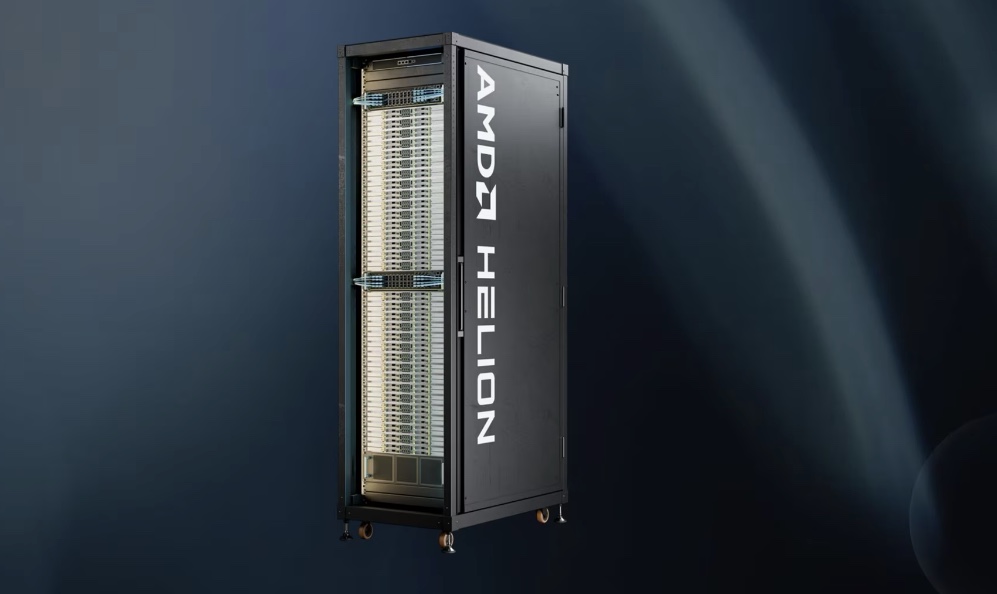
AMD Helion adalah jawaban agresif terhadap dominasi GPU tunggal di data center: sebuah rancangan acuan terbuka berbasis spesifikasi Open Compute Project untuk infrastruktur agentic AI berskala rak yang bisa dikustomisasi oleh operator cloud dan enterprise. Pendekatan terbuka ini penting karena perusahaan tidak lagi ingin terkunci pada satu vendor GPU ketika beban kerja agen AI berubah cepat dari hari ke hari.
Helion menawarkan dua jalur. Pertama, rak khusus CPU dengan prosesor AMD EPYC generasi keenam yang dapat menampung hingga 32.768 core CPU untuk beban kerja agen yang sangat paralel. Kedua, rak terpadu yang menggabungkan node CPU EPYC, GPU Instinct MI350P, dan komputasi serbaguna dalam satu platform untuk kebutuhan agentic AI di lingkungan perusahaan. Dengan dukungan pendingin udara maupun cairan dan kemampuan memanfaatkan infrastruktur TI yang sudah ada, Helion diposisikan sebagai GPU alternative enterprise yang fleksibel, bukan sekadar klon ekosistem Nvidia. Konfigurasi rak saat ini masih dikembangkan bersama mitra, dengan ketersediaan yang direncanakan pada November 2026.
Microsoft Maia 300: Mesin Inferensi Azure dan Tekanan ke Margin Nvidia
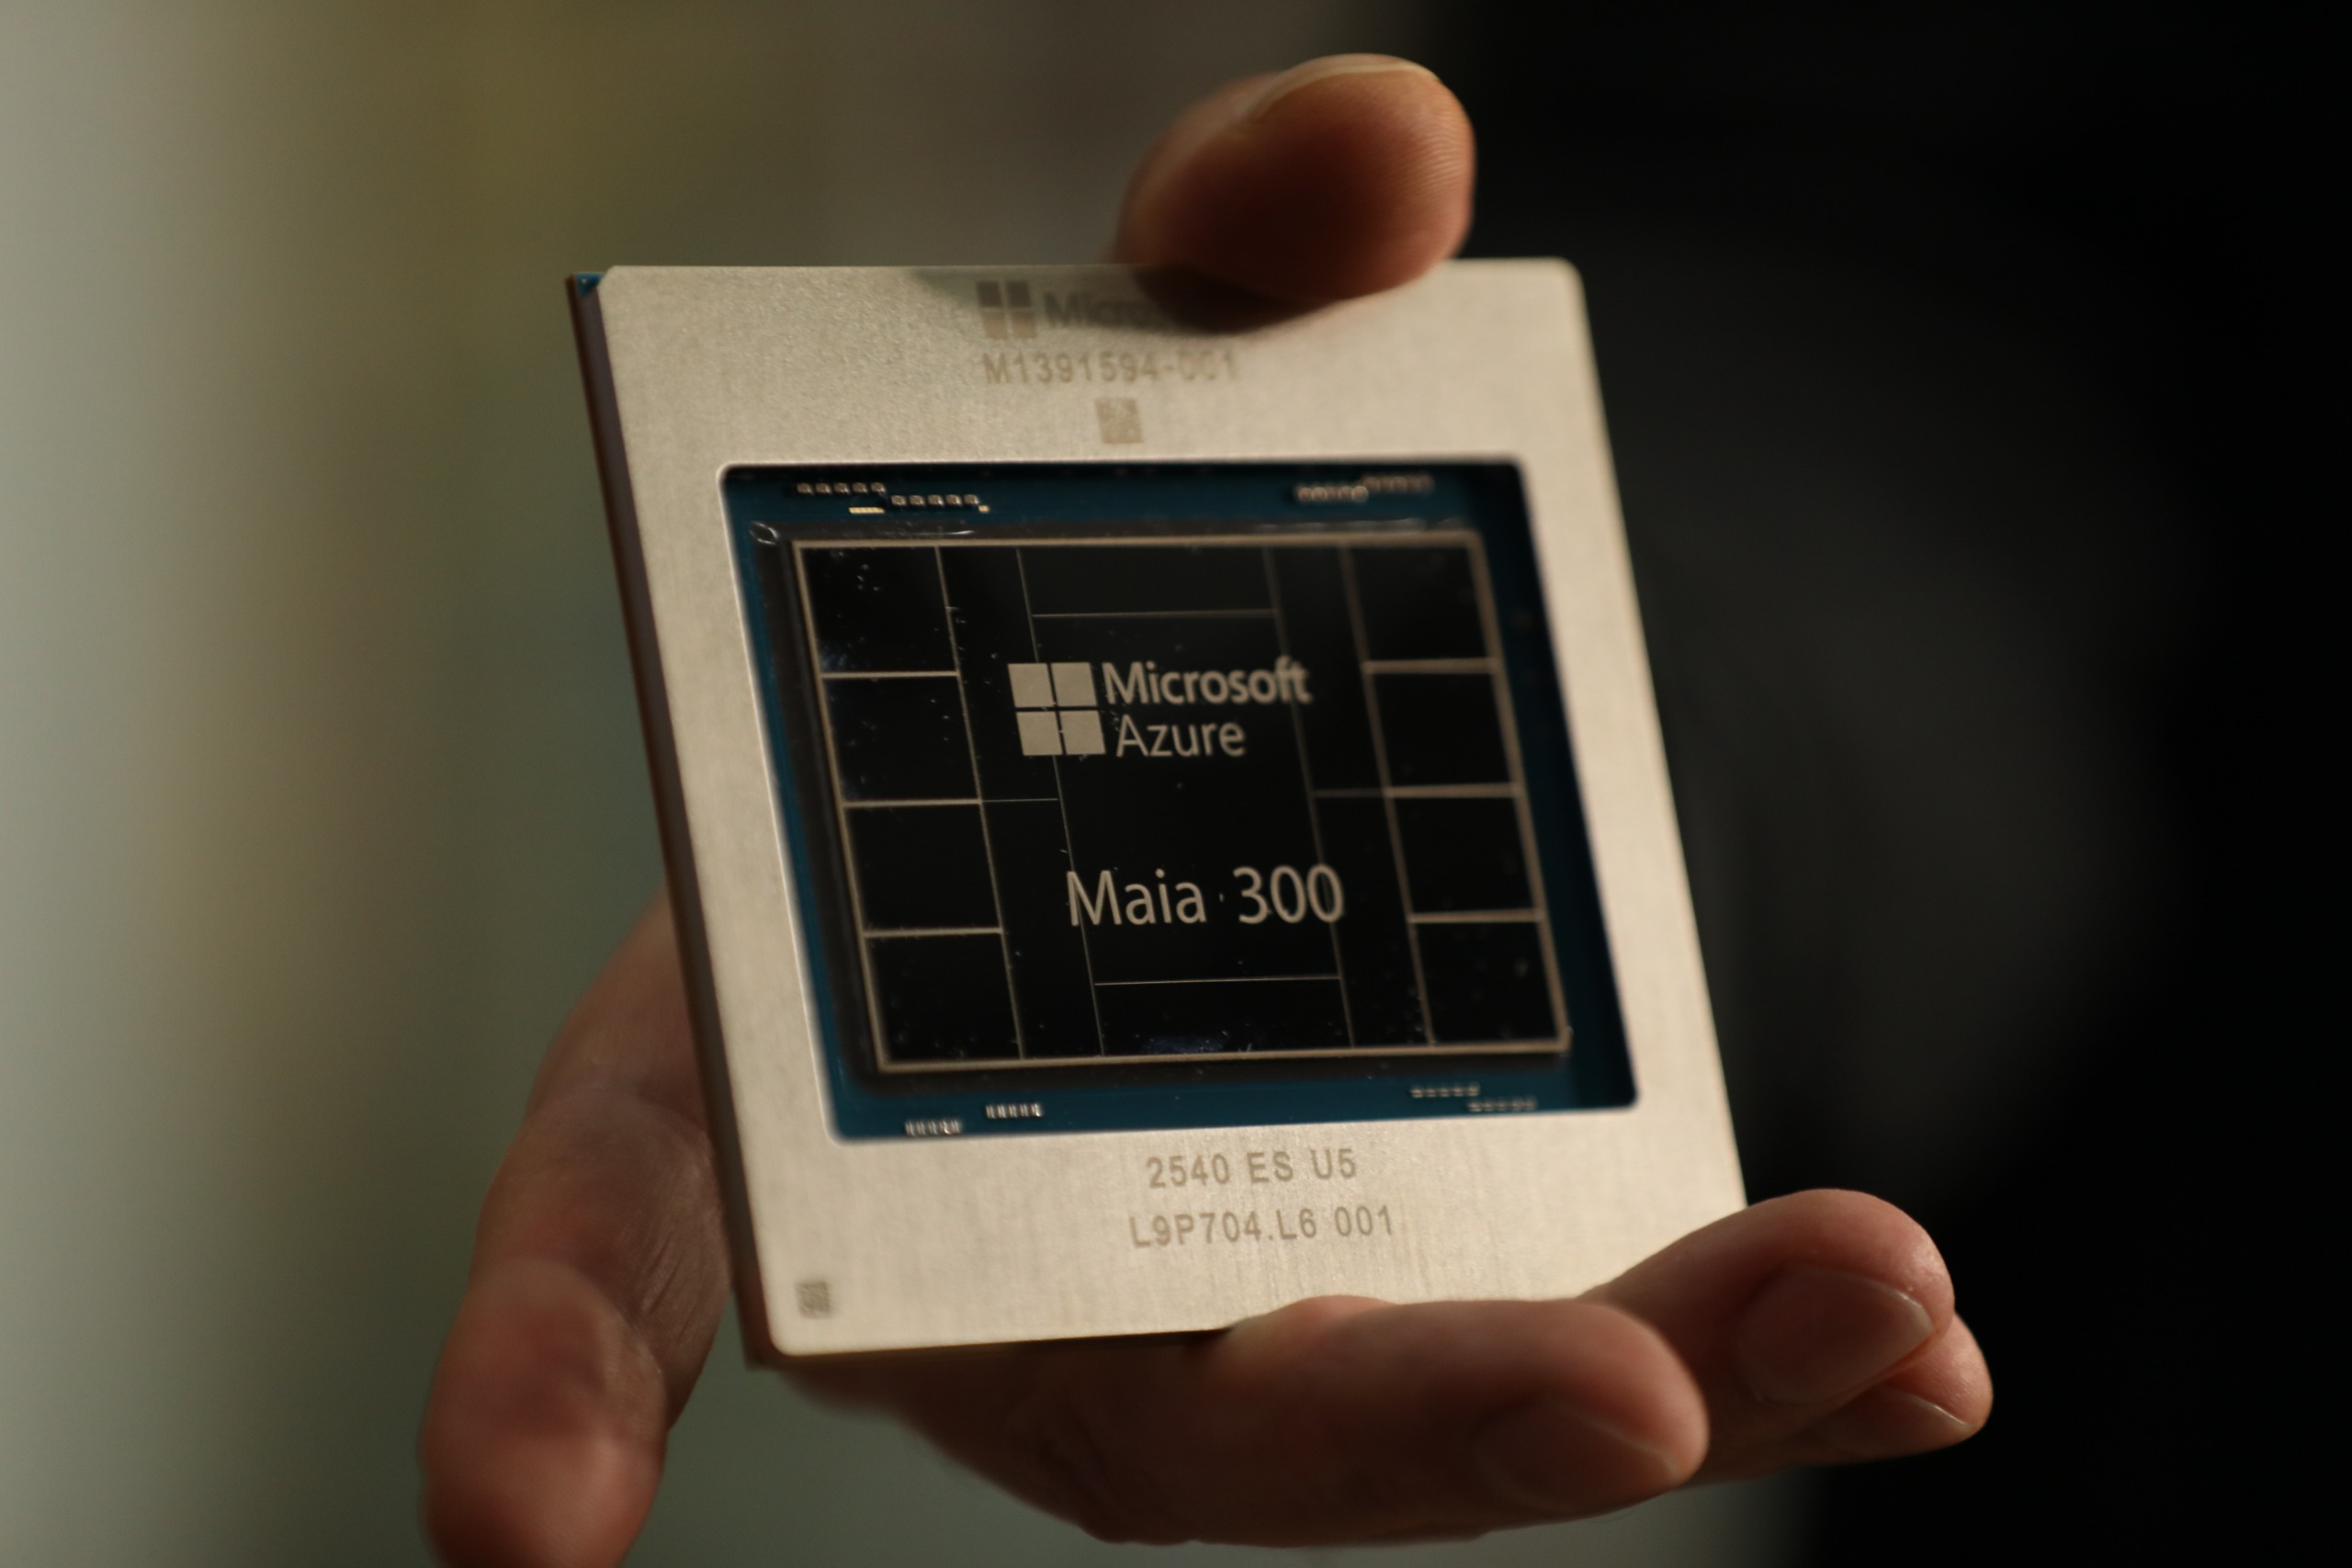
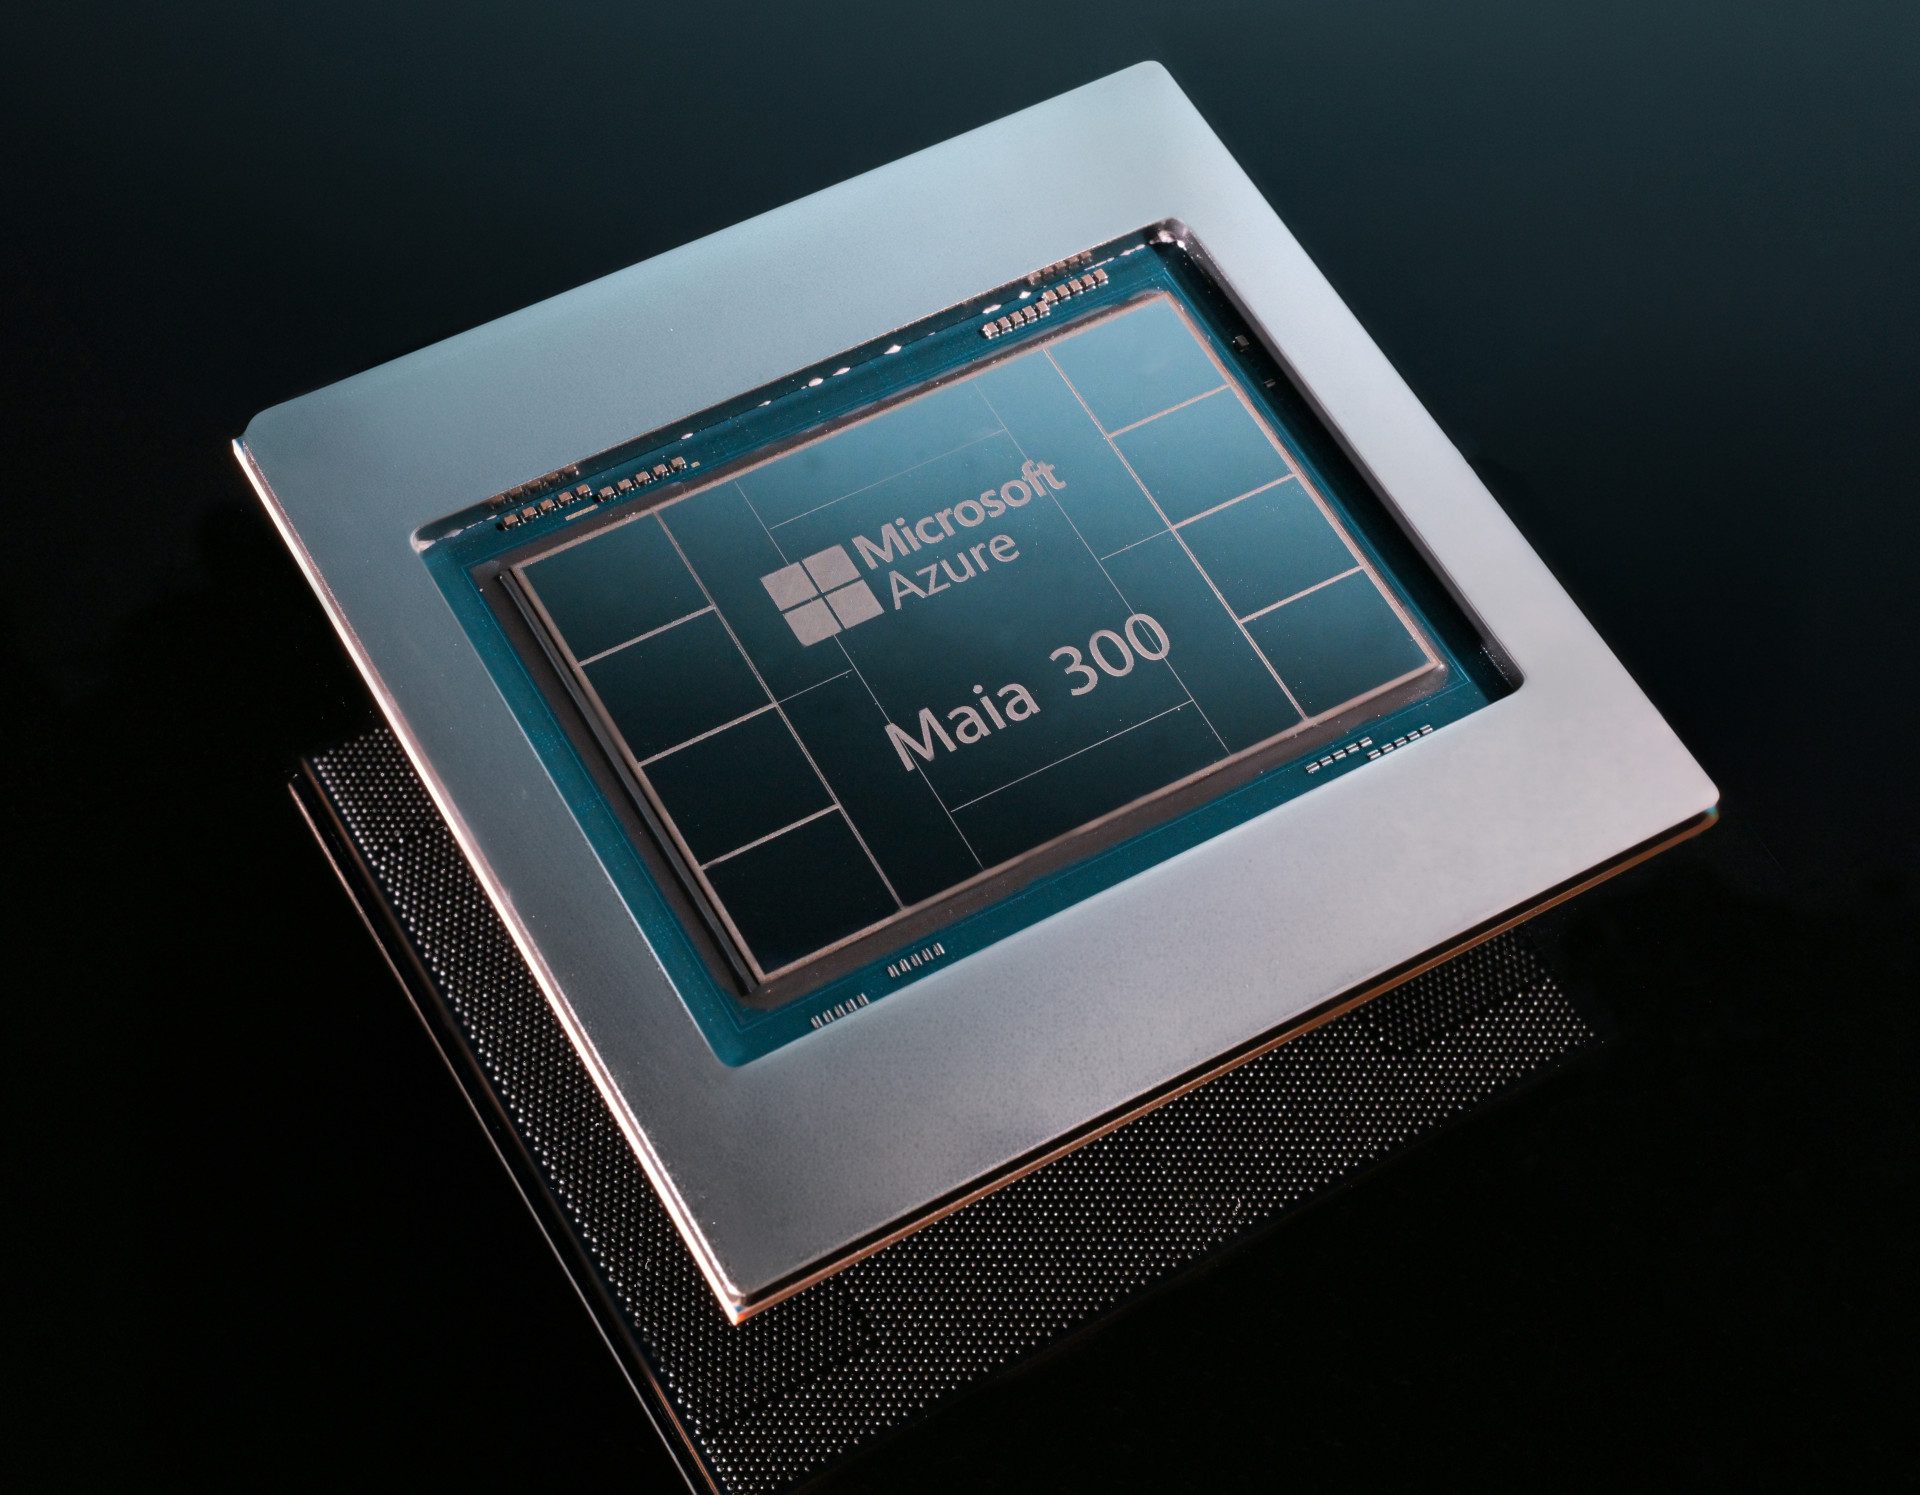
Jika AMD bermain di ranah terbuka, Microsoft memilih strategi integrasi vertikal lewat Maia 300. Perusahaan memastikan Azure Maia akan menjadi mesin inferensi utama untuk produk dan layanannya, dengan deployment multi-gigawatt mulai 2027. Artinya, setiap panggilan Copilot, Teams, atau layanan AI lain akan semakin sering berjalan di silikon internal, bukan GPU Nvidia.
Secara teknis, Maia 300 beralih dari desain single die Maia 200 ke paket multi-chiplet, dengan komputasi di proses TSMC N2P dan die terpisah untuk memory-controller serta I/O. Delapan stack HBM4 menghadirkan 288GB memori dengan bandwidth 18TB/s per akselerator, naik dari 216GB dan 7,1TB/s pada Maia 200. Fokusnya jelas: mengatasi bottleneck memori pada fase decode, ketika akselerator lebih sering menunggu data ketimbang menghitung. Microsoft menukar kenaikan komputasi moderat sekitar 36% dengan bandwidth memori 2,5 kali lipat. Dalam konteks chip akselerator AI, ini adalah taruhan bahwa efisiensi inferensi dan kontrol biaya lebih penting daripada mengejar angka FLOPS semata, sekaligus menekan margin tinggi yang selama ini dinikmati Nvidia.
Ryzen AI Max 400: Inferensi AI Lokal di PC Bisnis, Bukan Hanya di Cloud
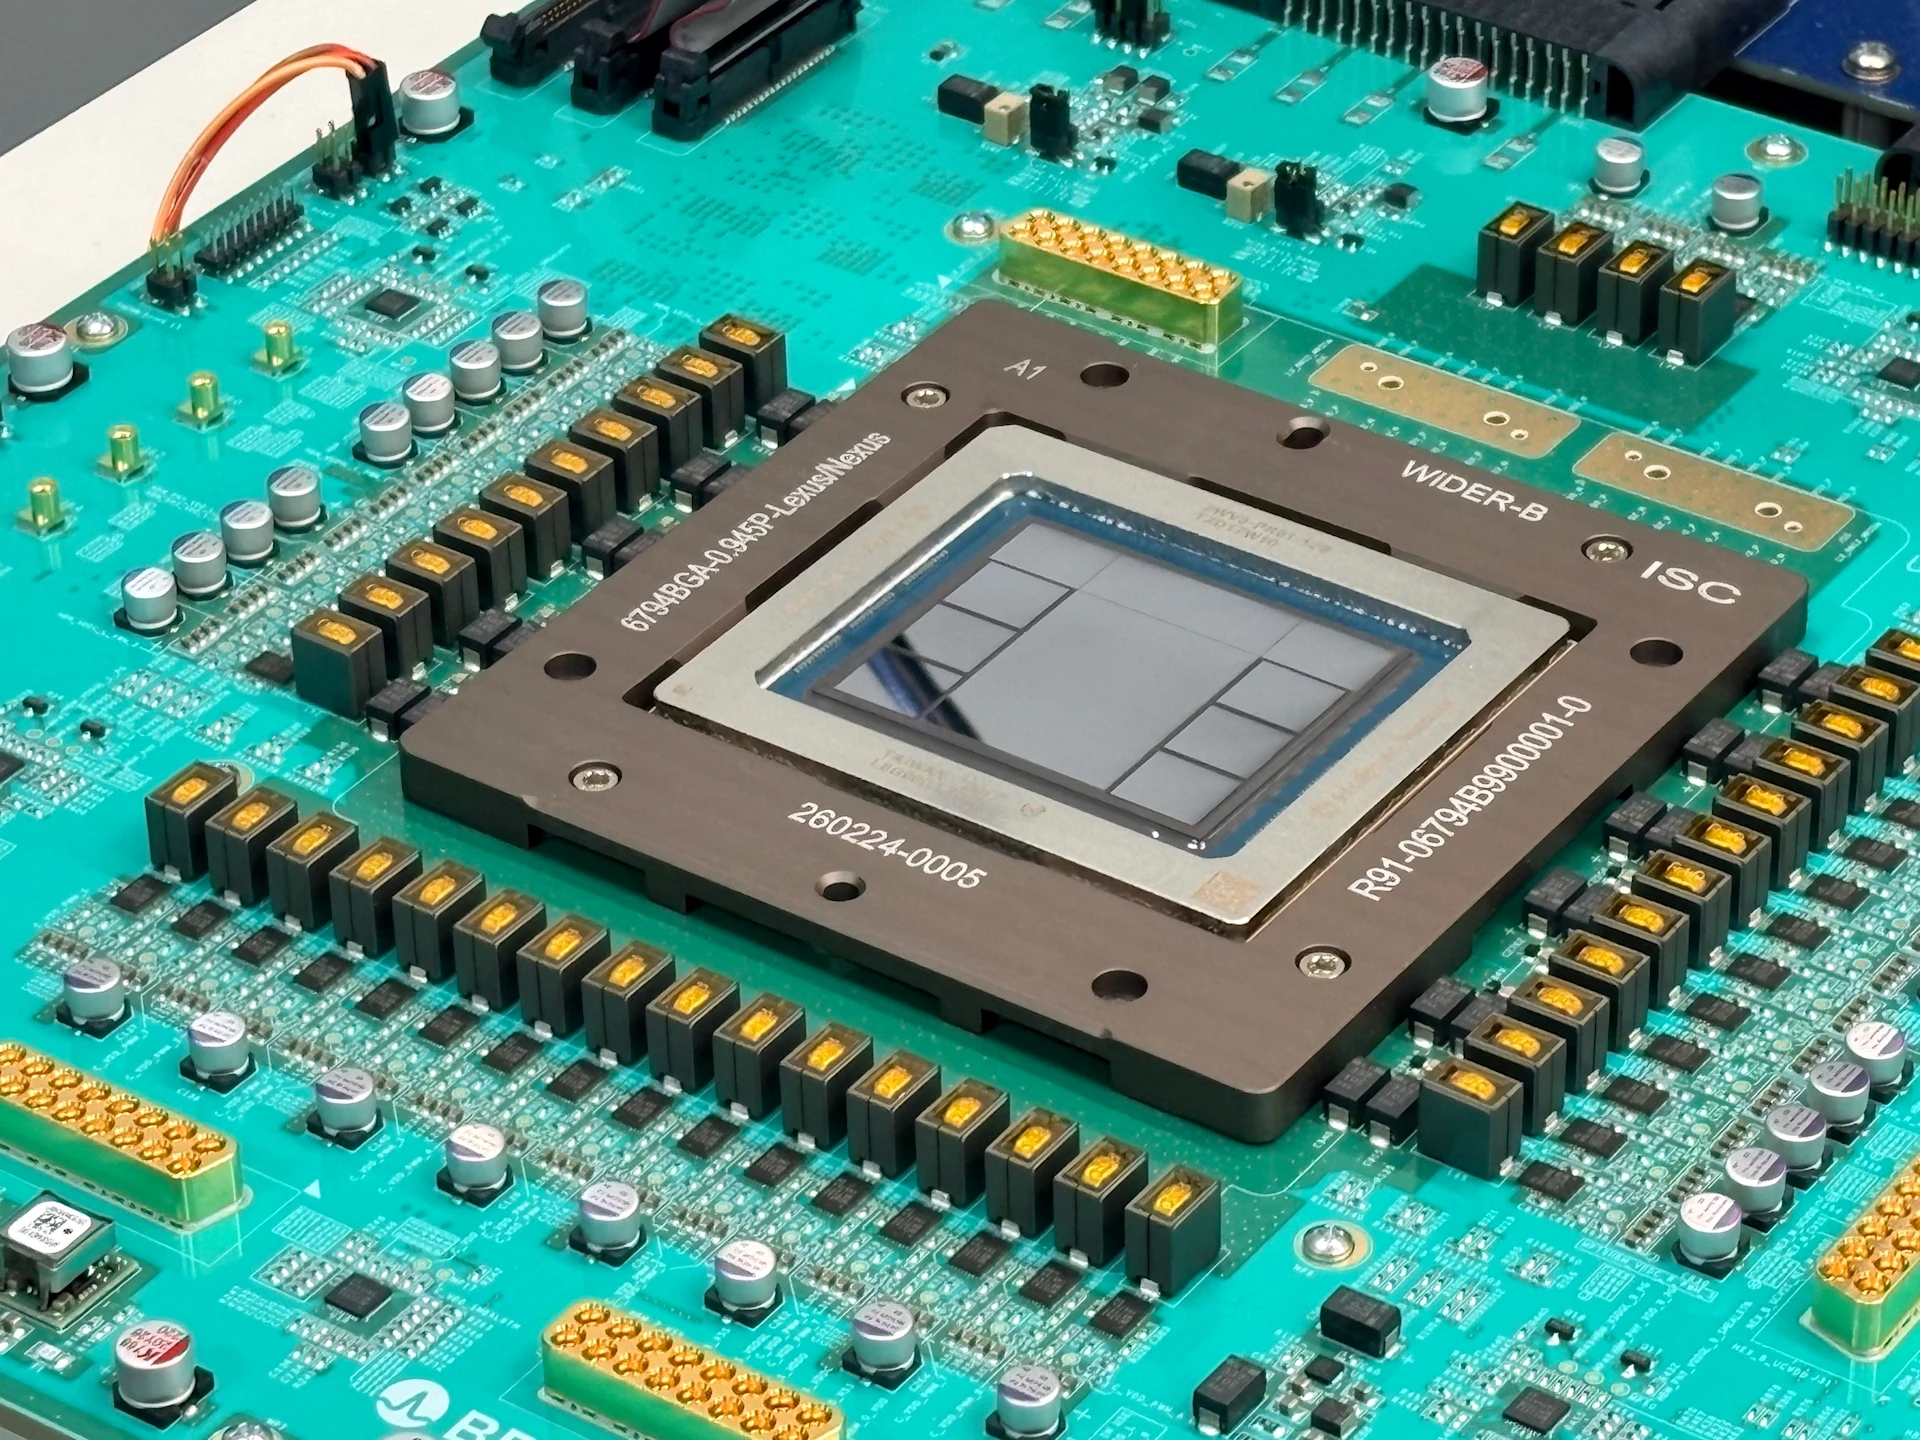
Sementara Helion dan Maia 300 mengubah lanskap data center, Ryzen AI Max dan Ryzen AI Max PRO 400 Series menggeser garis depan AI ke PC kantor. Sistem berbasis chip ini dirancang khusus untuk menjalankan beban kerja AI agentik secara lokal di PC perusahaan, memperluas jangkauan komputasi AI lokal untuk segmen bisnis. Langkah ini menjawab tekanan sejak AI generatif meledak pada akhir 2022, ketika perusahaan dipaksa menjelaskan kasus penggunaan, adopsi, dan ROI AI di level praktis.
Ryzen AI Max 400 mengandalkan hingga 16 core CPU "Zen 5", NPU 55 TOPS, dan 40 unit komputasi GPU yang berbagi kumpulan memori DRAM terpadu berkapasitas besar. Generasi baru ini meningkatkan memori total maksimum dari 128GB menjadi 192GB, dengan alokasi GPU yang naik dari 96GB menjadi hingga 160GB, atau 1,67 kali lebih besar. AMD mengklaim Ryzen AI Max PRO 400 sebagai prosesor klien x86 pertama yang mampu menjalankan model lebih dari 300 miliar parameter pada kuantisasi 4-bit tanpa perlu mengalihkan pemrosesan ke cloud. Eksekusi lokal memberi organisasi kendali lebih besar atas lokasi pemrosesan data sensitif, sekaligus mengurangi ketergantungan pada layanan inferensi eksternal dan koneksi jaringan yang tidak selalu stabil.
Strategi Keluar dari Ketergantungan GPU Proprietary: Apa Artinya bagi Enterprise
Benang merah dari Helion, Maia 300, dan Ryzen AI Max 400 adalah keinginan kuat untuk mengurangi ketergantungan pada solusi GPU proprietary. Di sisi cloud, Microsoft memindahkan beban inferensi ke silikon internal agar membayar lebih dekat ke biaya manufaktur, bukan margin vendor eksternal. Di sisi on-premise dan endpoint, AMD menawarkan hardware AI acceleration yang bisa disesuaikan, dari rak Helion hingga PC berbasis Ryzen AI Max.
Namun, ini bukan revolusi yang memutus hubungan sepenuhnya. Microsoft tetap mempertahankan Nvidia dan AMD untuk pelatihan model besar, dan menyatakan bahwa kemampuan integrasi vertikal tidak berarti mereka akan mengandalkan chip internal saja. Pendekatan hybrid—lokal dan cloud berdampingan—menjadi pola yang masuk akal bagi enterprise yang ingin menyeimbangkan biaya, kedaulatan data, dan fleksibilitas. Ke depan, perusahaan yang cerdas tidak akan menanyakan “GPU mana yang harus dibeli?”, melainkan “arsitektur mana yang memberi kebebasan memilih antara cloud, rak sendiri, dan inferensi AI lokal di PC tanpa terkunci pada satu vendor”.