
Apa Itu Jalapeno dan Mengapa Penting untuk Inferensi AI
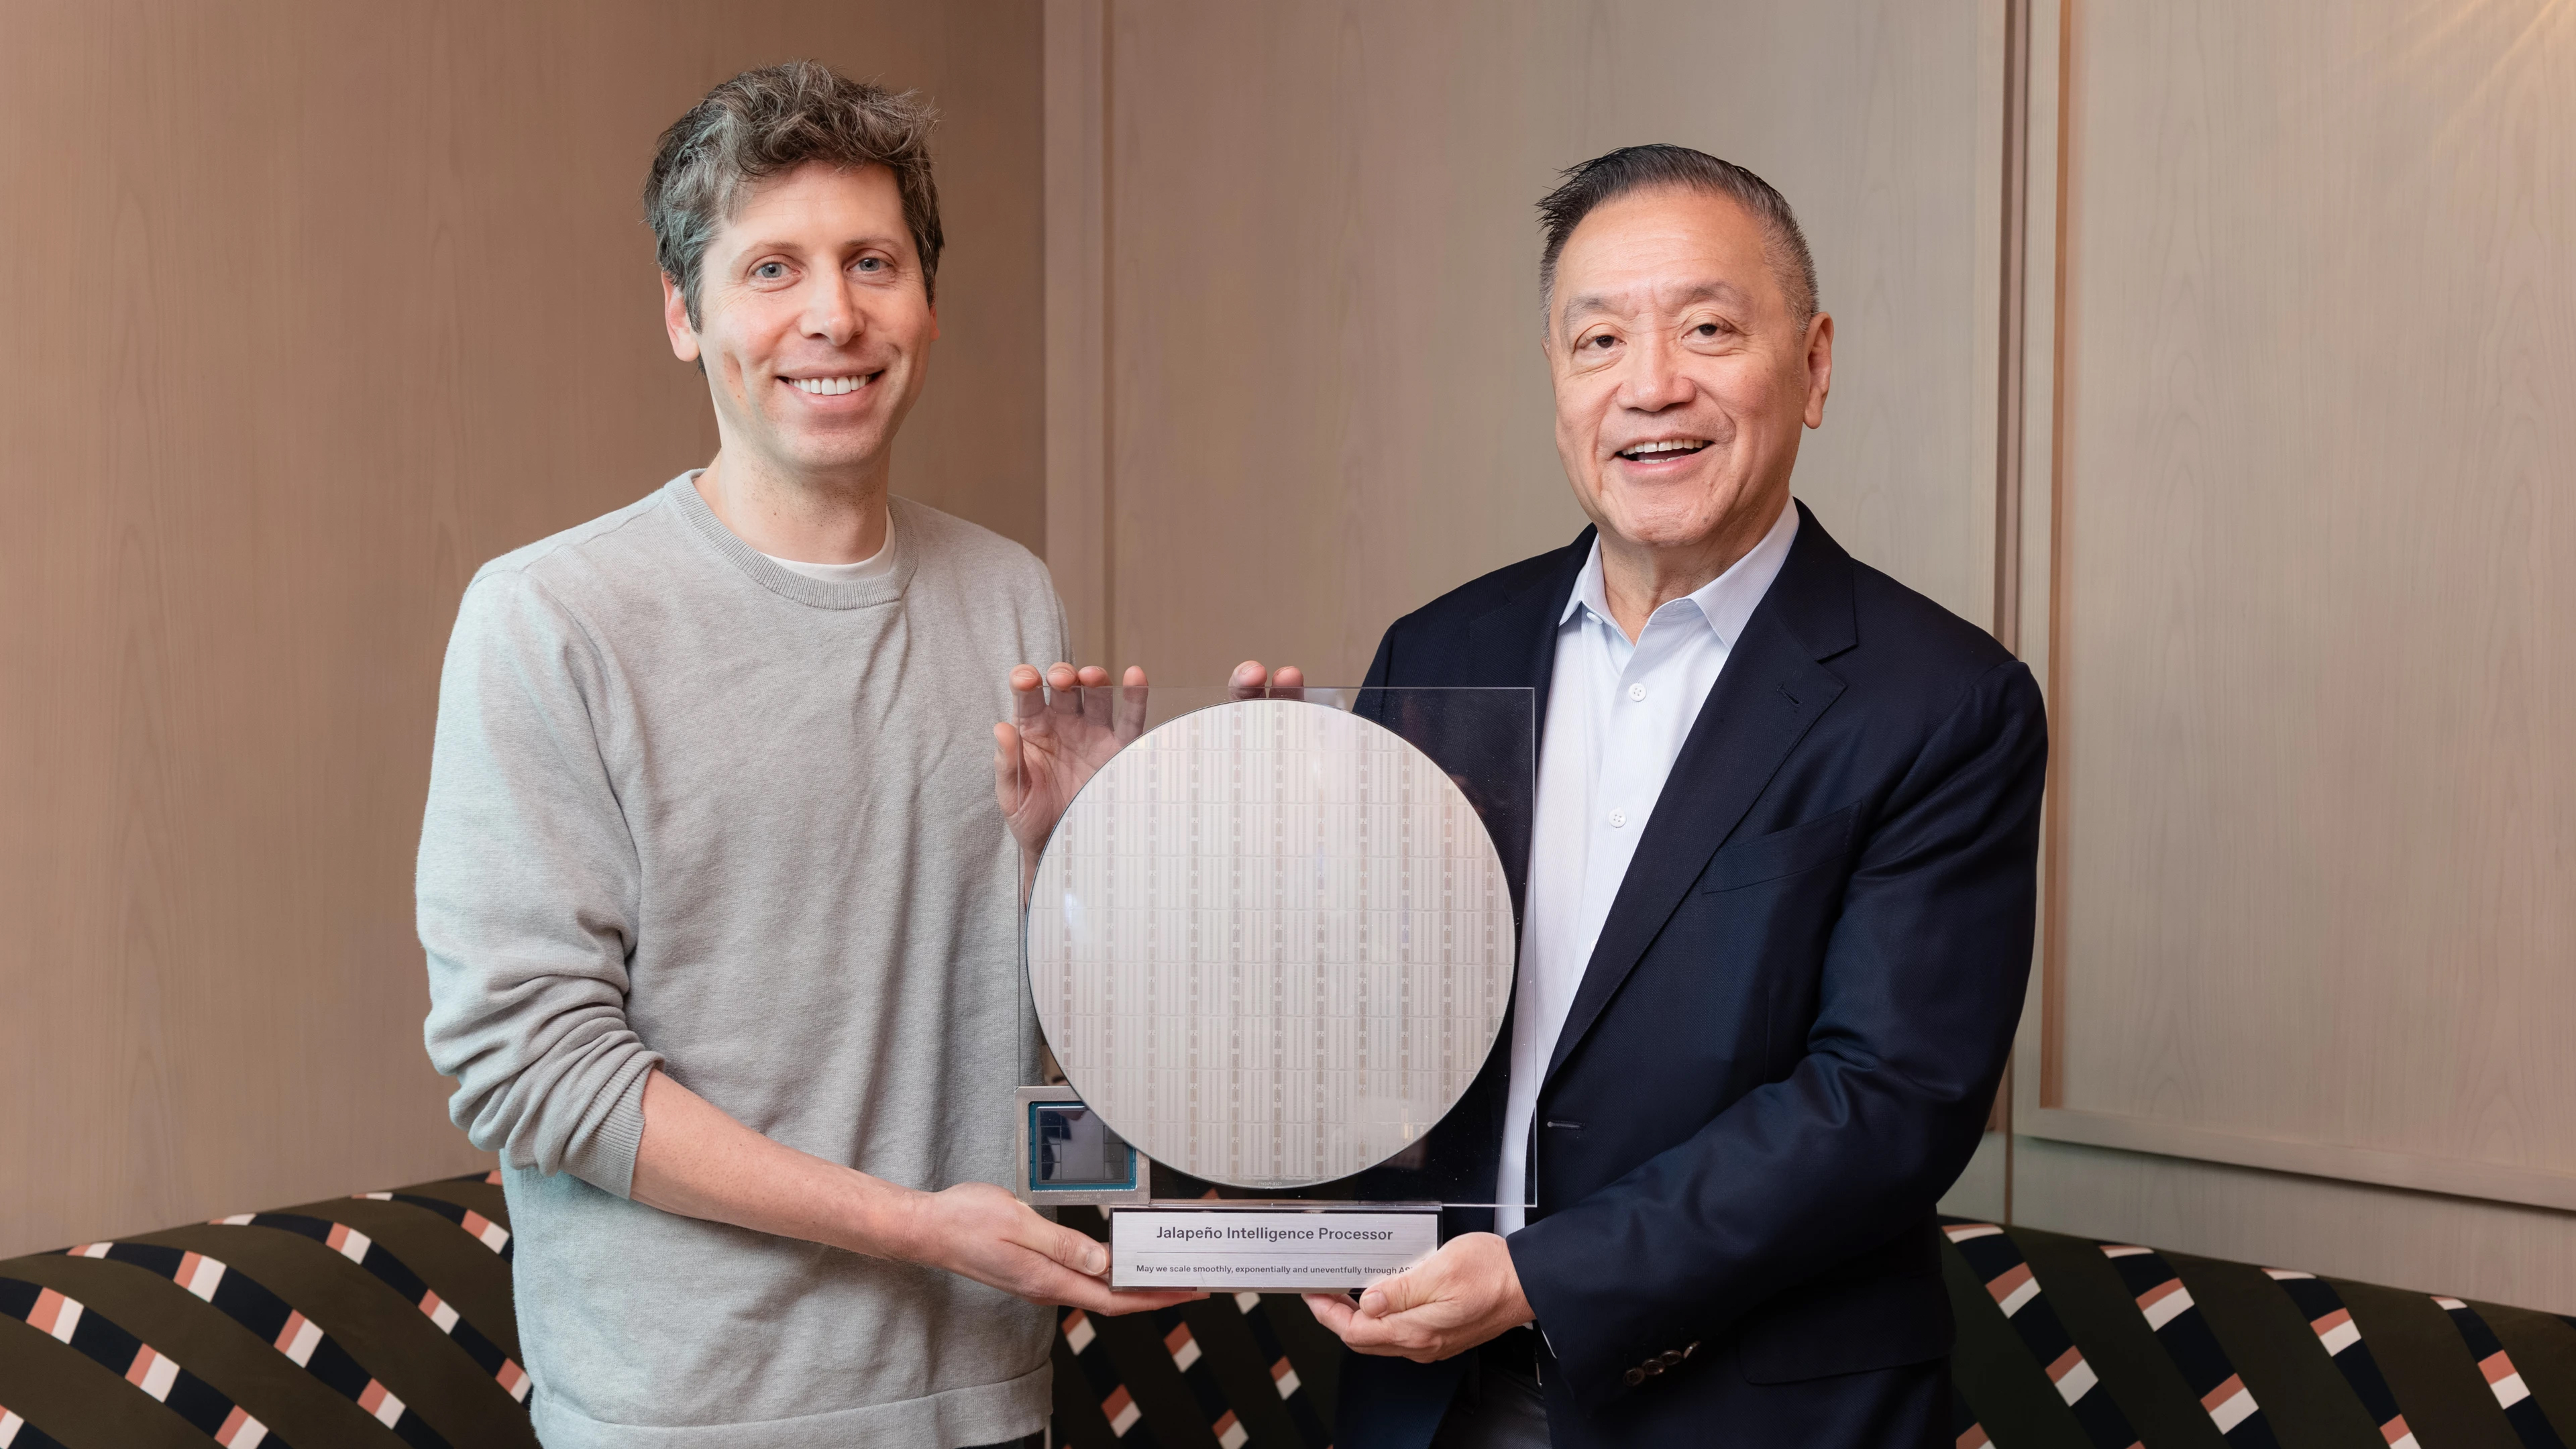
Jalapeno OpenAI adalah chip inferensi AI berbasis ASIC yang dirancang khusus untuk menjalankan model bahasa besar pada tahap inferensi, dengan fokus pada throughput tinggi, latensi rendah, dan efisiensi daya yang melampaui akselerator GPU generik di pusat data modern. Di ajang Hot Chips pada 25 Agustus, OpenAI memamerkan Jalapeno sebagai jawaban strategis terhadap ketergantungan dunia AI pada GPU Nvidia untuk menjalankan model, bukan melatihnya. Ini bukan sekadar produk baru, melainkan pernyataan politik teknis: jika inferensi menyedot sebagian besar biaya operasional, maka chip khusus yang mengoptimalkan bagian ini akan menggeser pusat gravitasi industri. OpenAI dengan terang mengirim pesan bahwa masa depan infrastruktur AI tidak harus mengikuti cetak biru GPU tradisional.
Membedah Klaim Benchmark: Unggul di Efisiensi, Bukan di Segalanya
Di benchmark InferenceX, Jalapeno diklaim menghasilkan throughput per kilowatt 1,5 hingga 1,9 kali lebih tinggi dari sistem rack Nvidia GB200 dan GB300, dengan latensi end‑to‑end 1,7 hingga 3,6 kali lebih rendah pada beragam model besar seperti GPT-OSS 120B, DeepSeek R1 670B, dan Kimi K2.5. Pengujian dilakukan dengan part 700W melawan akselerator Nvidia 1.200W dan 1.400W, dan konsumsi berkelanjutan Jalapeno dilaporkan di sekitar atau di bawah 550W. Dalam konfigurasi rack 128 chip, OpenAI menyebut sistem ini dapat mencapai sekitar 1,7 eksaflops komputasi 4‑bit dengan 27,5 TB HBM4, sambil menekan kebutuhan daya utilitas per akselerator menjadi sekitar 1,18kW versus 2,55kW di GB300. “Dalam benchmark InferenceX, Jalapeno menunjukkan throughput per kilowatt 1,5–1,9 kali lebih tinggi dibandingkan sistem Nvidia yang diuji,” kata OpenAI.
Desain Spesifik Inferensi: Cara Jalapeno Menekan Latensi
Berbeda dari GPU serbaguna, Jalapeno adalah chip inferensi AI yang dibangun dari awal untuk beban kerja LLM: ChatGPT, Codex, API, dan agen AI. Setiap paket menggabungkan die komputasi dengan enam stack HBM4 berkapasitas total 216 GiB pada bandwidth 15,4 TB/s, memberi sekitar 50% lebih banyak memori per watt dibanding GB300 berbasis HBM3E. Arsitekturnya menarget hambatan utama inferensi, yaitu perpindahan data antara komputasi, memori, jaringan, serta pengelolaan KV cache. Dengan mengunci KV cache secara lokal dan meminimalkan data yang bolak-balik keluar chip, Jalapeno memotong bottleneck di tahap prefill dan komunikasi token, sehingga bisa melayani banyak pengguna sekaligus tanpa lonjakan waktu tunggu. Inilah alasan mengapa keunggulannya paling besar muncul pada titik latensi rendah, bahkan dilaporkan hingga puluhan kali lebih efisien per kilowatt pada mode antar-token tercepat GB300.
Strategi OpenAI: Lepas dari Bayang-Bayang Nvidia dan Krisis HBM
Jalapeno adalah langkah sadar untuk mengurangi ketergantungan pada hardware Nvidia dan menekan biaya operasional inferensi yang terus membengkak seiring pertumbuhan pengguna dan kompleksitas model. Fokus pada inferensi bukan kebetulan; setiap permintaan pengguna berarti pusat data harus menjalankan model penuh, sehingga peningkatan efisiensi langsung menerjemah menjadi penghematan biaya listrik dan kapasitas data center. Di saat yang sama, industri sedang tercekik oleh kelangkaan HBM: pemasok besar dilaporkan sudah menjual kapasitas mereka hingga 2027, sampai-sampai Nvidia dikabarkan menguji konfigurasi Rubin Ultra dengan memori dipangkas menjadi 192GB. Dengan perjanjian penerapan 10GW Jalapeno bersama Broadcom, OpenAI bukan hanya memesan chip custom, tetapi juga merebut porsi signifikan dari pasokan HBM4 yang selama ini didominasi Nvidia. Konsekuensinya, peta kekuatan di pasar akselerator AI bergerak dari “siapa punya GPU terbanyak” menjadi “siapa mengontrol rantai suplai memori canggih”.
Dampak ke Pengguna dan Masa Depan Infrastruktur AI
Bagi pengguna akhir, pertanyaan utamanya sederhana: apakah ChatGPT dan layanan sejenis akan terasa lebih cepat dan lebih murah? Desain Jalapeno yang menggabungkan throughput tinggi dan latensi rendah ditujukan menjaga pengalaman interaktif tetap responsif ketika jumlah permintaan melonjak. Jika OpenAI berhasil menurunkan biaya per inferensi, masuk akal untuk berharap model yang lebih kuat bisa tersedia lebih luas, bukan eksklusif di paket mahal. Di sisi waktu, OpenAI merencanakan penerapan Jalapeno dalam volume kecil di pusat data internal pada akhir tahun ini, dengan produksi massal dan skala penuh ditargetkan pada 2027. Namun, Jalapeno tidak menggantikan peran GPU Nvidia di pelatihan model; Nvidia dan pemain lain masih memimpin di sana. Yang berubah adalah lapisan inferensi: dengan benchmark chip custom seperti ini, standar efisiensi GPU lama tampak kurang memadai, dan industri dipaksa mempercepat balapan chip custom demi menurunkan harga dan memperluas akses infrastruktur AI.